EMNLP 2026 Main|浙大&北大团队提出SPADER:用step-wise GRPO与多样性感知奖励驱动多答案问答长尾探索
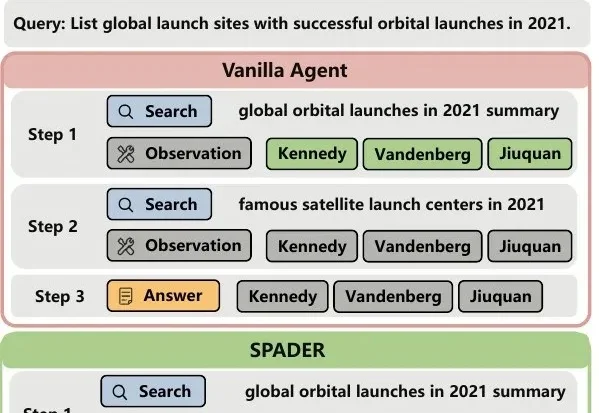
EMNLP 2026 Main|浙大&北大团队提出SPADER:用step-wise GRPO与多样性感知奖励驱动多答案问答长尾探索一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
搜索
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
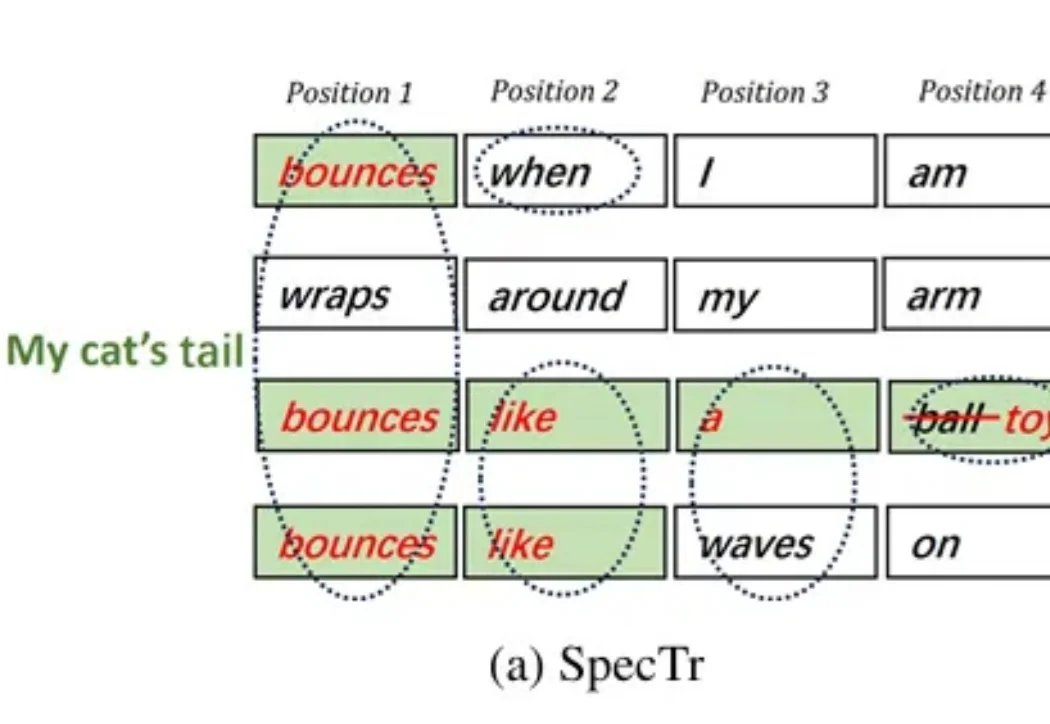
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
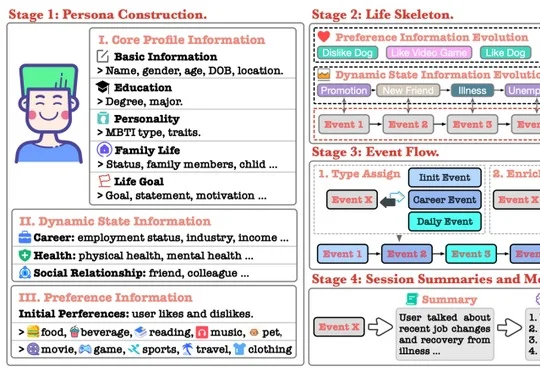
只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
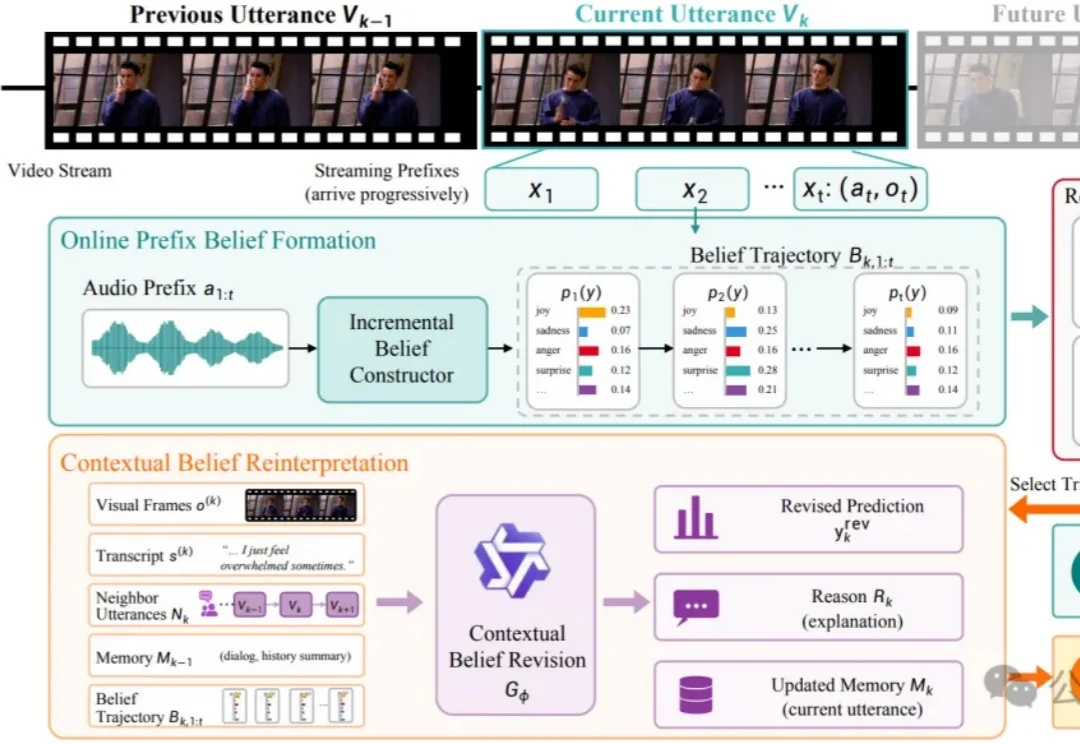
在与用户的实时对话中,AI能否及时感知情绪?模型给出的“高置信度”结论,又是否经得起推敲?
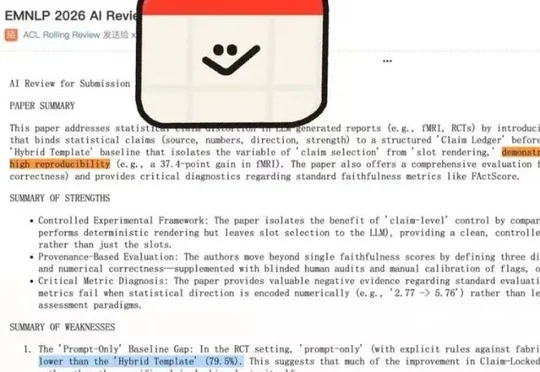
EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。
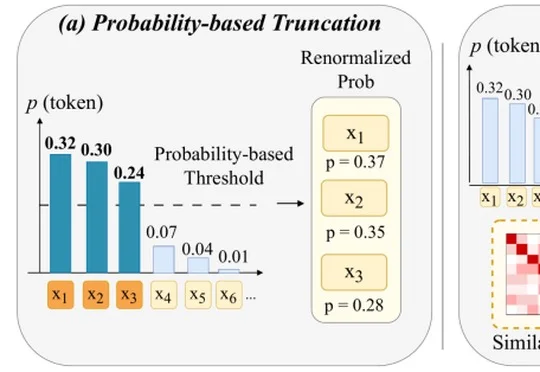
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
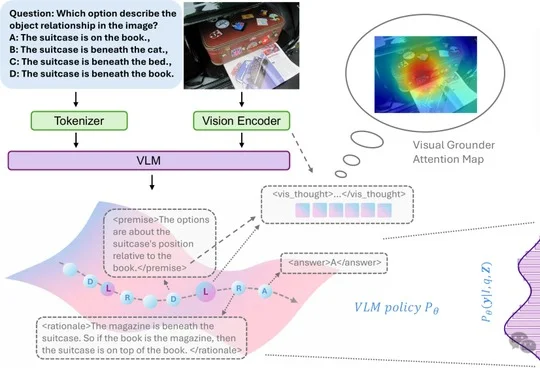
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
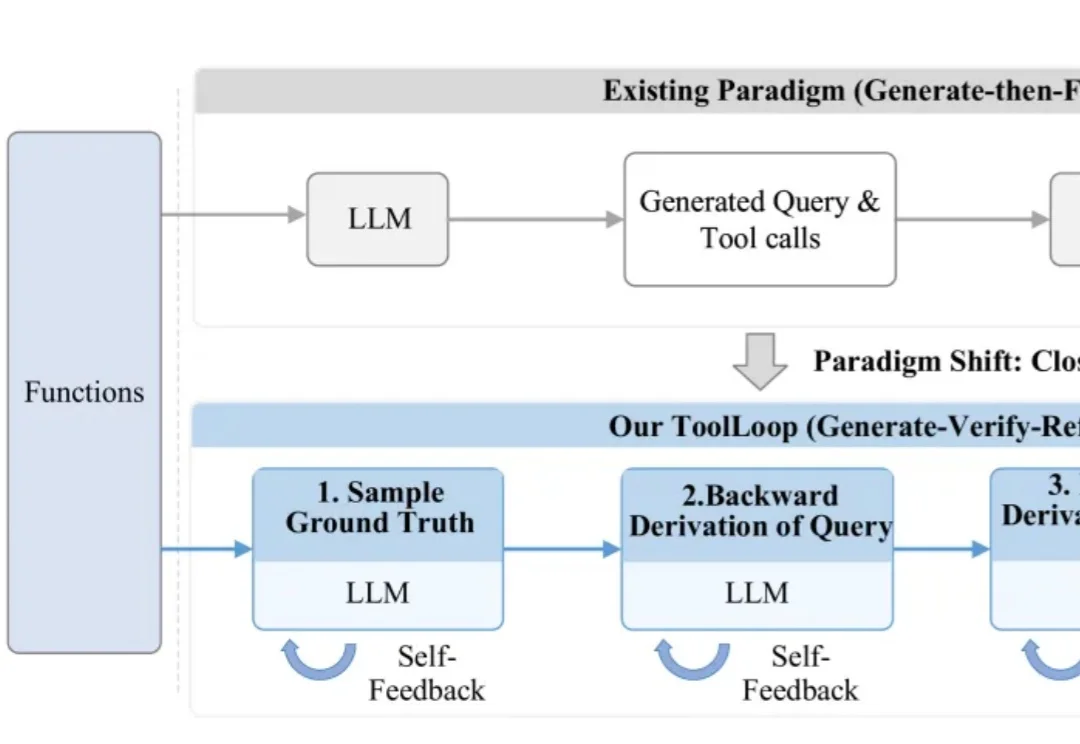
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。