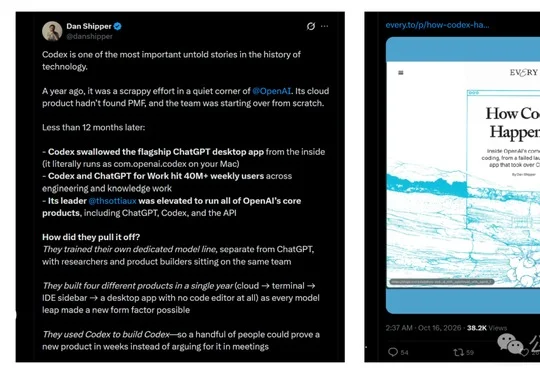
8000字,Codex逆袭ChatGPT抓马史首次大公开!
8000字,Codex逆袭ChatGPT抓马史首次大公开!《How Codex Happened》首次披露Codex从首发遇冷、转向本地Agent并借GPT-5系列突围,最终成为ChatGPT桌面端底座,后续将重回云端并探索无固定界面的主动式Agent。
来自主题: AI资讯
9257 点击 2026-10-18 13:11

 搜索
《How Codex Happened》首次披露Codex从首发遇冷、转向本地Agent并借GPT-5系列突围,最终成为ChatGPT桌面端底座,后续将重回云端并探索无固定界面的主动式Agent。
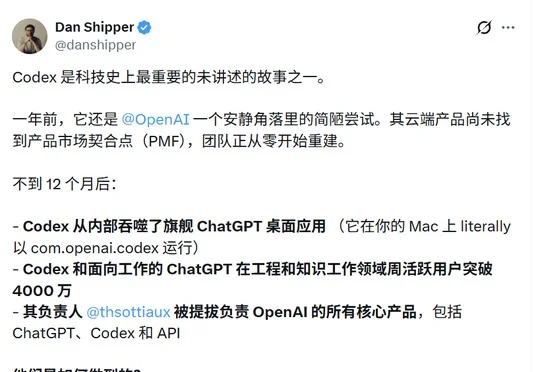
OpenAI的Codex在Tibo接手后从云端转向本地,并推出不含代码编辑器的桌面应用;随着GPT-5.3 Codex拓展至知识工作,Codex于2026年7月成为新版ChatGPT桌面应用,Codex与ChatGPT for Work合计周活超4000万。
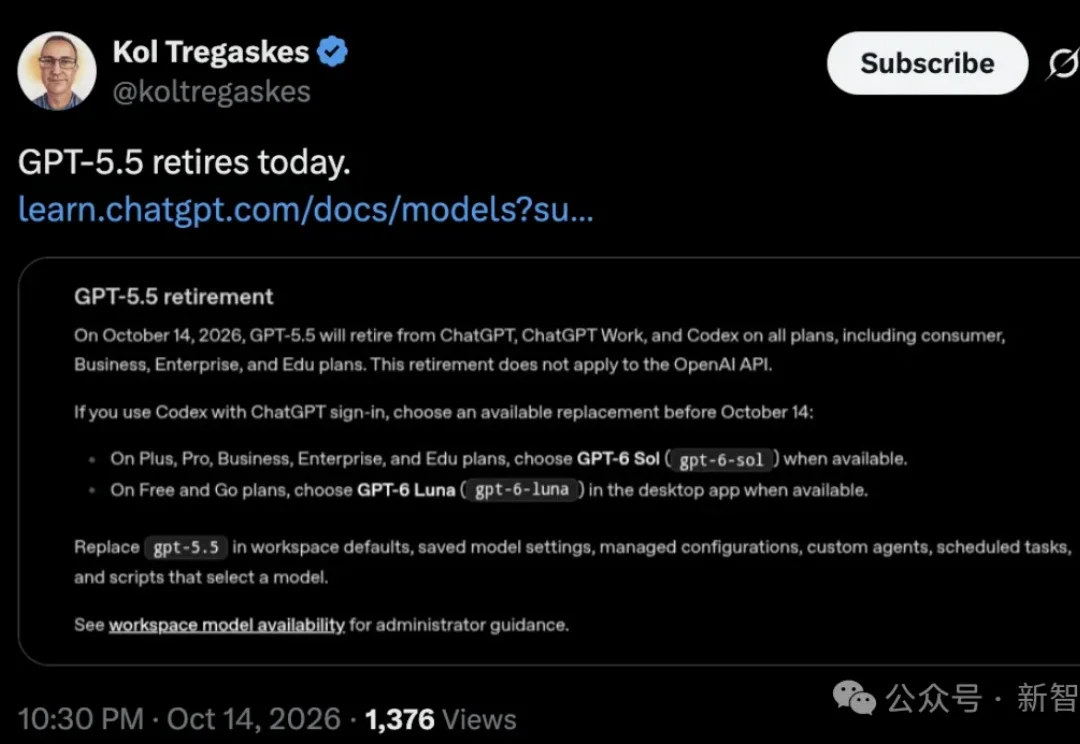
GPT-5.5,正式告别ChatGPT!
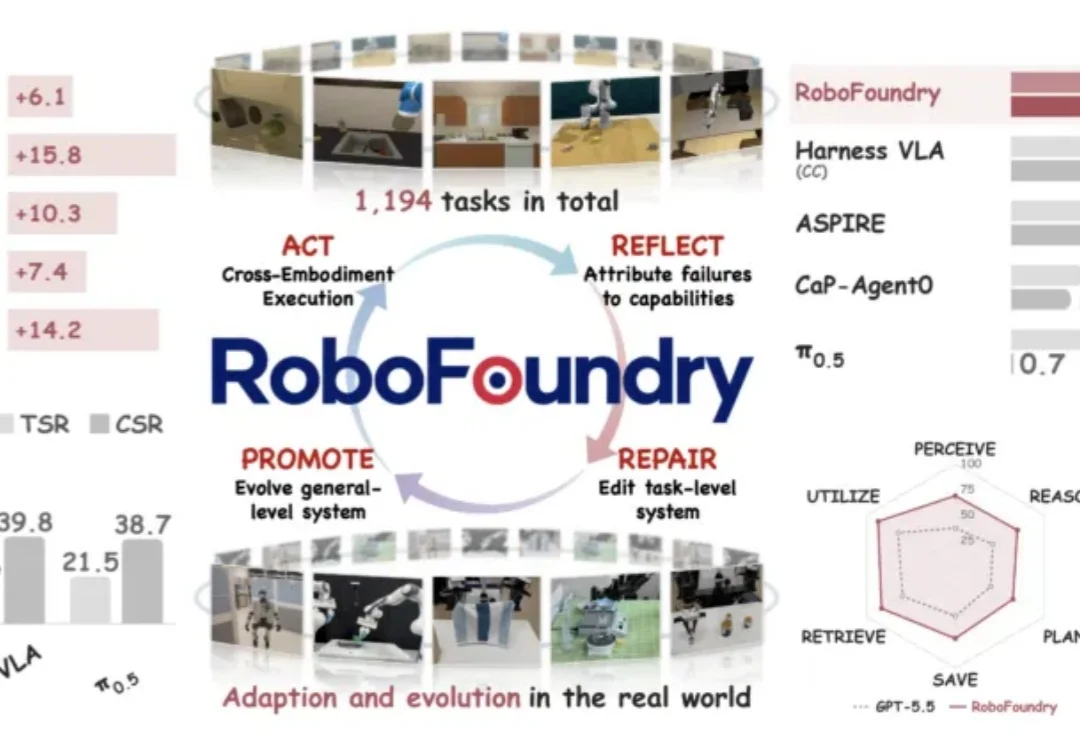
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
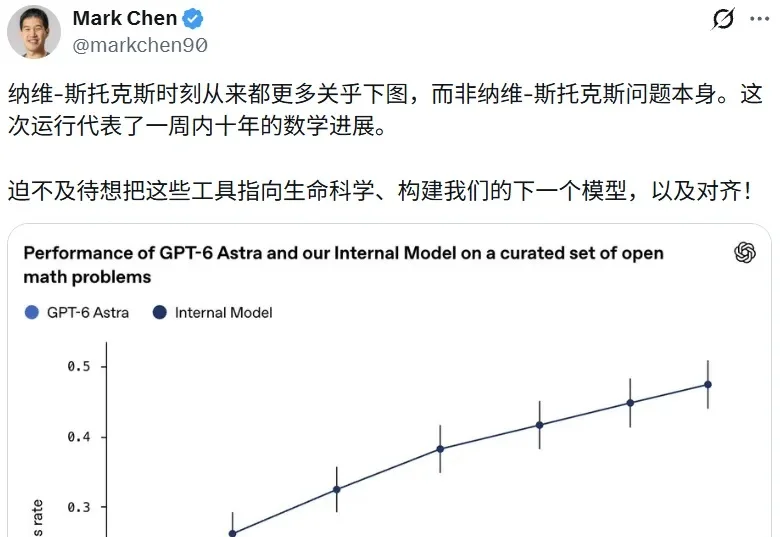
前些时日,OpenAI 在 GitHub 上一口气放出了 722 篇数学论文手稿。这些手稿被归为 372 个结果「家族」,横跨 17 个数学领域,全部出自一个尚未发布、也没有公开名字的内部模型——其性能远胜 GPT-6 Astra。
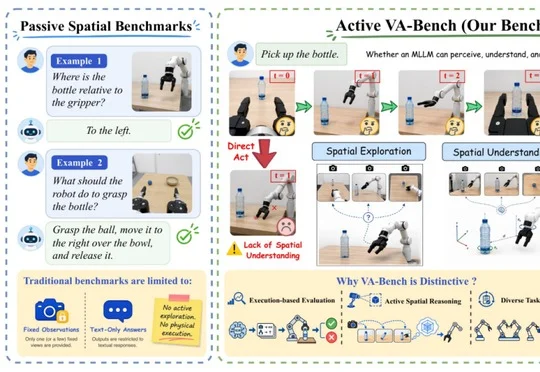
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
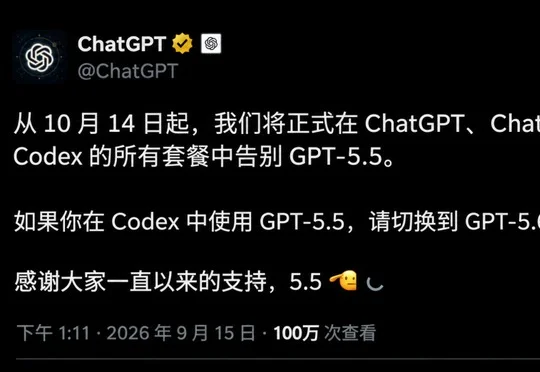
ChatGPT官宣:10月14日起,GPT-5.5将在ChatGPT、ChatGPT Work以及Codex全套餐中彻底下线。 没有缓冲期,没有退路,消费端、企业端、编程端一刀切。 取而代之的,是官方轻描淡写的指路:
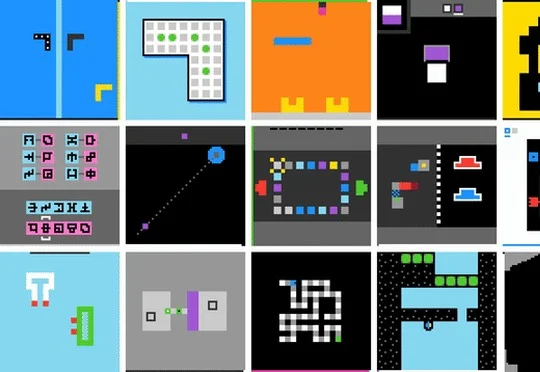
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。
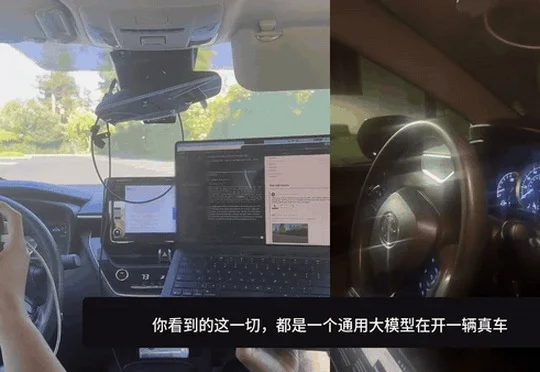
硅谷DrivingBench测试中,从未专门学过开车的通用大模型GPT-6 Astra操控改装丰田卡罗拉以5分22秒通过锥桶摆出的科目二考场,成为全场唯一通关的大模型,而Claude Fable 5.1、Grok 4.6和GPT-5.6 Sol均未通过。
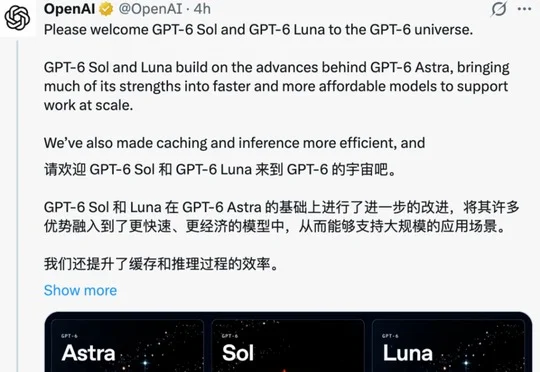
OpenAI同日发布GPT-6 Sol与GPT-6 Luna,API价格相比GPT-5.6腰斩50%,主打单位任务成本优势;Anthropic推出Claude Opus 5.5,典型任务成本降低约40%且输出速度提升超30%,两家厂商围绕"性价比"展开直接竞争。