AI资讯新闻榜单内容搜索-SI

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: SI
Artificial Analysis 重磅发布《2025年Q2中国AI现状报告》:中国与美国差距已从一年缩短至3个月

Artificial Analysis 重磅发布《2025年Q2中国AI现状报告》:中国与美国差距已从一年缩短至3个月

Artificial Analysis 重磅发布《2025年Q2中国AI现状报告》:中国与美国差距已从一年缩短至3个月

Artificial Analysis 最近发布了《State of AI: China Q2 2025 Highlights Report》(2025年Q2 中国人工智能现状分析报告),聚焦中国 AI 发展现状。

来自主题: AI技术研报
13198 点击    2025-08-13 15:57
新加坡的Agent黑马Agnes,双杀技能:Deep Design × Wide Research重新定义智能体?

新加坡的Agent黑马Agnes,双杀技能:Deep Design × Wide Research重新定义智能体?

新加坡的Agent黑马Agnes,双杀技能:Deep Design × Wide Research重新定义智能体?

之前在X上看到过一个新加坡版的DeepSeek,叫Agnes AI,主打一站式Agent空间。 但当时我自己搞产品焦头烂额的,随手点开看了看,就放下了。 后来在Product Hunt上又看到这款产品,以及各种海外平台时而刷到。

来自主题: AI资讯
10328 点击    2025-08-13 12:32
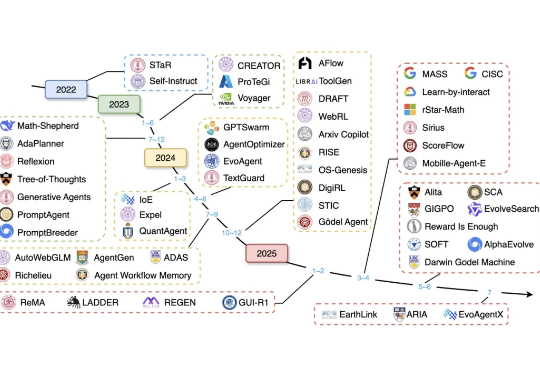
从物竞天择到智能进化,首篇自进化智能体综述的ASI之路

从物竞天择到智能进化,首篇自进化智能体综述的ASI之路

从物竞天择到智能进化,首篇自进化智能体综述的ASI之路

近年来,大语言模型(LLM)已展现出卓越的通用能力,但其核心仍是静态的。面对日新月异的任务、知识领域和交互环境,模型无法实时调整其内部参数,这一根本性瓶颈日益凸显。

来自主题: AI技术研报
9064 点击    2025-08-13 11:32
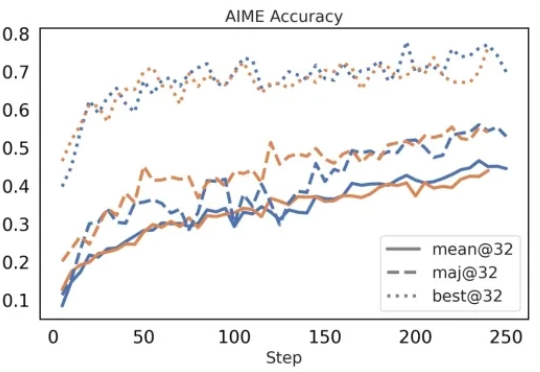
让强化学习快如闪电:FlashRL一条命令实现极速Rollout,已全部开源

让强化学习快如闪电:FlashRL一条命令实现极速Rollout,已全部开源

让强化学习快如闪电:FlashRL一条命令实现极速Rollout,已全部开源

在今年三月份,清华 AIR 和字节联合 SIA Lab 发布了 DAPO,即 Decoupled Clip and Dynamic sAmpling Policy Optimization(解耦剪辑和动态采样策略优化)。

来自主题: AI技术研报
9648 点击    2025-08-13 11:27
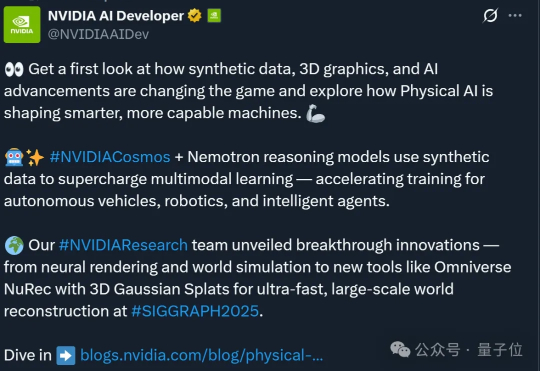
英伟达为机器人推出懂推理的“大脑”!升级版Cosmos世界模型来了

英伟达为机器人推出懂推理的“大脑”!升级版Cosmos世界模型来了

英伟达为机器人推出懂推理的“大脑”!升级版Cosmos世界模型来了

老黄看好机器人,还真不是嘴上说说! 这不,就在正在举办的SIGGRAPH(计算机图形学)大会上,英伟达为机器人带来了全新升级的Cosmos世界模型。

来自主题: AI资讯
8458 点击    2025-08-13 10:14
苹果 AI 下半场:年底问世的新 Siri,要彻底改变 iPhone 的交互

苹果 AI 下半场:年底问世的新 Siri,要彻底改变 iPhone 的交互

苹果 AI 下半场:年底问世的新 Siri,要彻底改变 iPhone 的交互

从上周开始,我们就开始看到一些关于苹果在人工智能领域的长期规划开始浮出水面:从名为 AKI、力求在 iPhone 端侧打造「类 ChatGPT 搜索体验」的答案引擎,到本周目标指向 AI Agent 能力的「新 Siri」概念爆出。无数消息都指向了一个目标:「重生」。

来自主题: AI资讯
9137 点击    2025-08-12 16:44
2025全球大模型应用报告:红海混战「忠诚度」瓦解,用户脚踏4.7条船!

2025全球大模型应用报告:红海混战「忠诚度」瓦解,用户脚踏4.7条船!

2025全球大模型应用报告:红海混战「忠诚度」瓦解,用户脚踏4.7条船!

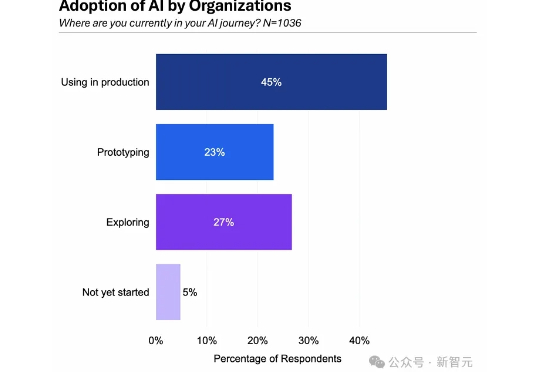
想知道全球各大企业对大模型是如何使用的大模型的,今年和去年有哪些不同,请看Artificial Analysis发布的2025年第一季度AI应用报告,把握AI发展的潮流趋势。

来自主题: AI资讯
10680 点击    2025-08-12 12:32
Attention Sink产生的起点?清华&美团首次揭秘MoE LLM中的超级专家机制

Attention Sink产生的起点?清华&美团首次揭秘MoE LLM中的超级专家机制

Attention Sink产生的起点?清华&美团首次揭秘MoE LLM中的超级专家机制

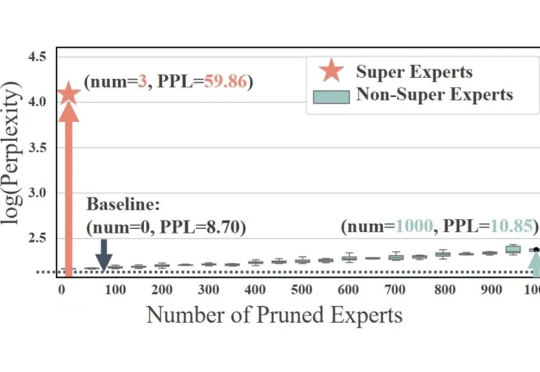
稀疏激活的混合专家模型(MoE)通过动态路由和稀疏激活机制,极大提升了大语言模型(LLM)的学习能力,展现出显著的潜力。基于这一架构,涌现出了如 DeepSeek、Qwen 等先进的 MoE LLM。

来自主题: AI技术研报
10231 点击    2025-08-12 11:07
联合理解生成的关键拼图?腾讯发布X-Omni:强化学习让离散自回归生成方法重焕生机,轻松渲染长文本图像

联合理解生成的关键拼图?腾讯发布X-Omni:强化学习让离散自回归生成方法重焕生机,轻松渲染长文本图像

联合理解生成的关键拼图?腾讯发布X-Omni:强化学习让离散自回归生成方法重焕生机,轻松渲染长文本图像

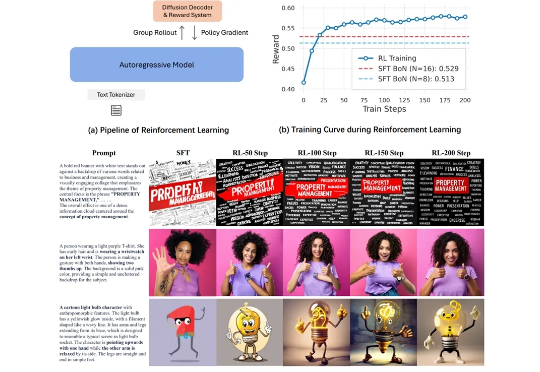
在图像生成领域,自回归(Autoregressive, AR)模型与扩散(Diffusion)模型之间的技术路线之争始终未曾停歇。大语言模型(LLM)凭借其基于「预测下一个词元」的优雅范式,已在文本生成领域奠定了不可撼动的地位。

来自主题: AI技术研报
8397 点击    2025-08-11 10:17
扩散LLM推理新范式:打破生成长度限制,实现动态自适应调节

扩散LLM推理新范式:打破生成长度限制,实现动态自适应调节

扩散LLM推理新范式:打破生成长度限制,实现动态自适应调节

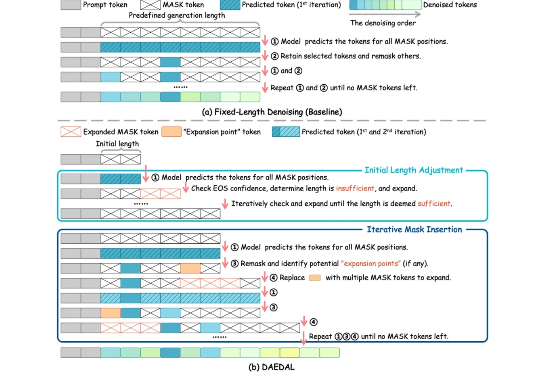
随着 Gemini-Diffusion,Seed-Diffusion 等扩散大语言模型(DLLM)的发布,这一领域成为了工业界和学术界的热门方向。但是,当前 DLLM 存在着在推理时必须采用预设固定长度的限制,对于不同任务都需要专门调整才能达到最优效果。

来自主题: AI资讯
9242 点击    2025-08-09 11:16