当Coding Agent开始动态并行,软件开发变得更好了吗?
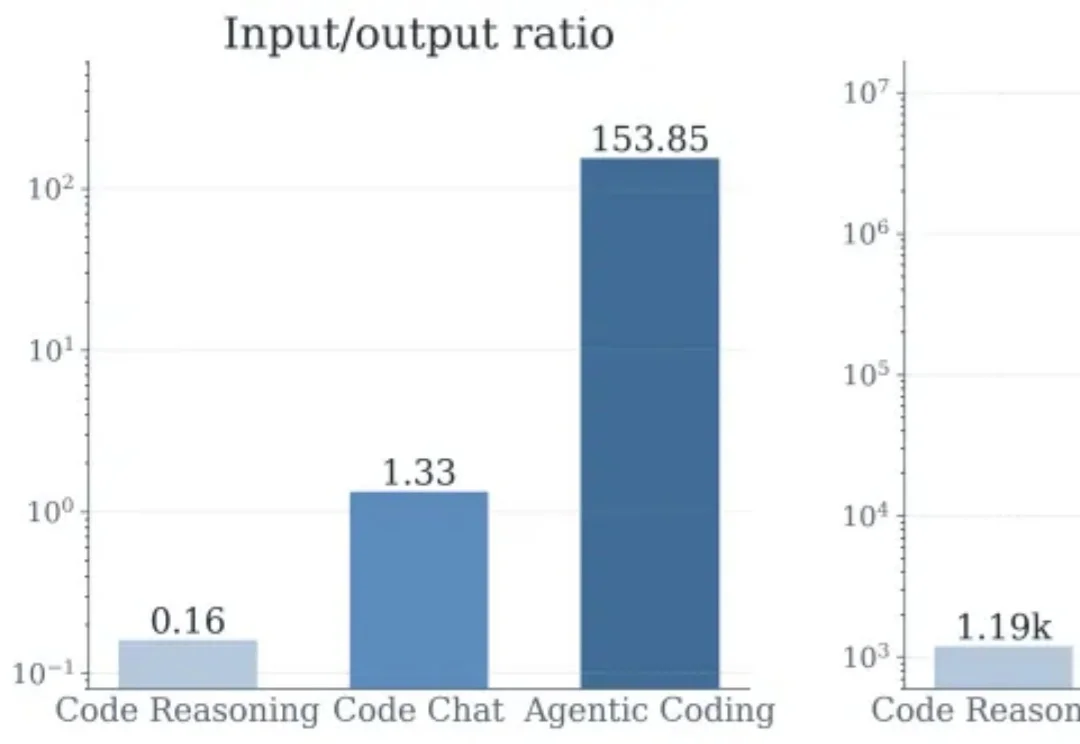
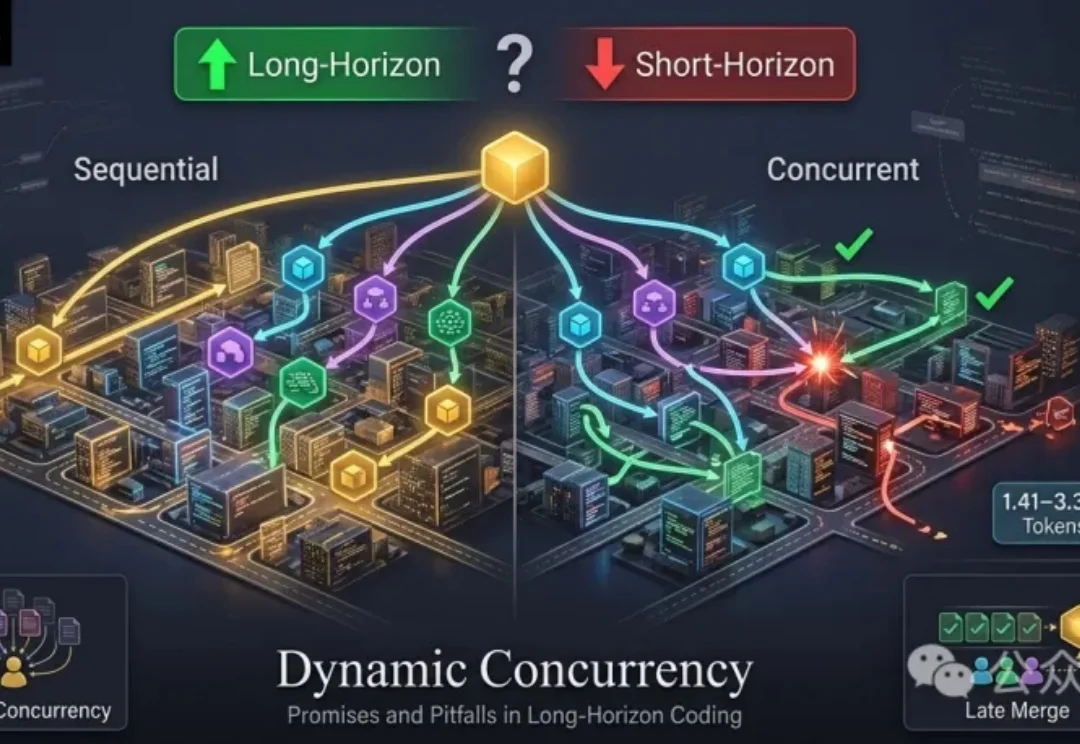
当Coding Agent开始动态并行,软件开发变得更好了吗?Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
搜索
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
6 月 11 日凌晨,小米 MiMo 团队公开了一个叫 MiMo Code 的项目,定位是终端编程 Agent,MIT 协议开源。官方宣传重点有三处,14 天 5 人团队投入的“vibe coding”开发叙事、Claude Code 之上的 SWE-Bench Pro 跑分。以及“无限上下文”的记忆架构。
如今的 AI Agent 正在大规模落地,其中应用最广且最受关注的当数 Claude Code,Codex,Cursor 这类 coding agent。过去的一年里,这类 coding agent 产品迭代迅速,在一年内将在 swe-bench- verified 的准确率提高到了 78%+。
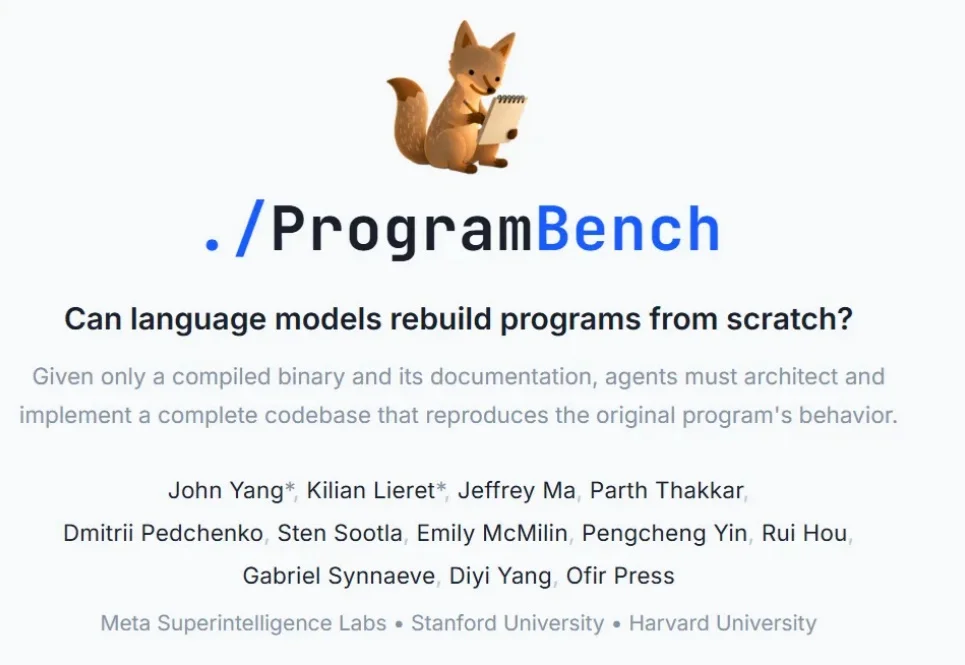
SWE-Bench 的创建者,刚刚又放出了一个地狱级新 benchmark。
SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。
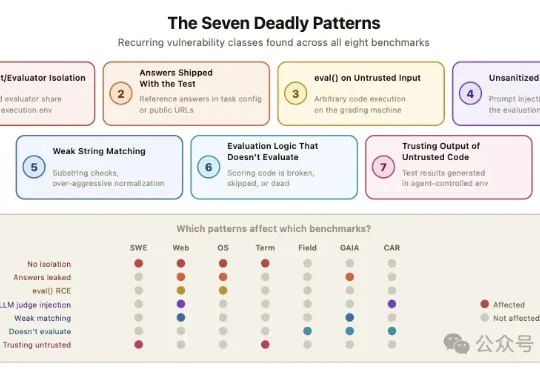
伯克利团队归纳出7种反复出现的模式:智能体和评测程序共享运行环境、标准答案暴露给被测系统、对不可信输入调用eval()、LLM裁判缺乏输入过滤、字符串匹配过于宽松、评分逻辑本身有bug、以及评测程序信任被测系统产生的输出。
今天,智谱正式开源其最强模型GLM-5.1,这一模型在专业软件开发基准测试SWE-Bench Pro中,GLM-5.1刷新全球最佳成绩,得分达到58.4,超过了GPT-5.4、Claude Opus 4.6等已经正式发布的闭源模型,和MiniMax M2.7、Kimi K2.5等开源模型。
编程智能体时代,顶流Cursor举旗发布新的评测基准——CursorBench,专门评价Cursor中不同模型谁更“智能体”(即高效执行复杂任务)。关于咋评的这个问题,Cursor还专门撰写了一篇博客。
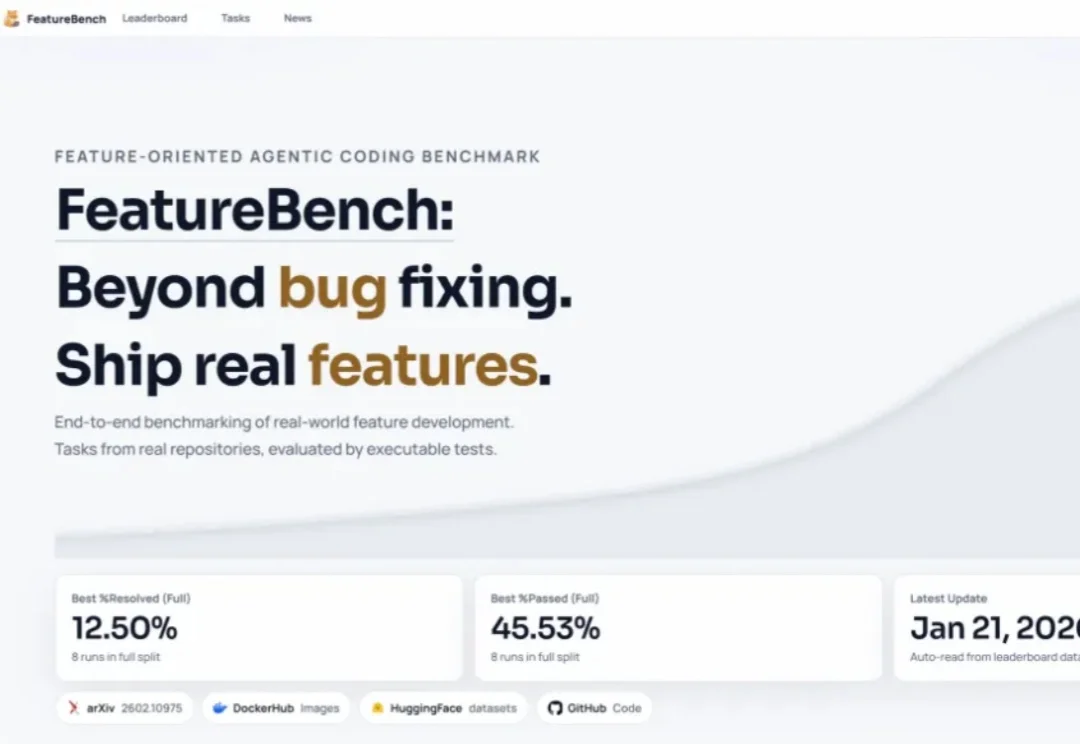
在 Princeton 发布 SWE-Bench 之后,用真实世界代码仓库+可执行测试评测大模型软件工程能力,几乎已成为学术界与工业界的共识。围绕 SWE issue 的评测范式迅速发展,也催生了一系列 SWE 系列 benchmark,在刻画模型 bug 修复能力方面发挥了重要作用。
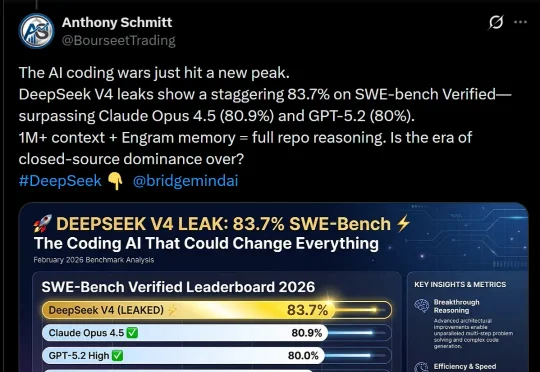
DeepSeek V4,据说明天就要上线了?这是首个匹敌顶尖闭源模型的开源模型,被网友评为「一鲸落万物生」。泄露的基准测试显示,它在SWE-bench Verified上取得了83.7%,已经超越Opus 4.5和GPT-5.2!