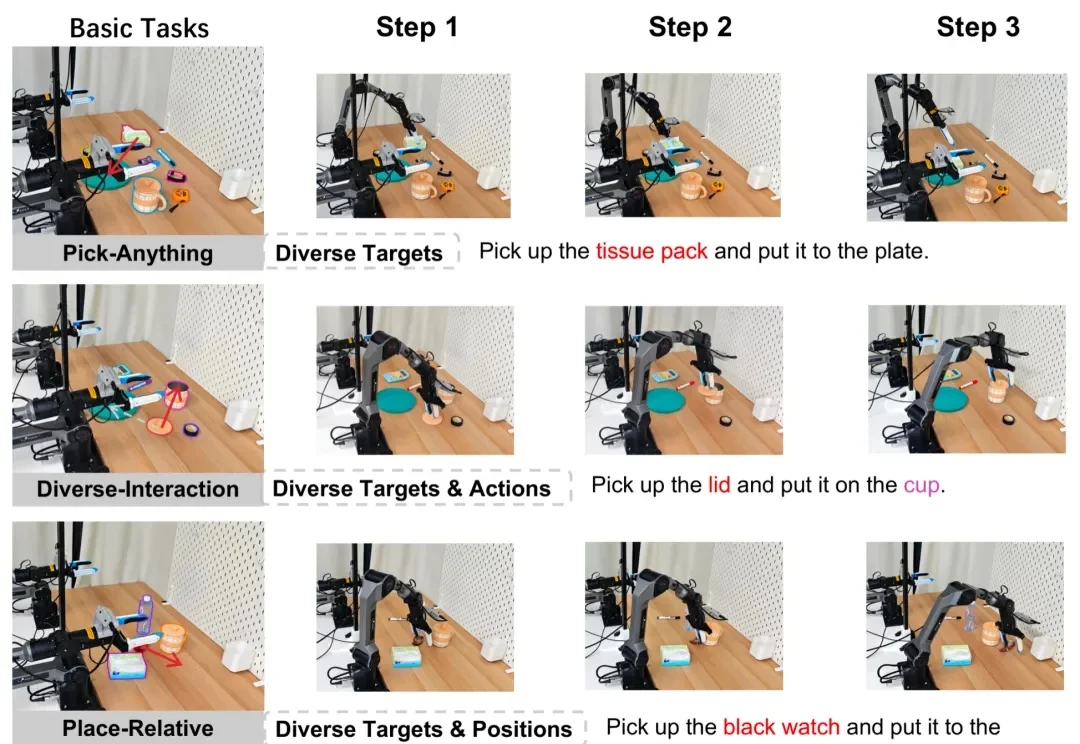
揭示人机联合训练Scaling趋势!欧拉万象联手港科广开源具身UniWAM
揭示人机联合训练Scaling趋势!欧拉万象联手港科广开源具身UniWAMOla-Sem 正式开源版本来了!UniWAM 探索 Human-Robot Co-training 的 Scaling 趋势,实现世界理解、未来预测与动作生成的统一学习,代码与权重全面开源。
来自主题: AI技术研报
7785 点击 2026-10-13 14:23

 搜索
Ola-Sem 正式开源版本来了!UniWAM 探索 Human-Robot Co-training 的 Scaling 趋势,实现世界理解、未来预测与动作生成的统一学习,代码与权重全面开源。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
几个小时前,Barret Zoph 在 𝕏 上发了一条推文,他说自己将加入谷歌 DeepMind,而他的 AI 生涯正是从谷歌 Brain 的 Residency 项目起步的,这次算是重返旧地;他将专注于强化学习(RL)与后训练(Post-Training)方向,更多消息稍后公布;他还补了一句,谷歌拥有在 AI 领域持续成功所需要的全部要素,他很高兴能成为这个使命的一部分。
就在刚刚,X上网友「三只草莓」爆料,SSI正在探索一种基于TTT(Test-Time Training,测试时训练)的小型推理引擎。 据其描述,这个模型会用专门整理的数据学习「如何学习」,再在解决问题的过程中更新部分权重。
近期,SemiAnalysis 创始人 Dylan Patel 先后做客红杉资本的《Training Data[1]》和 WisdomTree 的《The Next Big Thing[2]》。两期访谈从模型和芯片,一路延伸至内存、能源、数据中心与 AI 商业模式,并指向同一个变化:AI 竞赛的焦点,正从单纯比较模型能力,扩展到谁能以更低成本、更大规模,把模型能力稳定地交付出来。
来自至知创新研究院(IQuest Research)、中国人民大学高瓴人工智能学院、KAUST等机构的研究团队提出了FORT,一个面向Deep Search Agent的shortcut-resistant training-data synthesis framework。
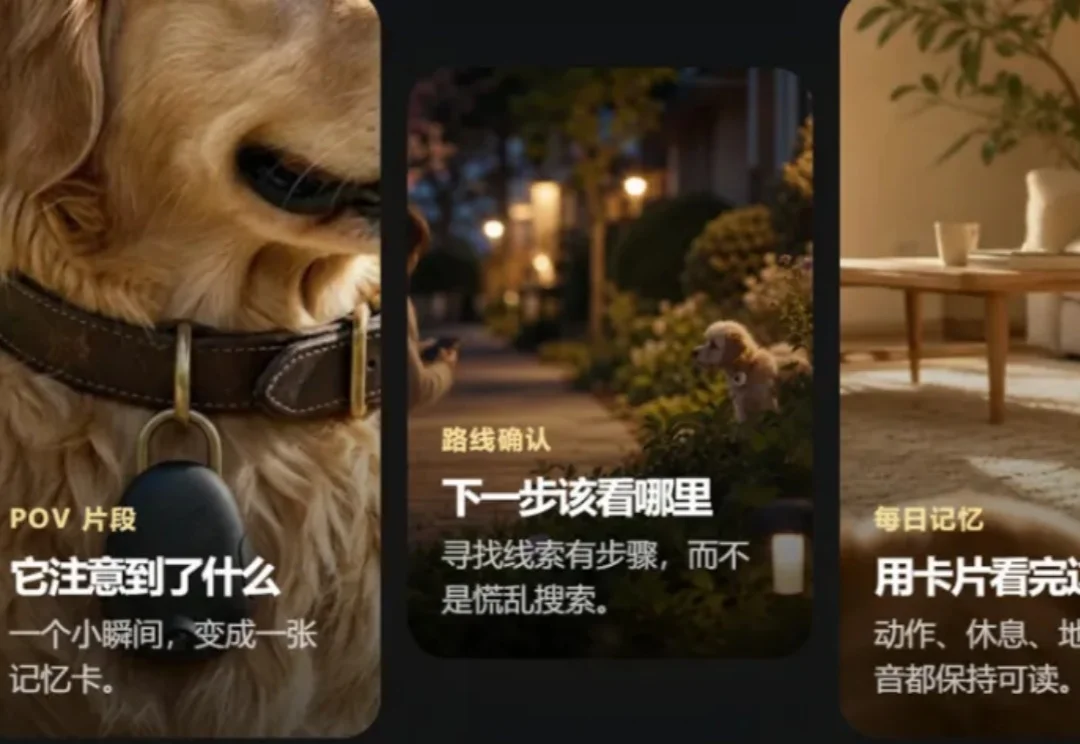
海内外资本正在同步加码AI宠物硬件。AI情绪翻译项圈Traini斩获英伟达、谷歌、Meta等高管的投资,国内的MOVA、Pettichat、PurrPurr、SATELLAI、Loona今年也接连吸金。
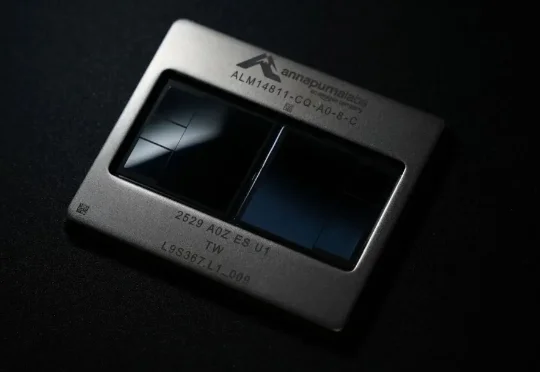
亚马逊于 2020 年推出的 AI 加速芯片 Trainium 已赢得包括 OpenAI、Anthropic 及优步科技在内的数家重量级客户,这些企业均通过亚马逊云服务使用该硬件。亚马逊表示,该芯片已带来超过 2250 亿美元的收入承诺。
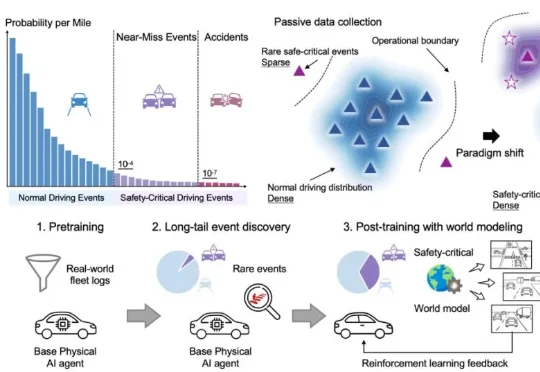
香港大学李弘扬团队联合华为、上海创智学院及清华大学李升波教授团队,发表的最新论文World Engine: Towards the Era of Post-Training for Autonomous Driving给出了系统回答。
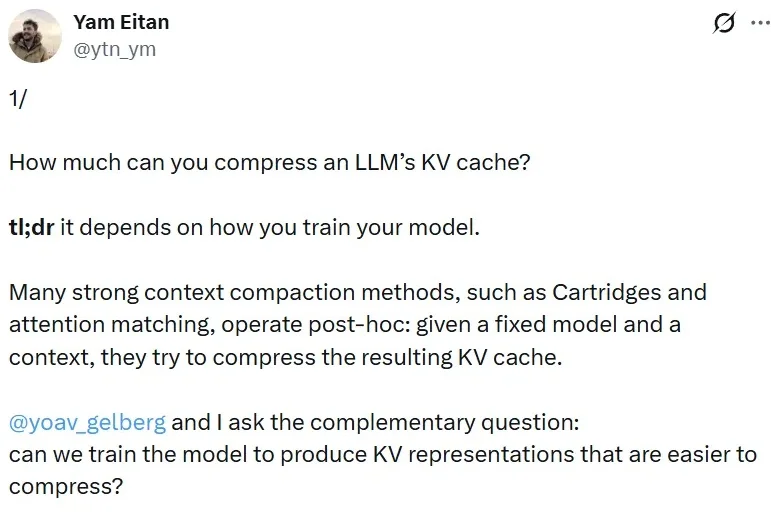
2026 年初,各大 AI 厂商在上下文窗口长度上展开激烈角逐。Google 的 Gemini 3 Pro 已支持 100 万级 token 上下文,Meta 的 Llama 4 Scout 更宣称可处理 1000 万 token。GPT-5 系列也在快速推进长上下文能力。