VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据
VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
来自主题: AI技术研报
7958 点击 2026-10-20 16:22

 搜索
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
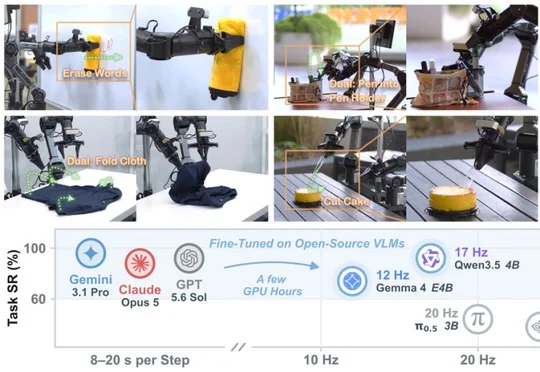
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。

字节Seed团队推出Seed-Evolving第五版更新,通过统一Model ID实现周级自动迭代,在Coding Agent长程任务完成度和VLM视觉理解能力上均有显著提升,用户一次接入即可享受模型持续进化。
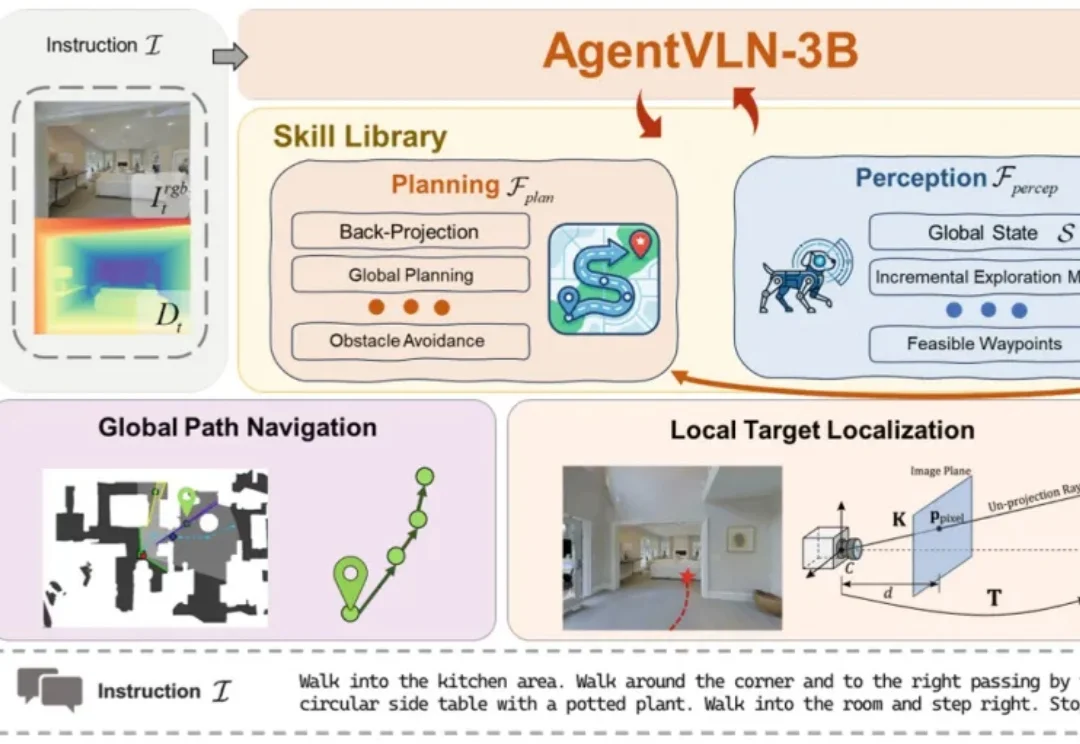
近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
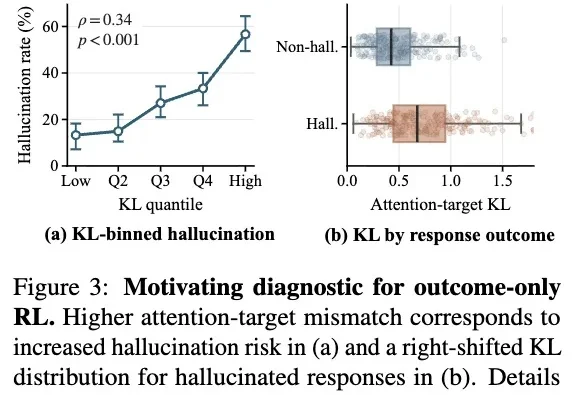
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
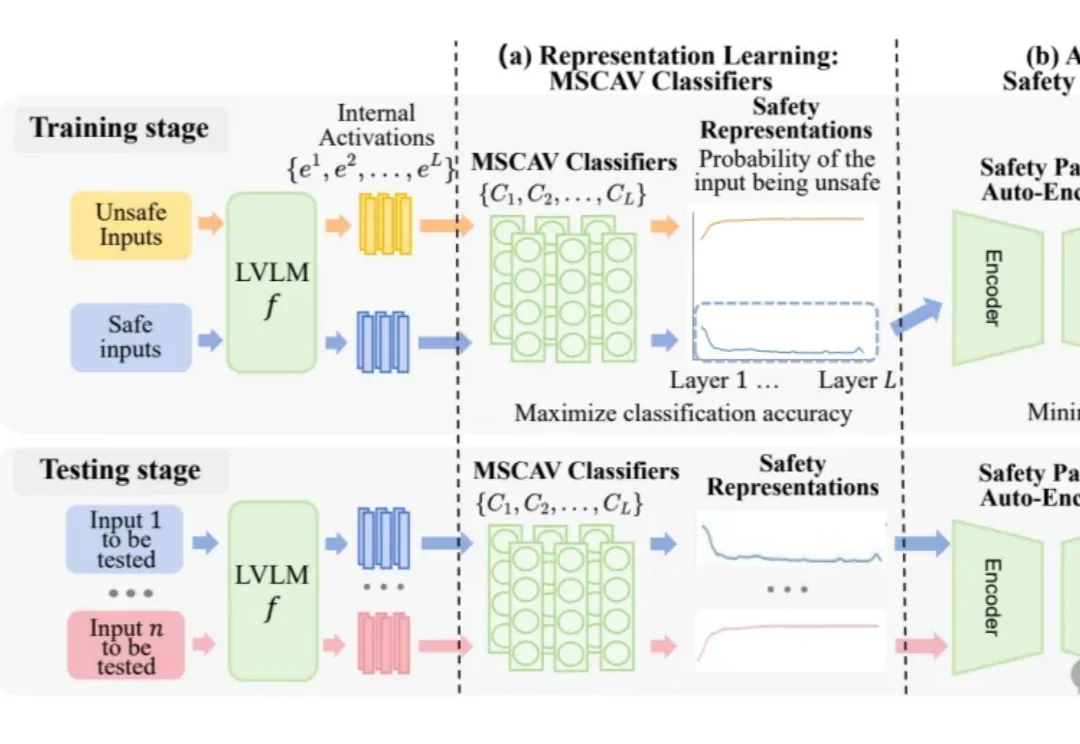
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
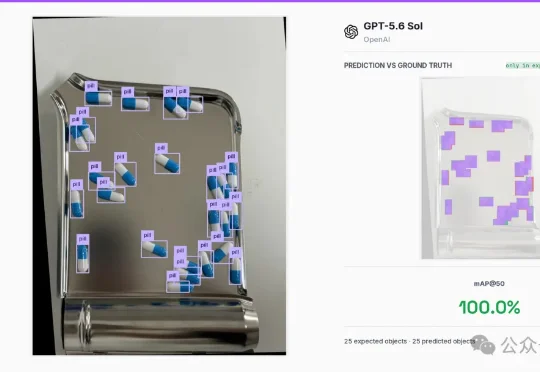
最近,第三方视觉评测机构Roboflow,把GPT-5.6 「全家桶」拖进自家VLM基准跑了一圈。测试的内容,都是最实在的活儿:找东西、数东西、认字、抽信息。仅在目标检测这项,上一代GPT-5.5只拿到13.8分。这个分数,在视觉模型圈里基本等于交白卷。
Gemini 领跑,GPT表现平平,国立清华、英伟达提出双奖励孪生网络,告别算力焦虑。