AI资讯新闻榜单内容搜索-attention

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: attention
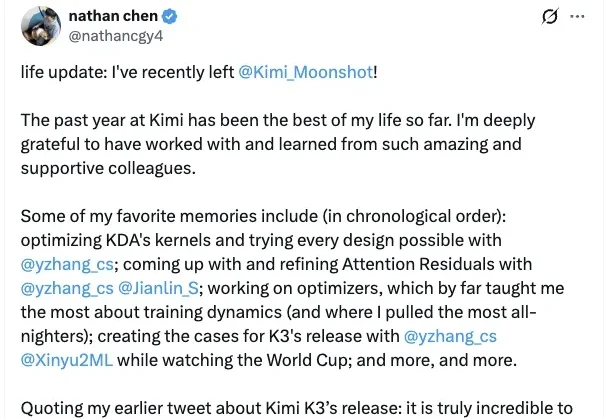
17岁天才少年陈广宇,宣布离开Kimi

17岁天才少年陈广宇,宣布离开Kimi

17岁天才少年陈广宇,宣布离开Kimi

今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。

来自主题: AI资讯
10728 点击    2026-10-16 12:10
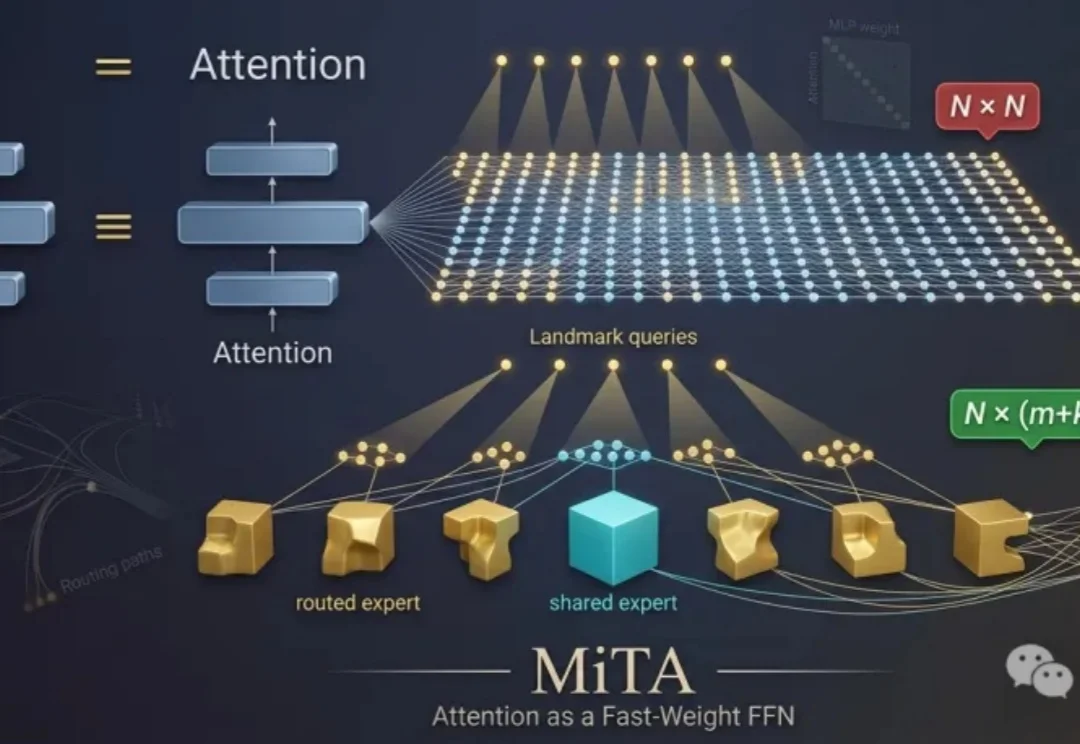
注意力也是FFN?从快权重出发,重新理解高效注意力 |NeurIPS'26

注意力也是FFN?从快权重出发,重新理解高效注意力 |NeurIPS'26

注意力也是FFN?从快权重出发,重新理解高效注意力 |NeurIPS'26

一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
来自主题: AI技术研报
8409 点击    2026-10-12 11:45
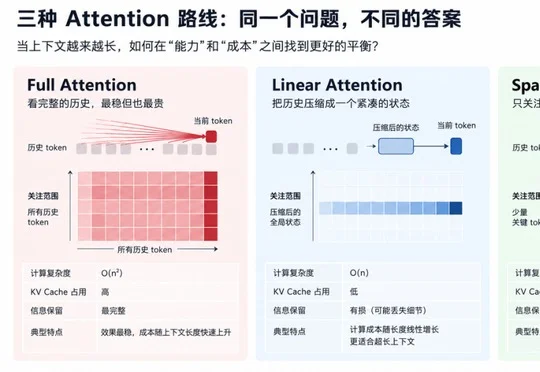
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
7324 点击    2026-09-25 10:11
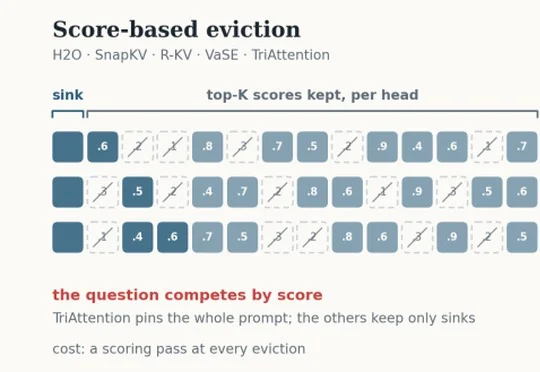
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%

KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%

KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%

大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
来自主题: AI技术研报
9150 点击    2026-09-20 11:05
吹爆开源!RunningHub让MiniMax H3满血提速12倍,本地部署照样起飞

吹爆开源!RunningHub让MiniMax H3满血提速12倍,本地部署照样起飞

吹爆开源!RunningHub让MiniMax H3满血提速12倍,本地部署照样起飞

RunningHub推出开源的H3 Lightning加速方案,在保留BF16满血精度的前提下使MiniMax H3视频生成速度提升约12倍,依托RH后训练加速模型、SageAttention2等工程优化并针对无NVLink的PCIe多卡环境调优,目前已全部开源至GitHub,支持创作者本地部署。
来自主题: AI资讯
9866 点击    2026-09-10 19:34
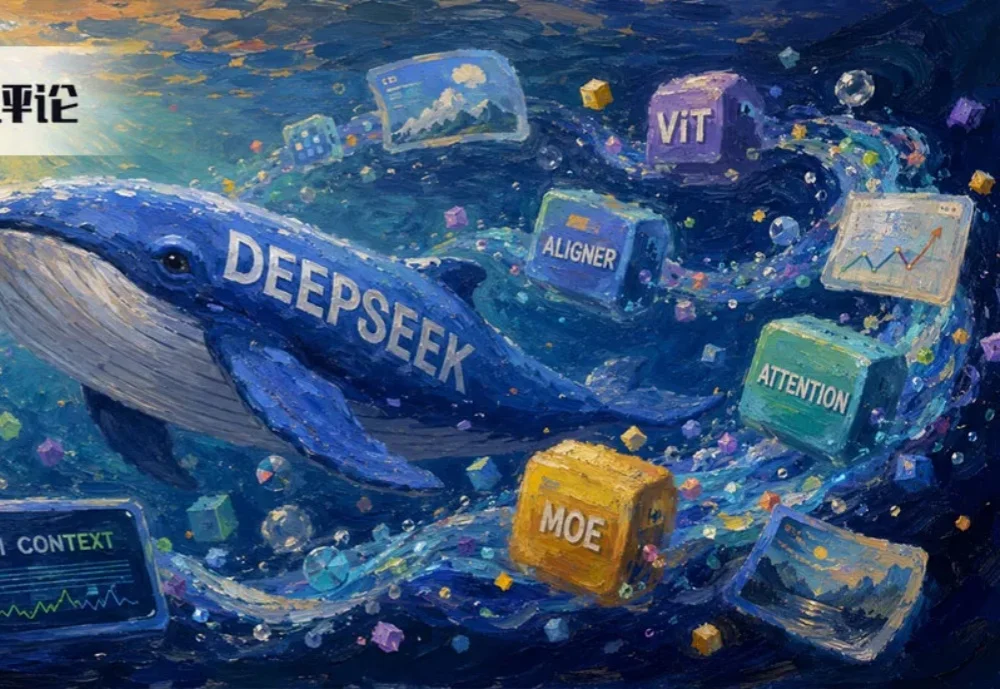
DeepSeek V4 多模态开源,我们把它的视觉链路拆了一遍

DeepSeek V4 多模态开源,我们把它的视觉链路拆了一遍

DeepSeek V4 多模态开源,我们把它的视觉链路拆了一遍

图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
来自主题: AI技术研报
10524 点击    2026-09-02 09:27
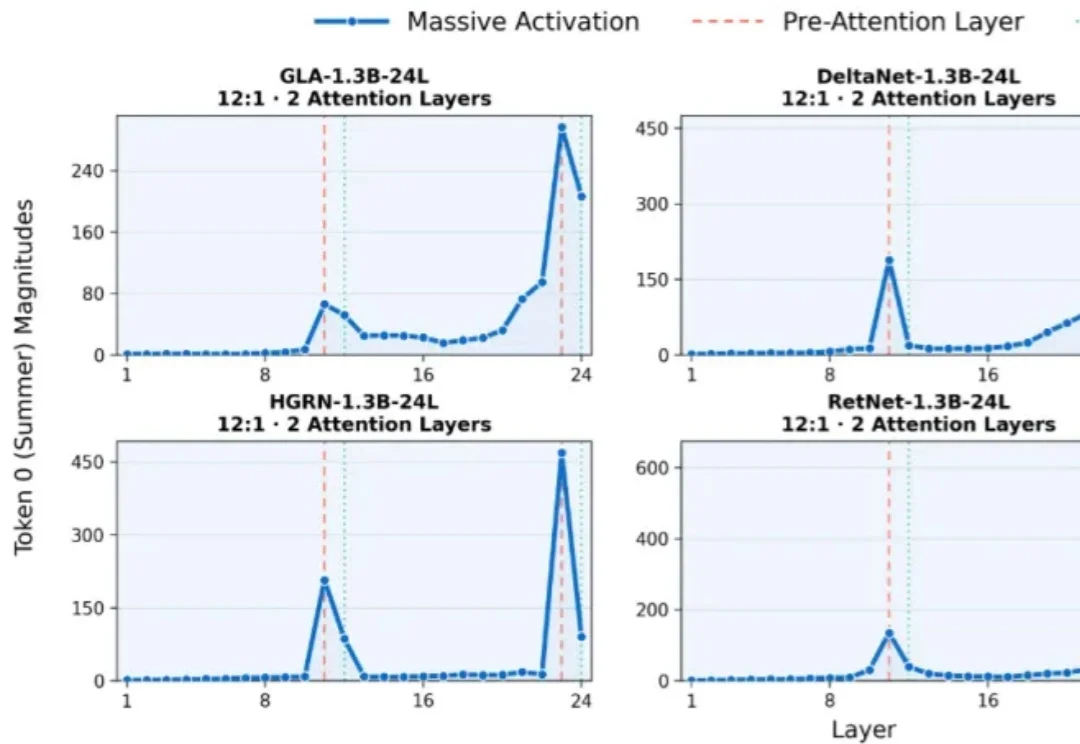
少数Full Attention层如何重塑内部计算?混合线性注意力大模型中的「尖峰」与「平台」之谜首次揭开

少数Full Attention层如何重塑内部计算?混合线性注意力大模型中的「尖峰」与「平台」之谜首次揭开

少数Full Attention层如何重塑内部计算?混合线性注意力大模型中的「尖峰」与「平台」之谜首次揭开

Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
来自主题: AI技术研报
8593 点击    2026-09-01 14:21
快一点!再快一点!快到世界能实时生成|和生数科技张金涛聊:Vidu S1、推理加速、实时交互模型

快一点!再快一点!快到世界能实时生成|和生数科技张金涛聊:Vidu S1、推理加速、实时交互模型

快一点!再快一点!快到世界能实时生成|和生数科技张金涛聊:Vidu S1、推理加速、实时交互模型

金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」
来自主题: AI资讯
10070 点击    2026-07-25 10:56
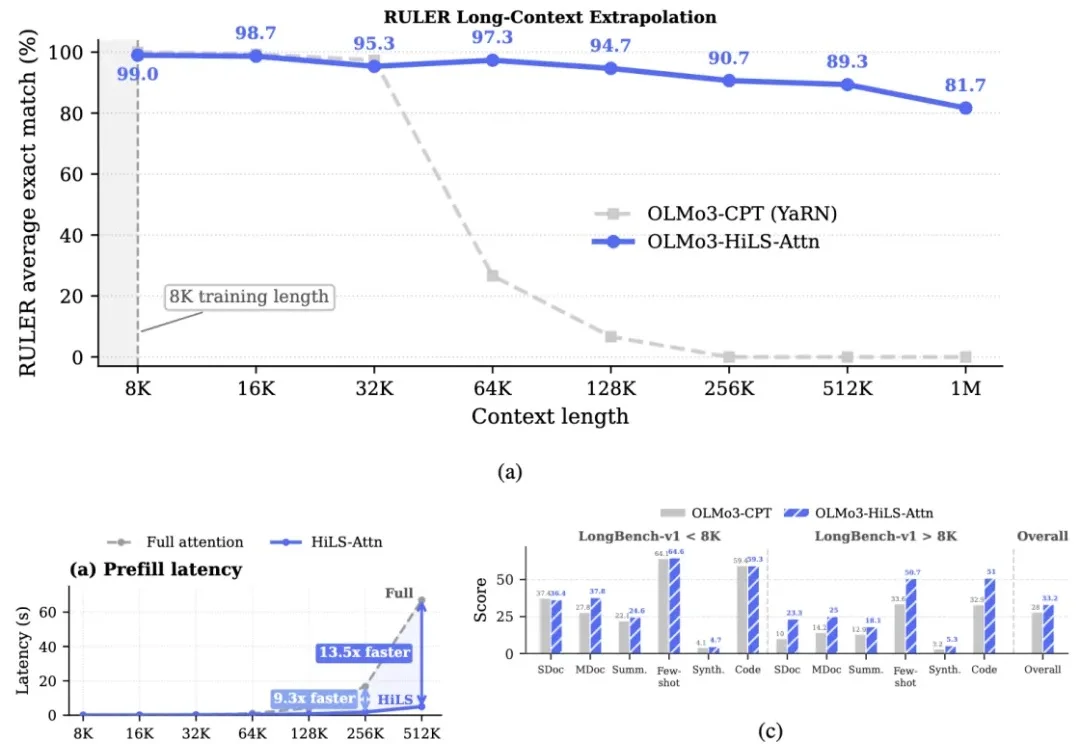
在数学上把稀疏注意力做对!腾讯Hy开源HiLS-Attention: 计算更少效果更好, 外推512倍

在数学上把稀疏注意力做对!腾讯Hy开源HiLS-Attention: 计算更少效果更好, 外推512倍

在数学上把稀疏注意力做对!腾讯Hy开源HiLS-Attention: 计算更少效果更好, 外推512倍

让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
来自主题: AI技术研报
9736 点击    2026-07-20 15:19
Kimi K3:智能的新前沿

Kimi K3:智能的新前沿

Kimi K3:智能的新前沿

Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。

来自主题: AI资讯
10201 点击    2026-07-19 10:08