AI资讯新闻榜单内容搜索-上下文

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 上下文
Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法

Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法

Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法

Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。

来自主题: AI技术研报
9619 点击    2026-10-20 11:29
当Coding Agent开始动态并行,软件开发变得更好了吗?

当Coding Agent开始动态并行,软件开发变得更好了吗?

当Coding Agent开始动态并行,软件开发变得更好了吗?

Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。

来自主题: AI技术研报
5564 点击    2026-10-19 11:10
登顶RoboDojo智能体超过GPT-6 Astra:Manifold AI推出R²SI

登顶RoboDojo智能体超过GPT-6 Astra:Manifold AI推出R²SI

登顶RoboDojo智能体超过GPT-6 Astra:Manifold AI推出R²SI

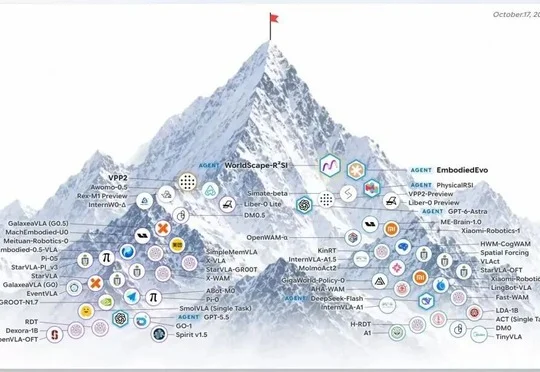
Manifold AI推出WorldScape R²SI,通过上下文学习与双层Agent持续改进能力登顶RoboDojo Agent Track总榜,超过GPT-6-Astra等模型。

来自主题: AI资讯
8840 点击    2026-10-18 13:09
NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。

来自主题: AI技术研报
8492 点击    2026-10-17 11:59
EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

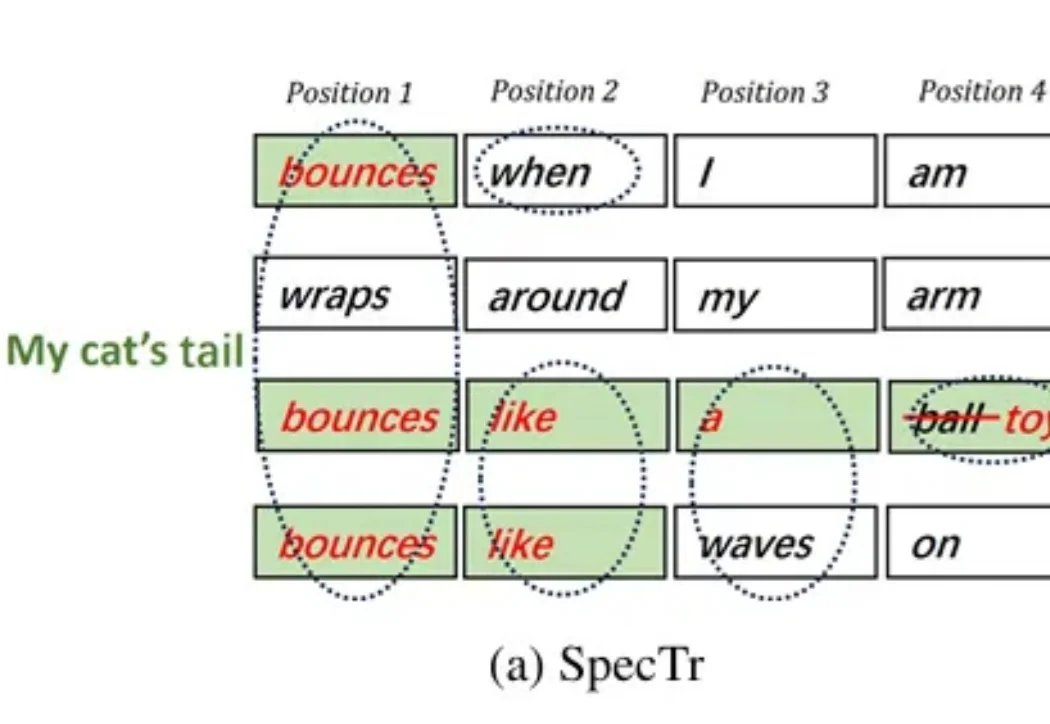
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。

来自主题: AI技术研报
8529 点击    2026-10-15 13:56
苹果LensVLM:长上下文压缩成图片,模型边看边「放大」

苹果LensVLM:长上下文压缩成图片,模型边看边「放大」

苹果LensVLM:长上下文压缩成图片,模型边看边「放大」

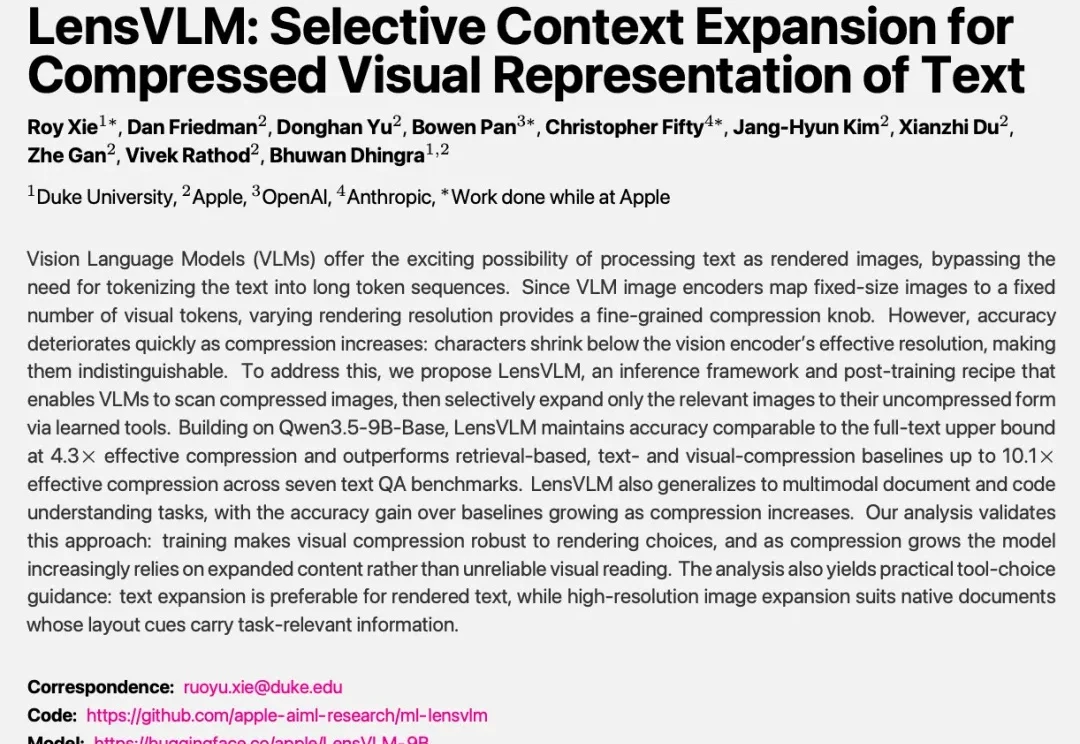
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。

来自主题: AI技术研报
6795 点击    2026-10-15 11:26
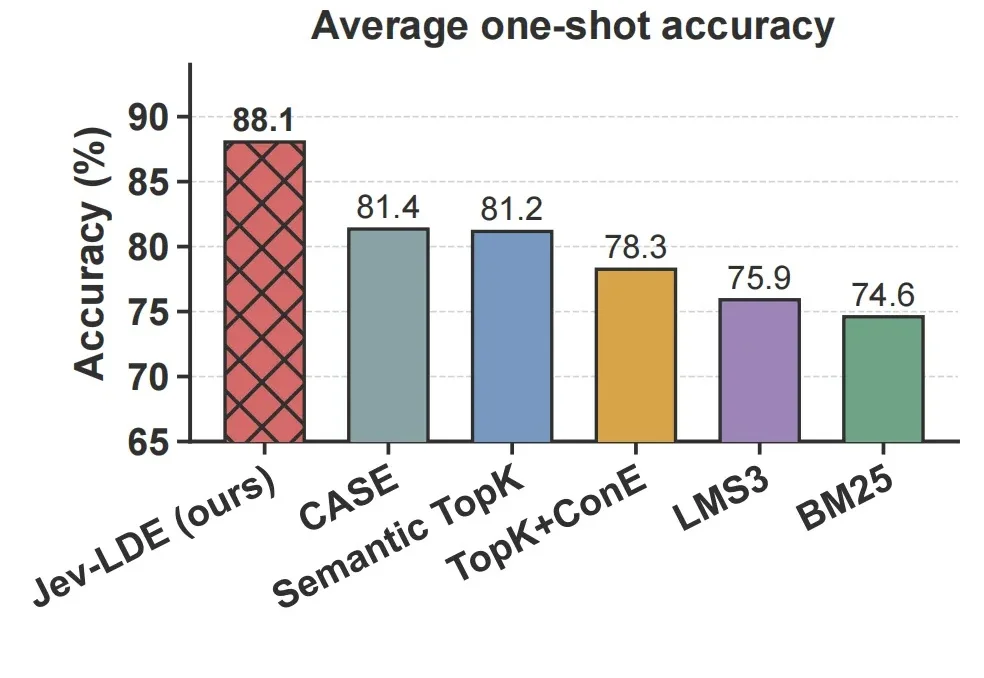
清华提出Jev-LDE:ICL示例只改一次,1-shot平均准确率就能暴涨

清华提出Jev-LDE:ICL示例只改一次,1-shot平均准确率就能暴涨

清华提出Jev-LDE:ICL示例只改一次,1-shot平均准确率就能暴涨

大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。

来自主题: AI技术研报
8521 点击    2026-10-14 15:27
GPT-6.1 Sol一夜扩容500k!完全免费

GPT-6.1 Sol一夜扩容500k!完全免费

GPT-6.1 Sol一夜扩容500k!完全免费

GPT-6.1 Sol,默认上下文直接冲到500k!

来自主题: AI资讯
6637 点击    2026-10-13 16:59
刚刚,Claude Haiku 5.5发布!价格暴降90%

刚刚,Claude Haiku 5.5发布!价格暴降90%

刚刚,Claude Haiku 5.5发布!价格暴降90%

Anthropic发布Claude Haiku 5.5,单价为Haiku 4.5的十分之一,多项跑分显著提升,定位为处理摘要、上下文压缩、数据库查询和分类等任务的高速低成本模型。

来自主题: AI资讯
10747 点击    2026-10-08 10:53
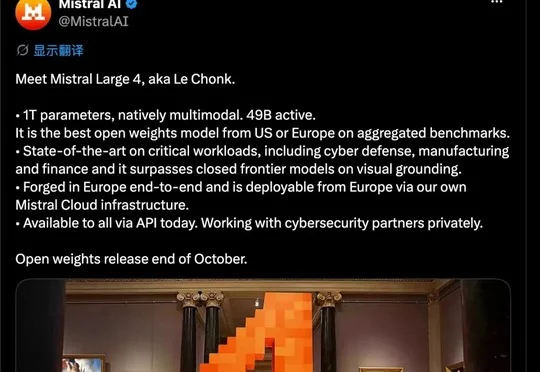
Mistral Large 4 发布:1T 参数、49B 激活,aka「大胖猫」

Mistral Large 4 发布:1T 参数、49B 激活,aka「大胖猫」

Mistral Large 4 发布:1T 参数、49B 激活,aka「大胖猫」

Mistral 发布 Mistral Large 4,采用细粒度混合专家结构,总参数1.05T、每次激活49B,支持图文输入和100万上下文,API现已开放,权重计划于10月27日发布。

来自主题: AI资讯
10684 点击    2026-10-07 00:00