AI资讯新闻榜单内容搜索-多模态

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 多模态
新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。

来自主题: AI资讯
7998 点击    2026-10-18 13:02
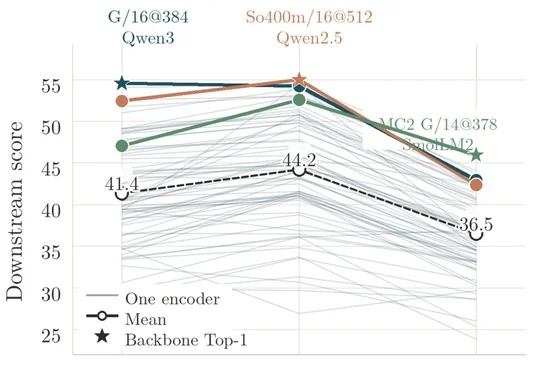
给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍

给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍

给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍

团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
来自主题: AI技术研报
9338 点击    2026-10-18 13:02
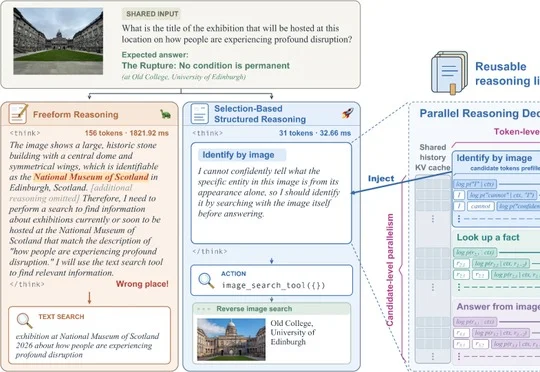
Agent推理快10倍是怎么做到的?苹果×CMU:把「生成」改成「做选择题」

Agent推理快10倍是怎么做到的?苹果×CMU:把「生成」改成「做选择题」

Agent推理快10倍是怎么做到的?苹果×CMU:把「生成」改成「做选择题」

苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
来自主题: AI技术研报
9581 点击    2026-10-17 11:55
独家|实现多项基准领先!Xspark AI发布原生触觉多模态模型Spark-0,再获新一轮融资

独家|实现多项基准领先!Xspark AI发布原生触觉多模态模型Spark-0,再获新一轮融资

独家|实现多项基准领先!Xspark AI发布原生触觉多模态模型Spark-0,再获新一轮融资

Z Potentials 独家获悉,Xspark AI(无界智航)近日完成新一轮融资。本轮融资由猎道投资、华山资本、元航资本、浦东创投、钧源资本、南山战新投、水木创投等机构共同参与,多维资本担任本轮融资独家财务顾问。
来自主题: AI资讯
9456 点击    2026-10-16 12:08
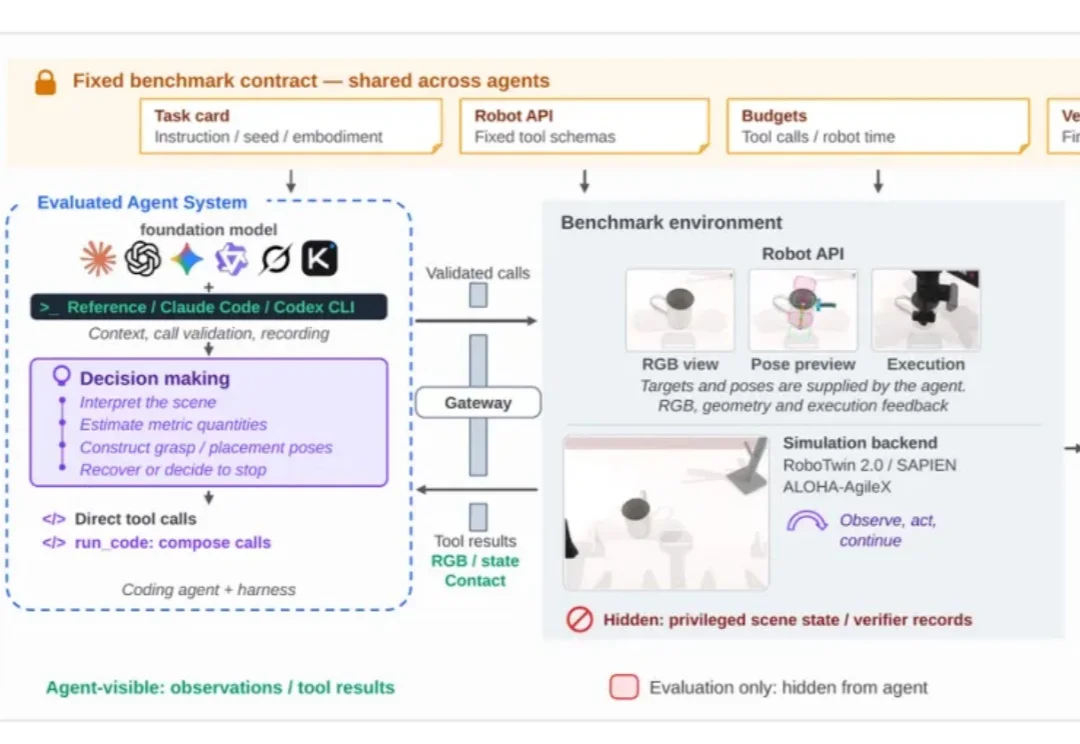
会看图、会写代码的通用 Agent,能完成机器人操作吗?CodeActionBench 发布

会看图、会写代码的通用 Agent,能完成机器人操作吗?CodeActionBench 发布

会看图、会写代码的通用 Agent,能完成机器人操作吗?CodeActionBench 发布

从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
来自主题: AI技术研报
6768 点击    2026-10-16 10:54
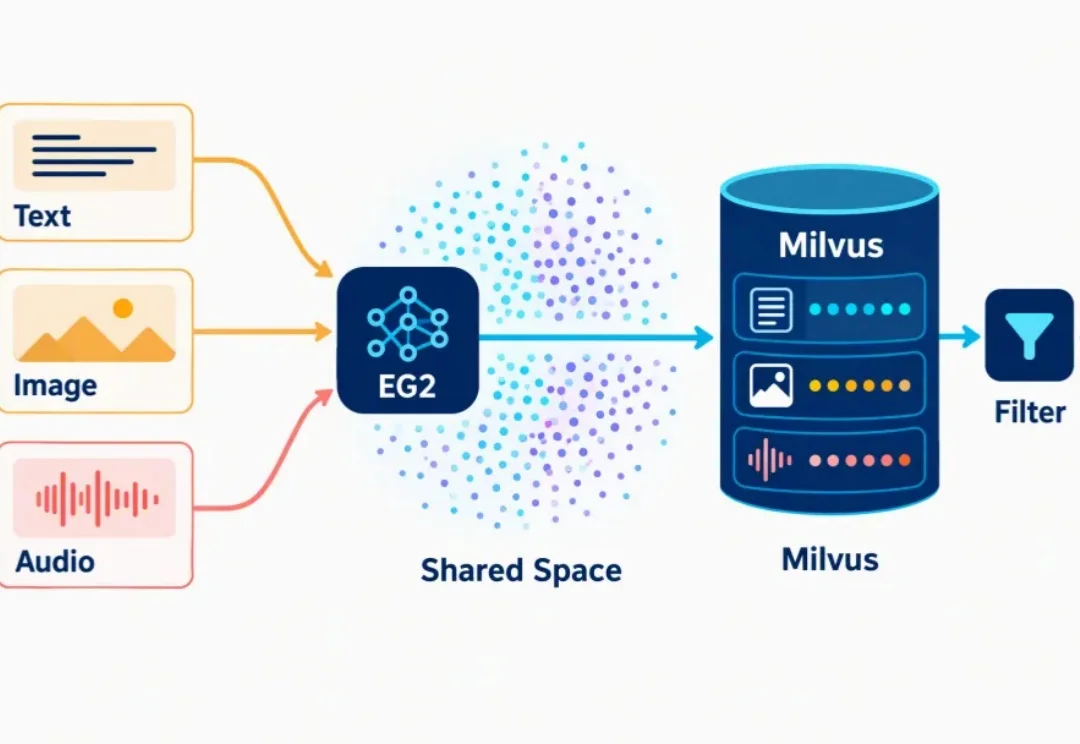
谷歌EG 2模型+Milvus实测:最适合低成本本地部署的多模态embedding模型来了

谷歌EG 2模型+Milvus实测:最适合低成本本地部署的多模态embedding模型来了

谷歌EG 2模型+Milvus实测:最适合低成本本地部署的多模态embedding模型来了

传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
来自主题: AI产品测评
6637 点击    2026-10-14 11:17
0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一

0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一

0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一

vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。
来自主题: AI资讯
9697 点击    2026-10-12 19:23
从一步生图到流式视频:清华团队探索「样本分布训练」

从一步生图到流式视频:清华团队探索「样本分布训练」

从一步生图到流式视频:清华团队探索「样本分布训练」

对着屏幕说一句 “向左转”,画面随即展开新的视野;调整角色的动作,场景紧接着给出反馈。多模态交互要求视觉生成跟上人的操作,而漫长的等待会打断整个体验。
来自主题: AI技术研报
7641 点击    2026-10-12 11:44
何恺明团队发布多模态Harness框架

何恺明团队发布多模态Harness框架

何恺明团队发布多模态Harness框架

多模态模型的视觉原生Harness,来了!

来自主题: AI技术研报
9509 点击    2026-10-09 12:02