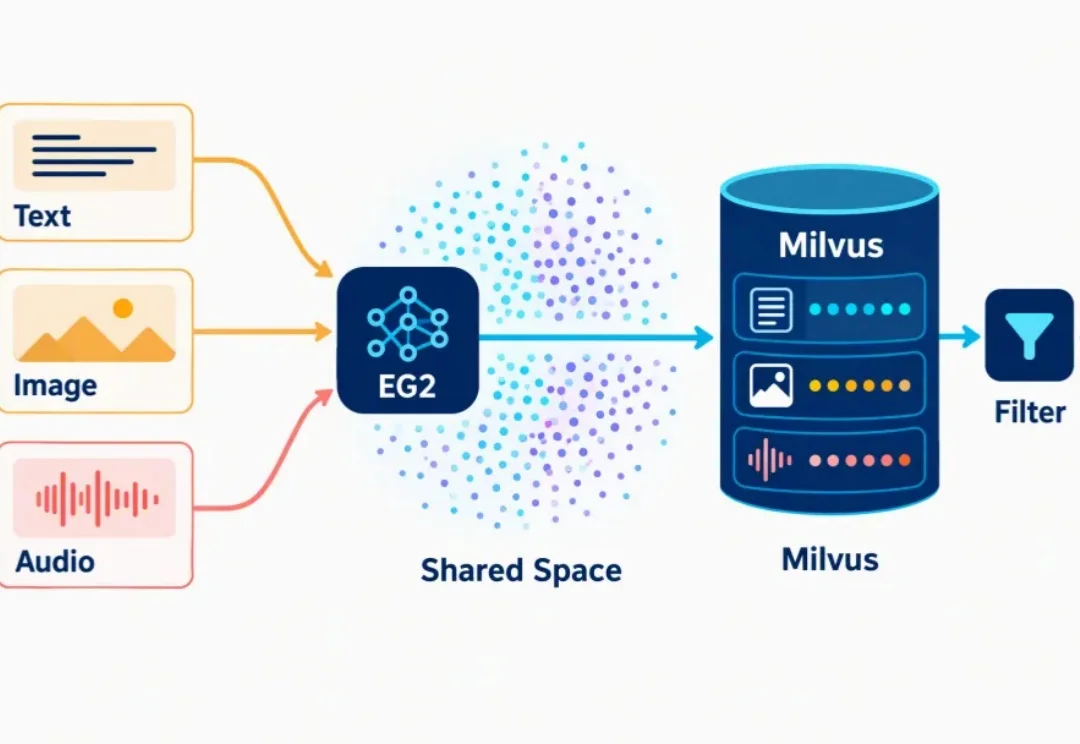
谷歌EG 2模型+Milvus实测:最适合低成本本地部署的多模态embedding模型来了
谷歌EG 2模型+Milvus实测:最适合低成本本地部署的多模态embedding模型来了传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
来自主题: AI产品测评
6649 点击 2026-10-14 11:17

 搜索
传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
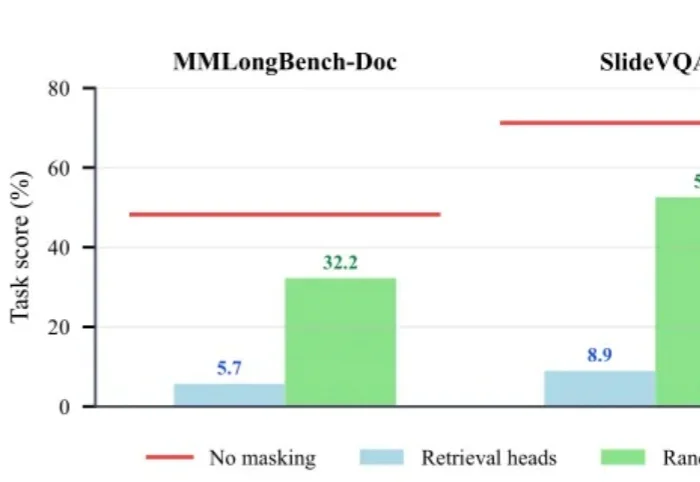
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
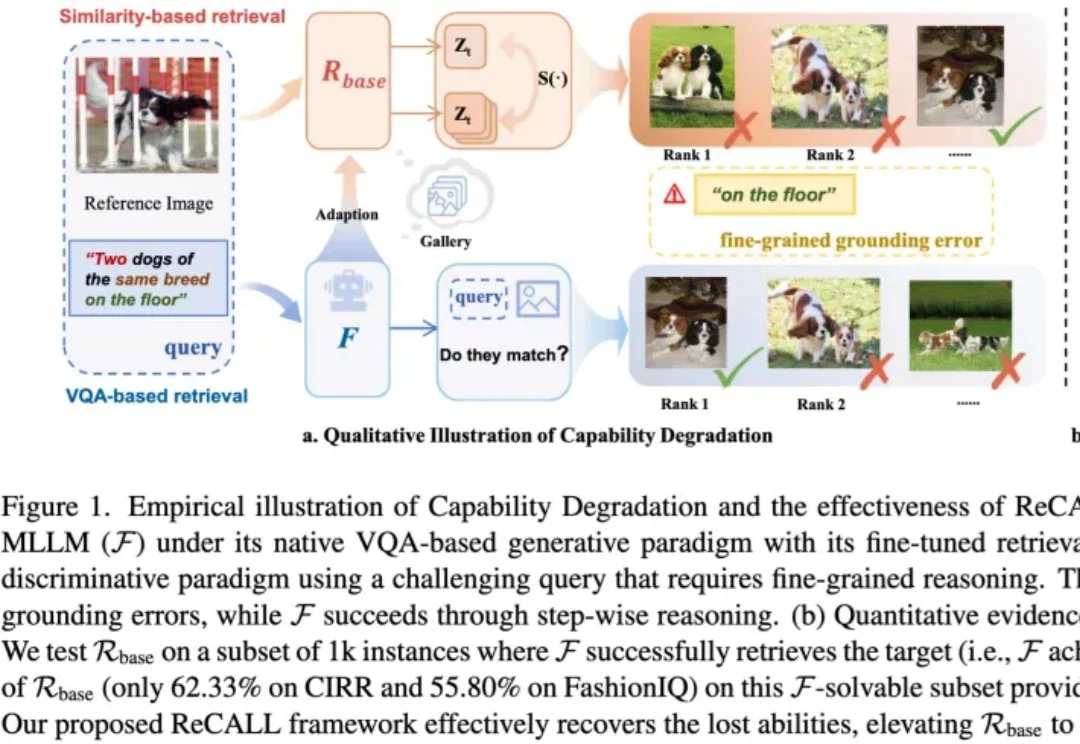
生成式模型当检索器大材小用效果还不好?
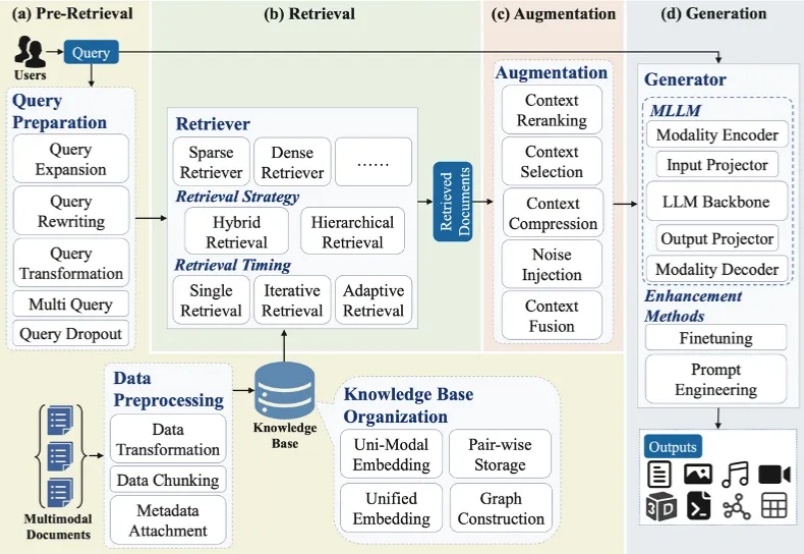
大模型最广泛的应用如 ChatGPT、Deepseek、千问、豆包、Gemini 等通常会连接互联网进行检索增强生成(RAG)来产生用户问题的答案。随着多模态大模型(MLLMs)的崛起,大模型的主流技术之一 RAG 迅速向多模态发展,形成多模态检索增强生成(MM-RAG)这个新兴领域。ChatGPT、千问、豆包、Gemini 都开始允许用户提供文字、图片等多种模态的输入。
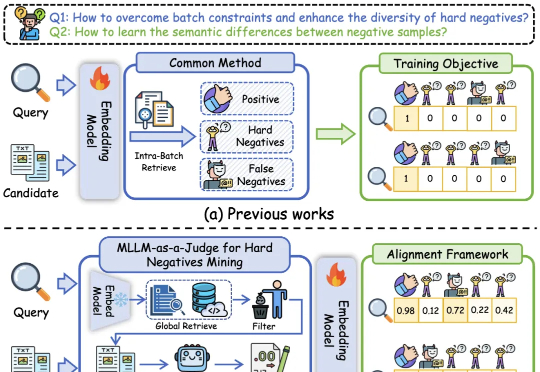
基于多模态大模型语义理解能力的统一多模态嵌入模型UniME-V2。该方法首先通过全局检索构建潜在困难负例集,随后创新性地引入“MLLM-as-a-Judge”机制:利用MLLM对查询-候选对进行语义对齐评估,生成软语义匹配分数。
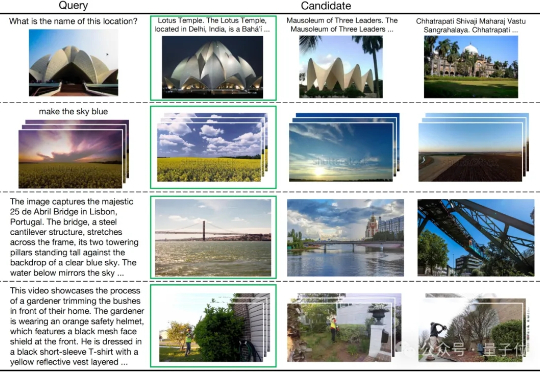
多模态检索是信息理解与获取的关键技术,但其中的跨模态干扰问题一直是一大难题。
就在刚刚,智源研究员联合多所高校开放三款向量模型,以大优势登顶多项测试基准。其中,BGE-Code-v1直接击穿代码检索天花板,百万行级代码库再也不用怕了!
智源联手多所顶尖高校发布的多模态向量模型BGE-VL,重塑了AI检索领域的游戏规则。它凭借独创的MegaPairs合成数据技术,在图文检索、组合图像检索等多项任务中,横扫各大基准刷新SOTA。
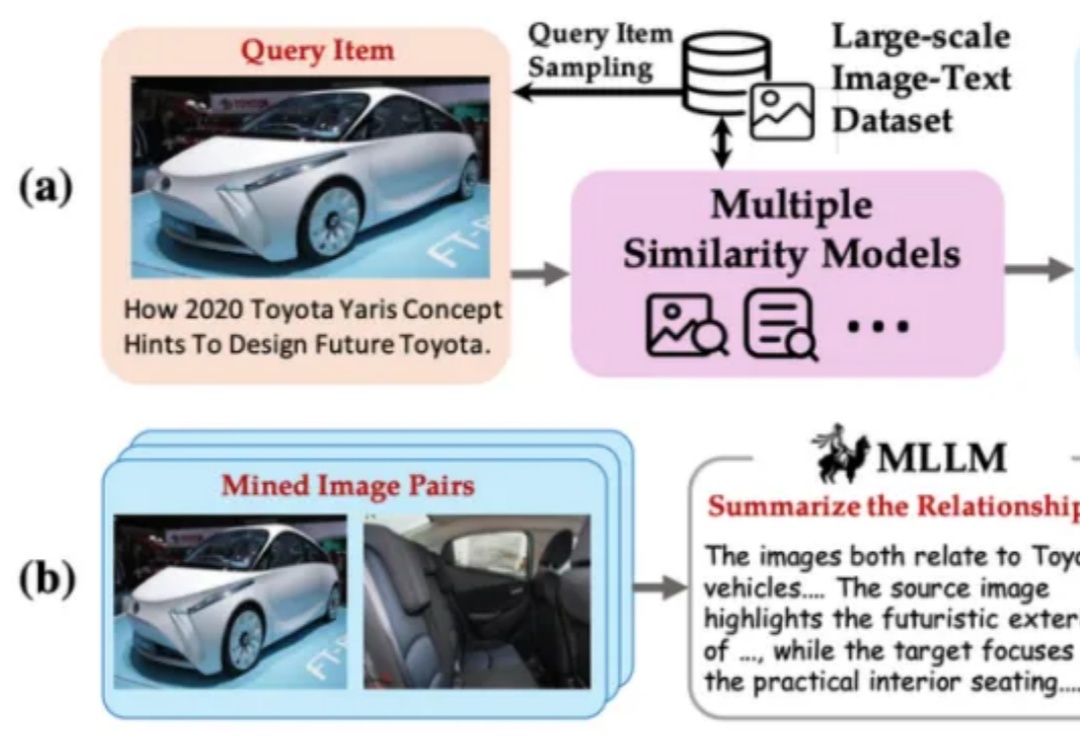
BGE 系列模型自发布以来广受社区好评。近日,智源研究院联合多所高校开发了多模态向量模型 BGE-VL,进一步扩充了原有生态体系。
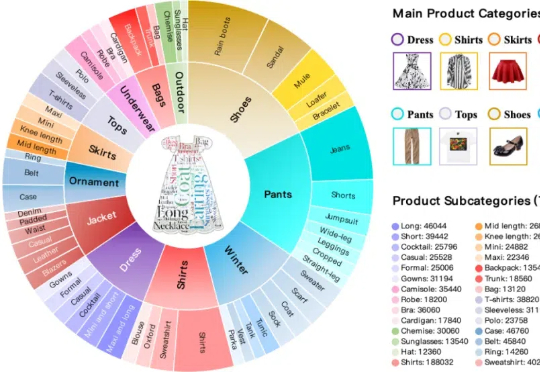
本文构建了新的多轮组合图像检索数据集和评测基准FashionMT。其特点包括:(1)回溯性:每轮修改文本可能涉及历史参考图像信息(如保留特定属性),要求算法回溯利用多轮历史信息;(2)多样化:FashionMT包含的电商图像数量和类别分别是MT FashionIQ的14倍和30倍,且交互轮次数量接近其27倍,提供了丰富的多模态检索场景。