GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁
GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
来自主题: AI技术研报
7250 点击 2026-10-20 12:19

 搜索
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
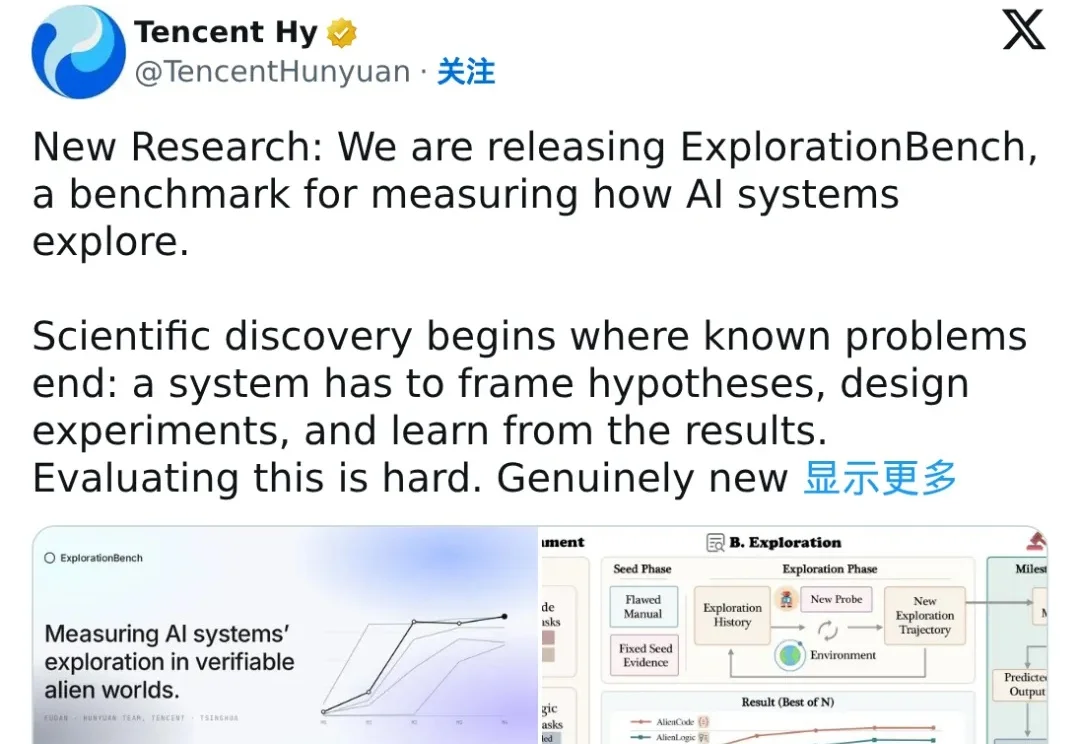
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
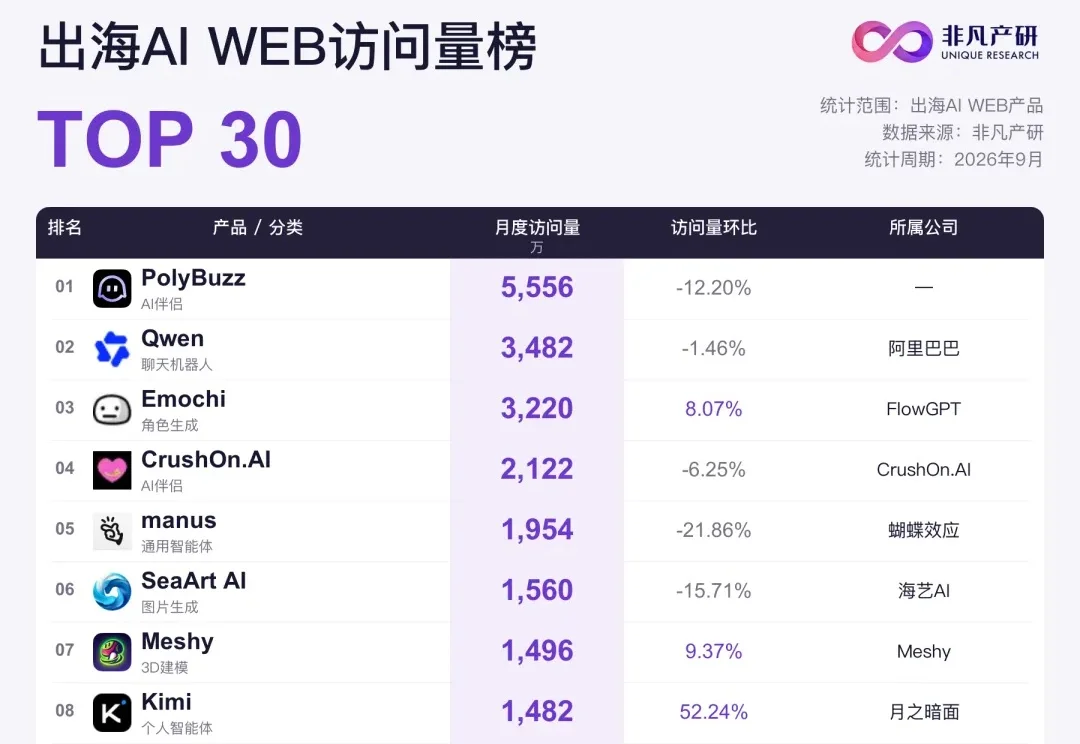
即便通用大模型的图像、视频能力越来越强,消费者依然持续为垂直创意工具付费
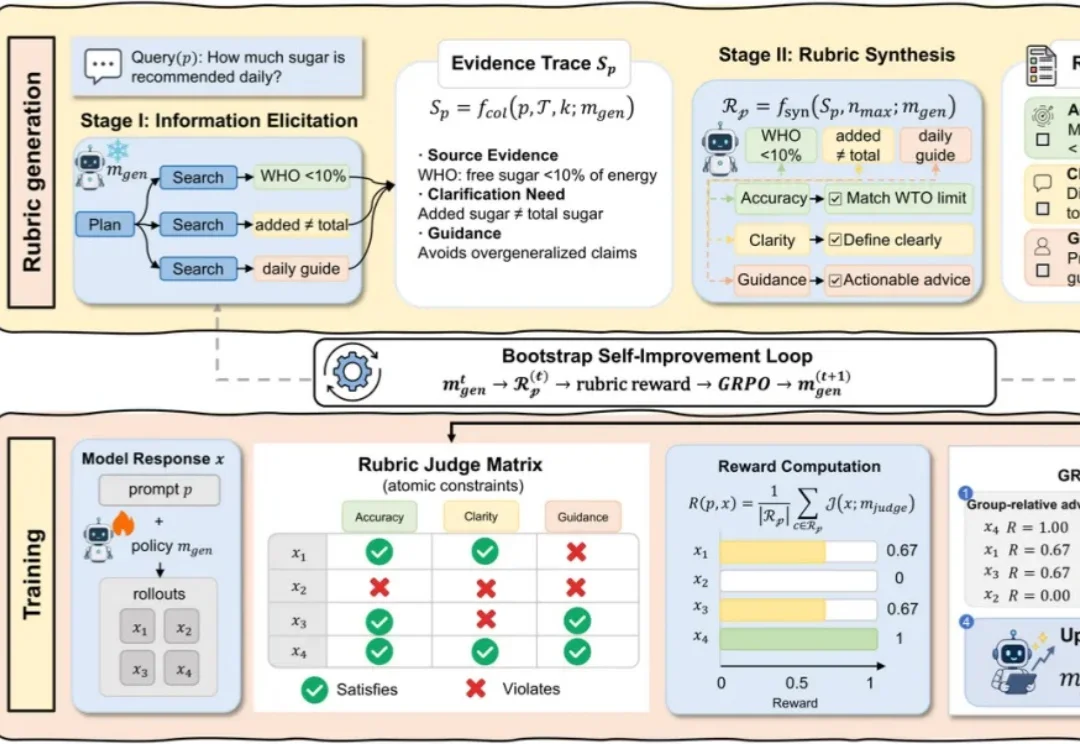
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
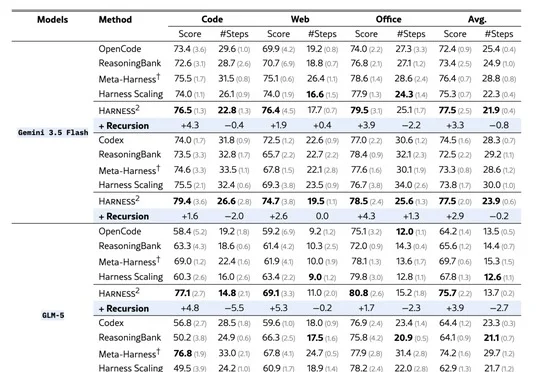
谷歌开源Harness²递归自我改进项目,使大模型无需修改权重即可自主优化外围脚手架,单步改进让GLM-5在WorkBuddy-Bench上提升11.5分。
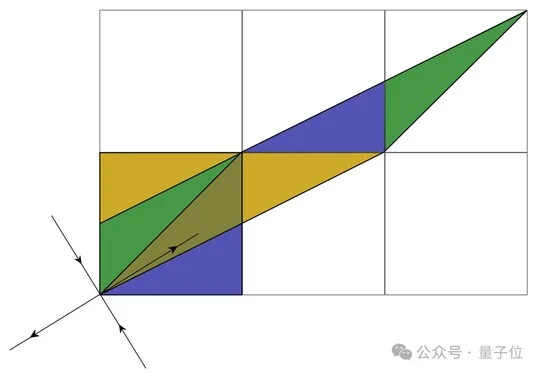
大湾区大学许地生教授团队与上海AI实验室借助书生-S2科学基础模型证明Ghys猜想在复余维一情形下成立,北京大学董彬教授、刘若川院士团队随后完成形式化验证。
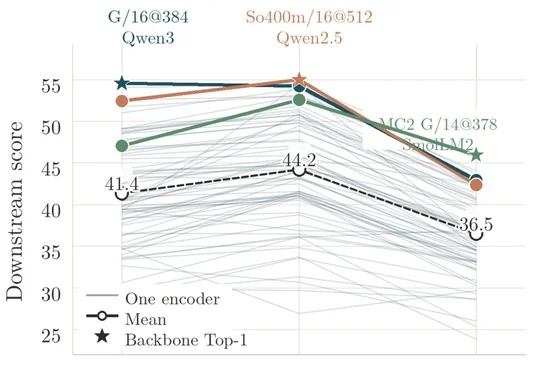
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
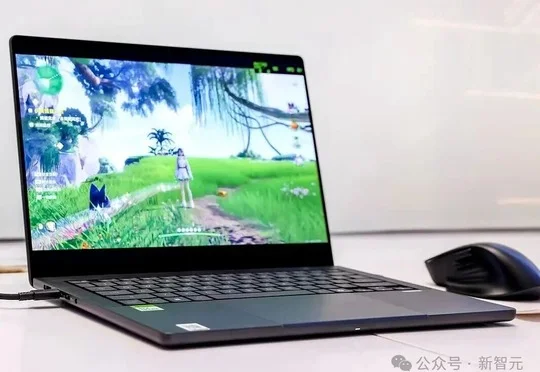
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。