卡加了,吞吐为何没跟上?大模型推理中的等待,有了新解法
卡加了,吞吐为何没跟上?大模型推理中的等待,有了新解法香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
来自主题: AI技术研报
8293 点击 2026-10-17 11:55

 搜索
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
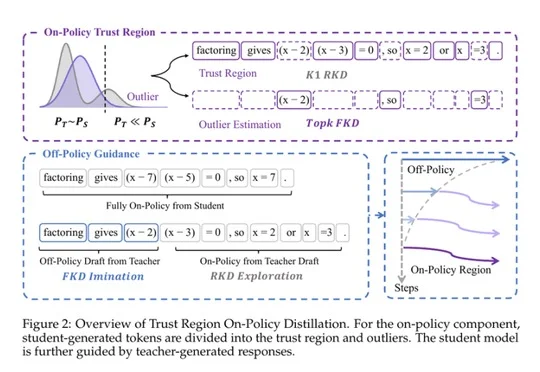
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
Anthropic发布Fable 5.1,推出"上下文一致性验证"机制,严格锁定API返回的"思考块",任何修改上下文的行为将被直接报错,从而彻底切断通过API蒸馏大模型推理过程的后路。
最近,英伟达发了篇官方的大模型推理指南,结果翻着翻着,硬是让人看成了一本华人团队的论文合集。
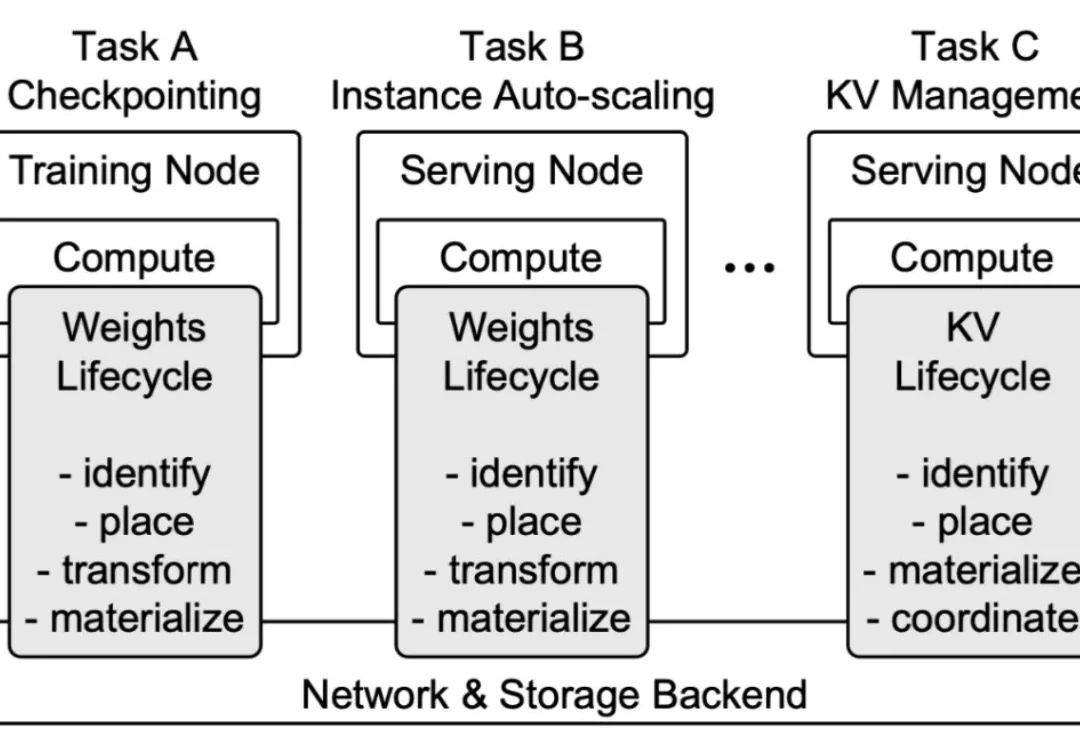
过去几年,大模型推理系统优化的核心目标一直围绕一个问题展开:如何让 GPU 更高效地计算权重、激活、KV Cache 等高维张量?从并行策略、请求调度、显存管理到算子优化,学界业界大量优化技术不断提升模型推理效率。
在刚刚落幕的2026 WAIC世界人工智能大会上,无问芯穹首次公布了其在大模型推理系统架构中的新突破——跨集群异构推理架构PDD。
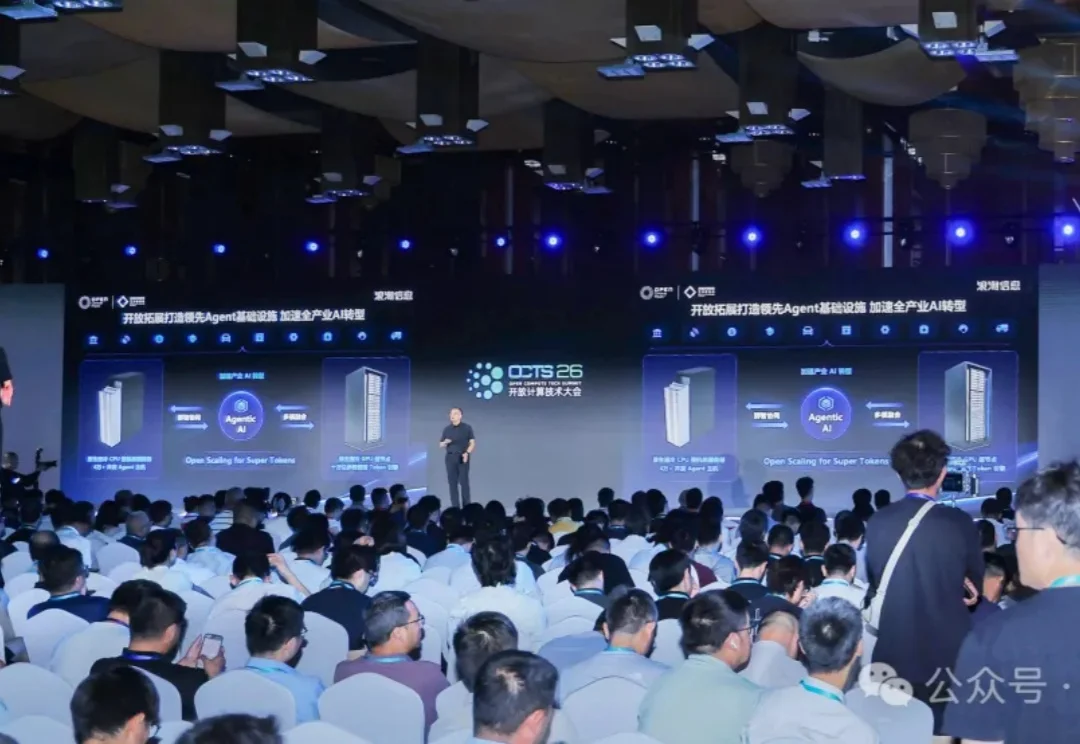
AI基础设施的核心任务,已经从支撑大模型推理,转向支撑海量智能体的规模化运行与高质量Token的持续生产。
近期,DeepSeek发布DSpark让大模型推理效率再次成为行业焦点。
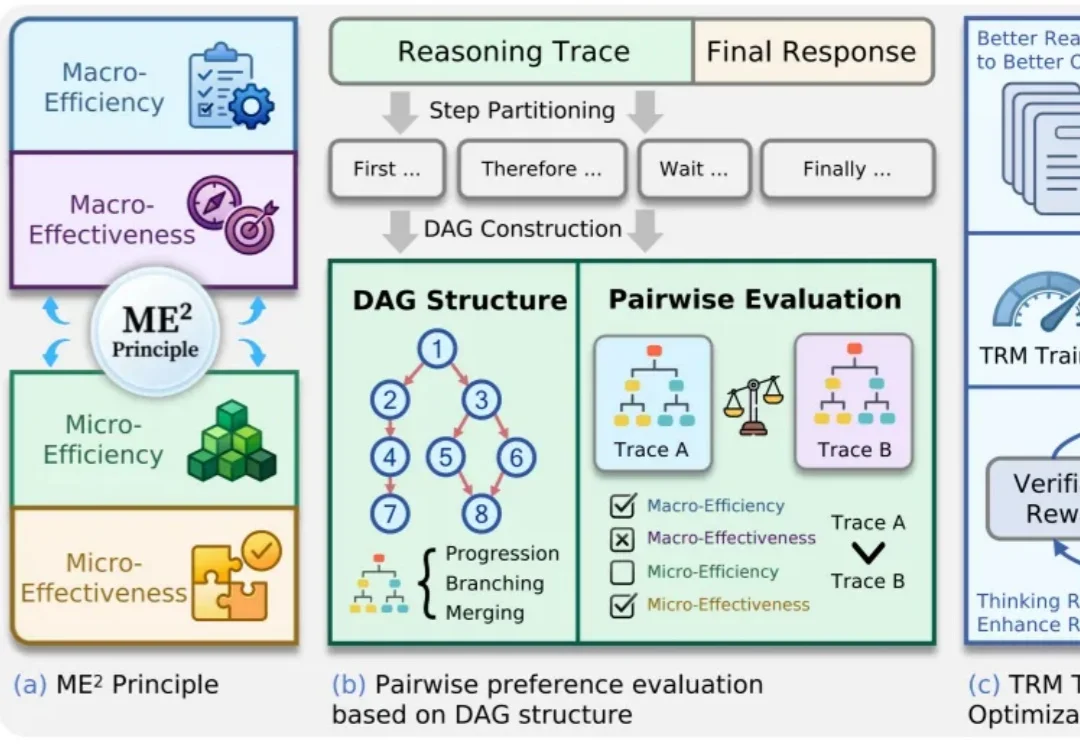
大模型推理能力越来越强,但答案对了,思考过程就一定好吗?