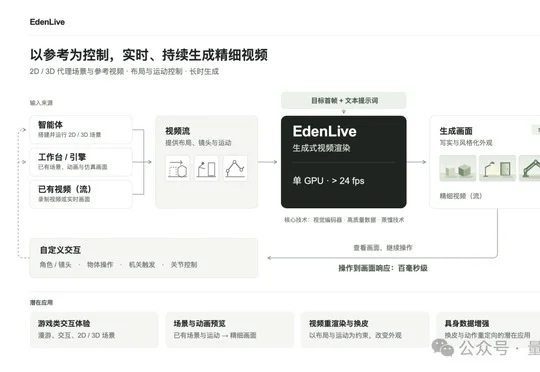
VAST开源实时世界模型EdenLive!单消费级显卡、720P超24FPS
VAST开源实时世界模型EdenLive!单消费级显卡、720P超24FPSVAST发布并开源实时世界模型EdenLive,支持任意参考输入、不同画风生成和分钟级连续运行,其5B模型在单张Nvidia RTX 5090上以720P生成速度超过24FPS,端到端延迟为百毫秒级。
来自主题: AI资讯
9300 点击 2026-10-18 22:22

 搜索
VAST发布并开源实时世界模型EdenLive,支持任意参考输入、不同画风生成和分钟级连续运行,其5B模型在单张Nvidia RTX 5090上以720P生成速度超过24FPS,端到端延迟为百毫秒级。
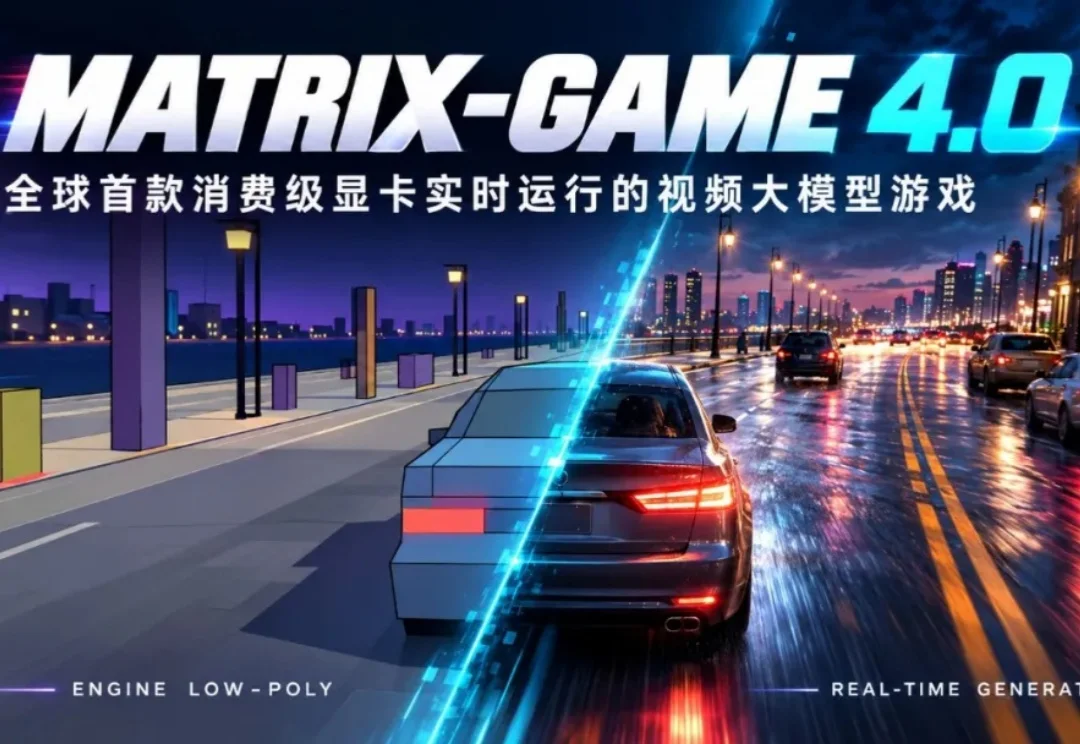
游戏玩家们,开发者们,时代变了。
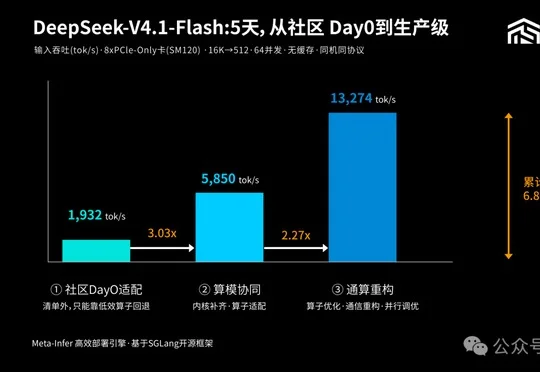
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
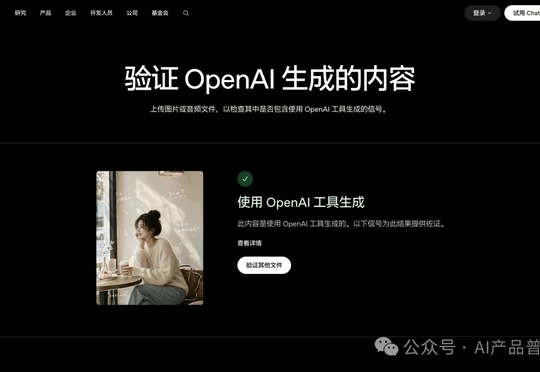
remove-ai-watermarks是支持一条命令去除AI生成图片明水印和C2PA文件信息层暗水印的开源工具,覆盖Nano Banana、豆包、即梦等多种水印,像素层SynthID暗水印需借助NVIDIA显卡跑invisible命令重绘去除。
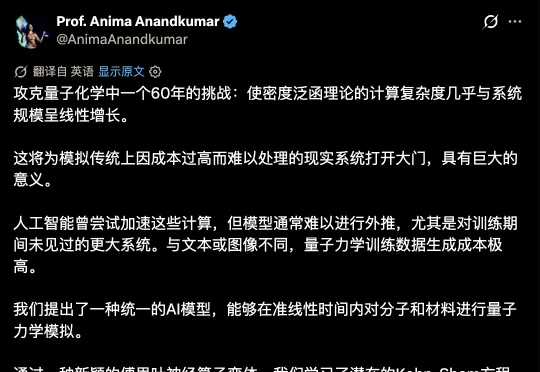
加州理工学院 Anima Anandkumar 团队 8 月 24 日发了一篇论文,用一个 AI 模型把这类计算的复杂度从立方级压到了近线性级。效果相当震撼:在单块 GPU 上完成了一个含 82500 个电子的金属缺陷模拟,2019 年同类计算用了约 7800 块 GPU。
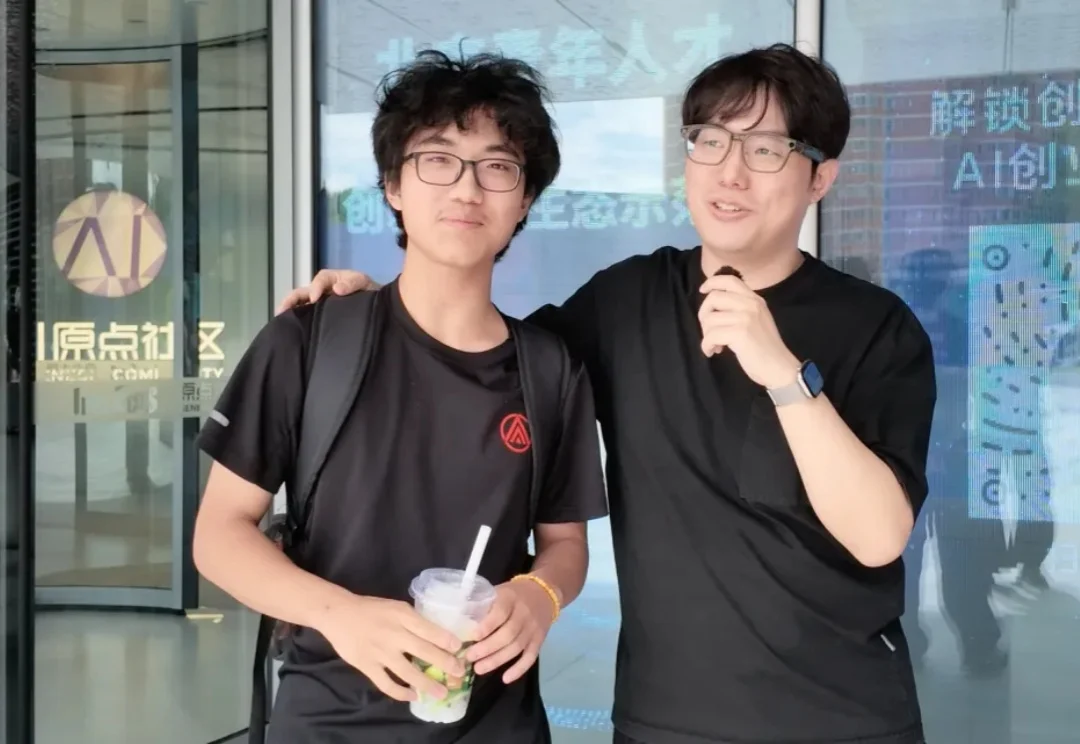
上周,我去五道口,接了一个16岁的高中生下班。
刚刚,阿里千问正式开源Qwen3.8-27B模型权重。Qwen3.8-27B是一款270亿参数的原生多模态稠密模型,支持图像、视频理解,原生上下文长度达到262K,并可通过YaRN扩展至100万Tokens。
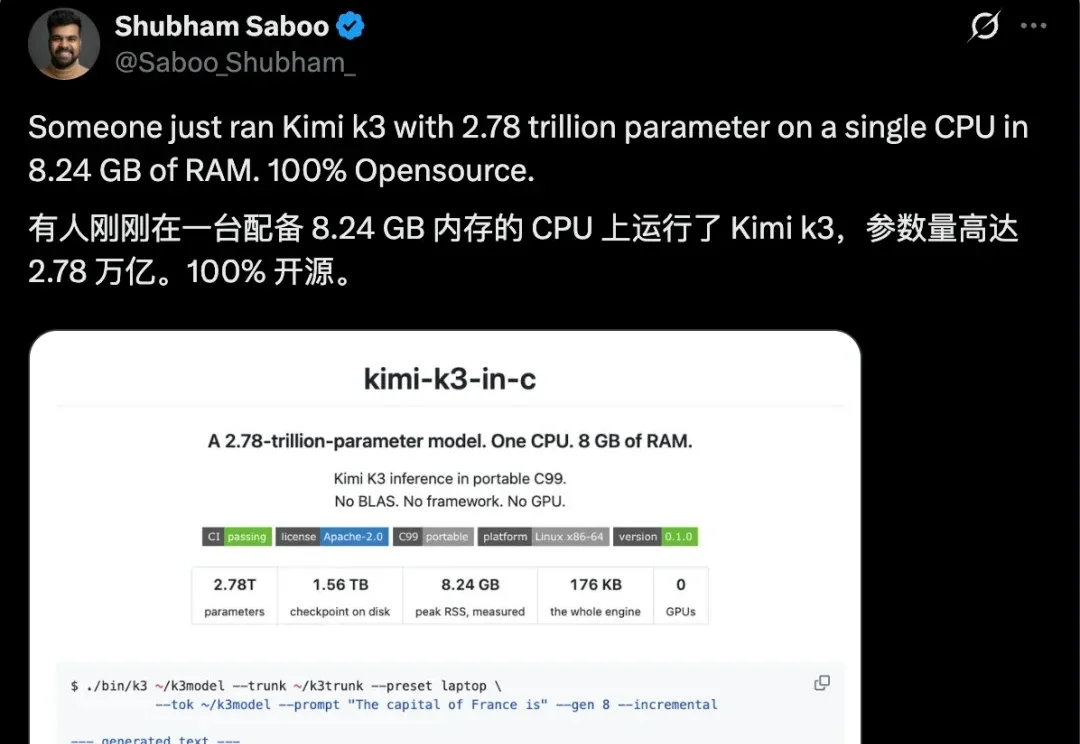
一块 8.24GB 内存的 CPU,一个 2.78 万亿参数的大模型,甚至不需要显卡,Kimi K3 就这么水灵灵地跑起来了。
金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」
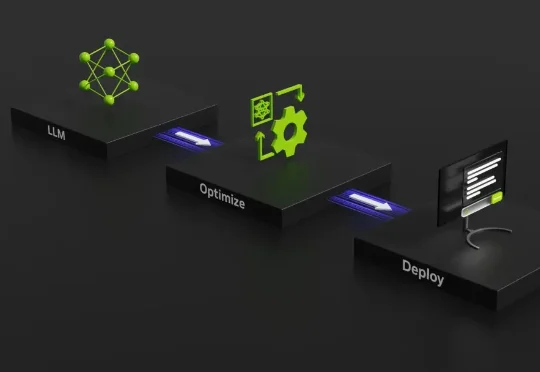
就在最近,英伟达亲自下场,发布了一篇名为《AI Model Co-Design: Hardware-Friendly LLM Design》的技术博客。整篇文章洋洋洒洒,其实就想点醒行业一件事:别光顾着堆算力了,来看看你们是怎么把顶级显卡逼成“磨洋工”的吧。