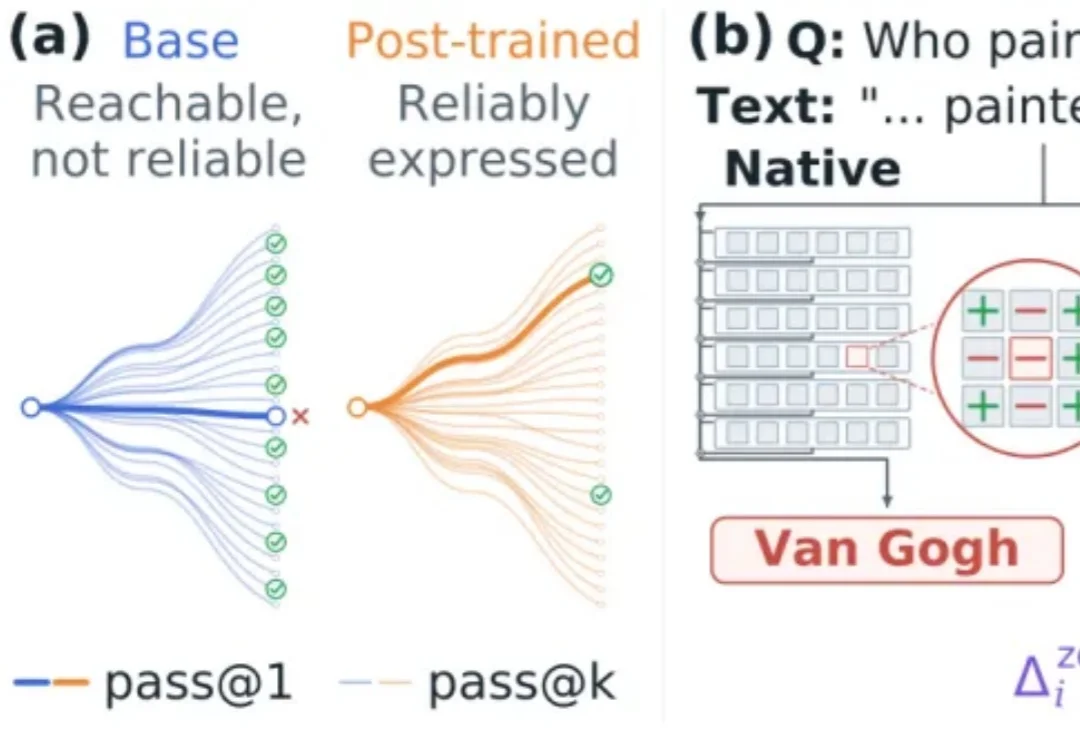
偏好对齐也能在推理时完成!256-16384个控制参数达到DPO水准
偏好对齐也能在推理时完成!256-16384个控制参数达到DPO水准让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。
来自主题: AI技术研报
7384 点击 2026-10-13 14:06

 搜索
让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。
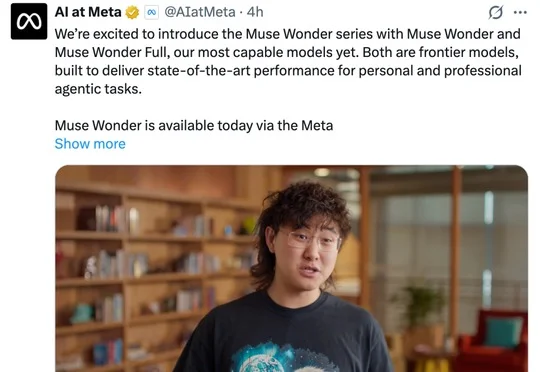
Meta发布新一代旗舰模型家族Muse Wonder,推出Muse Wonder和Muse Wonder Full,引入Active Memory与Active Focus,并在Agent、记忆及编程等关键评测中取得领先成绩。
Z Potentials 独家获悉,上海半图科技(SemiGraph)已完成单轮超过千万美元融资,由联想创投等多家国内及海外一线资本领投,老股东IDG资本持续加码。本轮融资将主要用于人类行为模型研发、数据体系建设、团队扩充,以及AI原生3D互动场景的产品化落地。
想象你站在一条产线旁边。
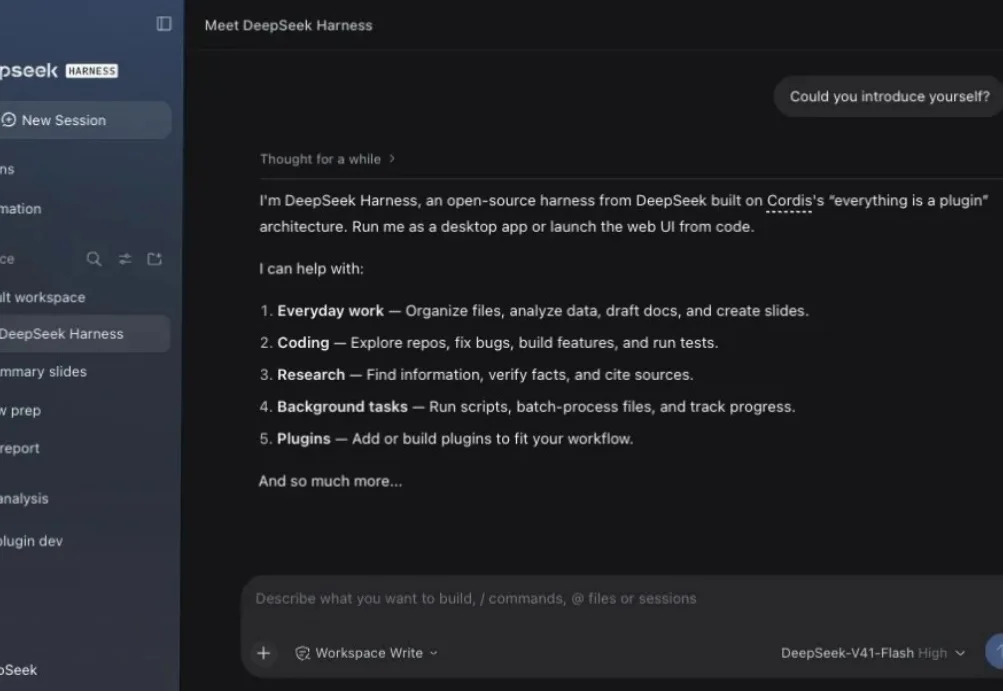
AI 兴盛以来,有许多路线争论,比如是垂类 AI vs 大而全,比如套壳vs模型,也比如 CLI(命令行) vs GUI(图形界面)、
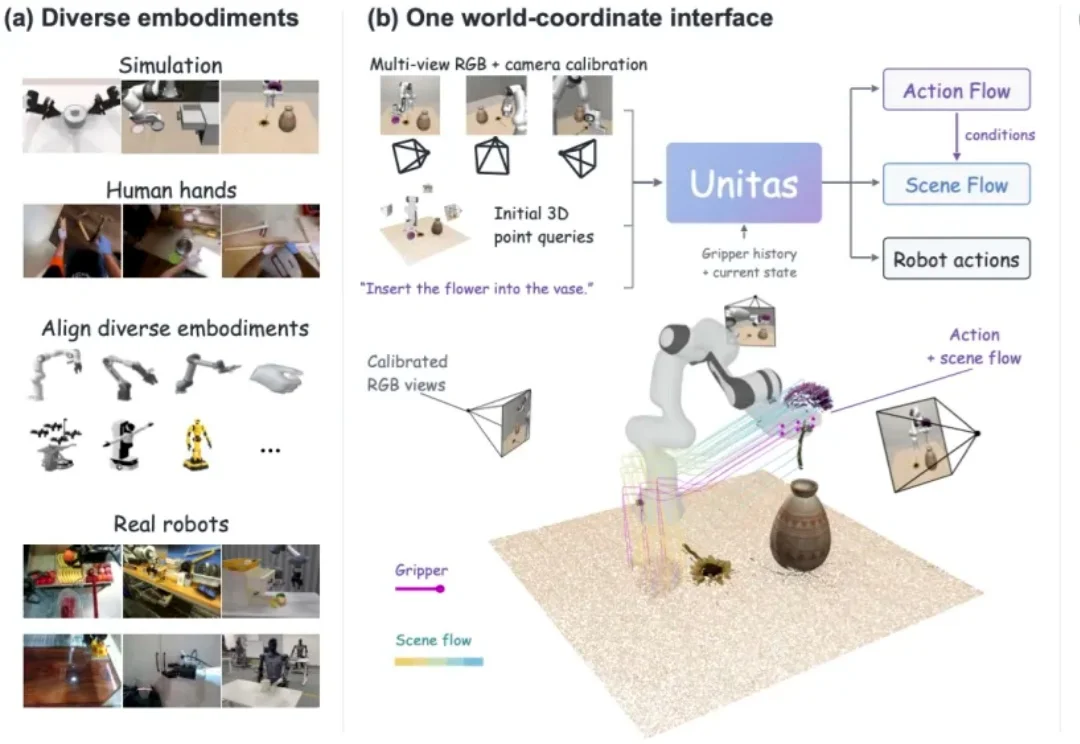
大语言模型为什么能 scale?一个重要基础是,海量来源各异的知识,被统一进了同一种输入输出空间 —— 文本。输入是文本,输出也是文本,主干模型在这个统一空间中学习、组合与迁移知识。那么,具身智能要获得类似的泛化能力,通往 Physical AGI,它的 “原生统一空间” 是什么?
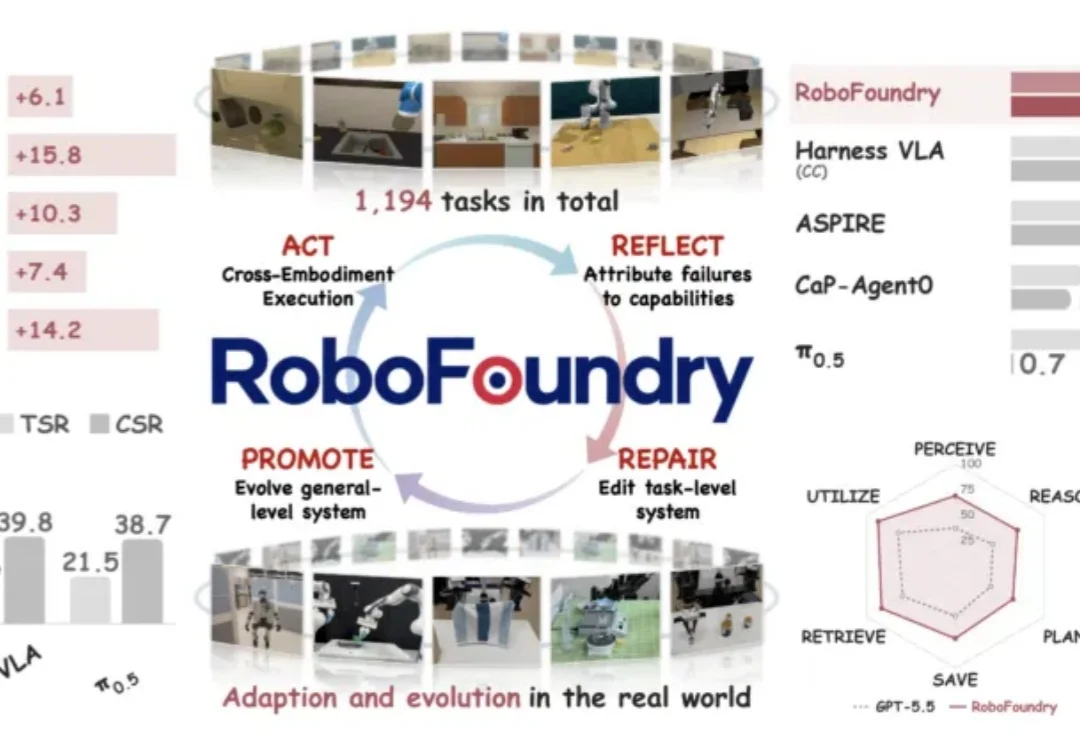
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
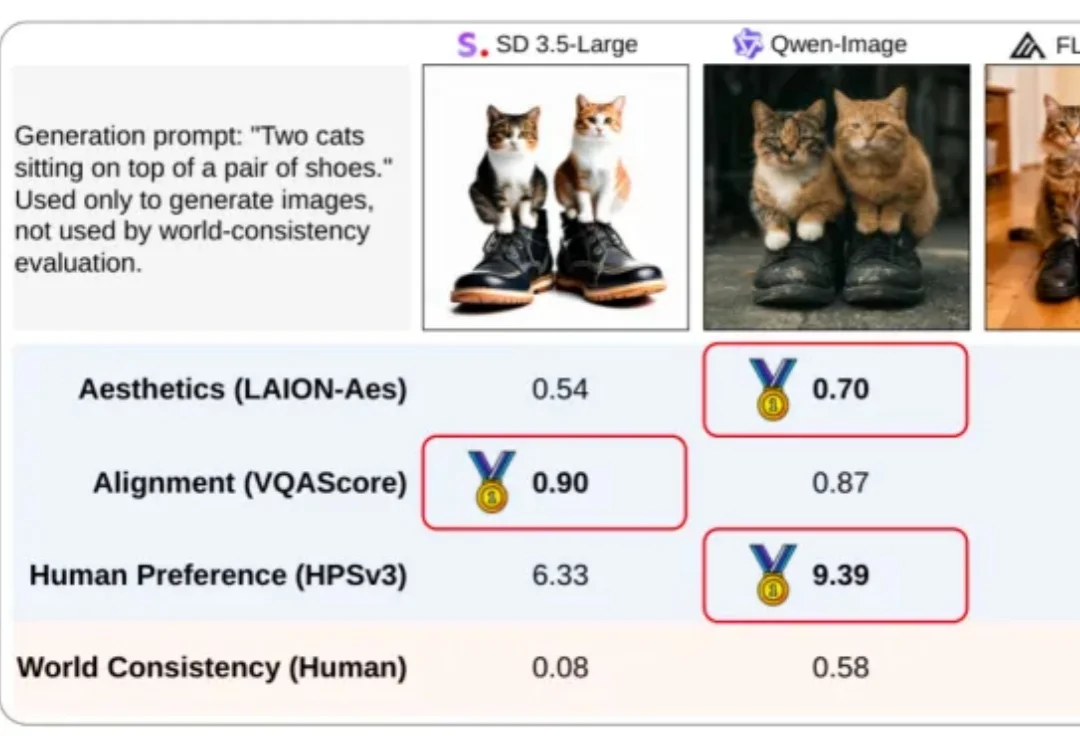
一张 AI 生成的图,可以在美学、提示词对齐和人类偏好指标上拿到高分,画面里却藏着扭曲的肢体、相互穿透的物体,或不合理的物理现象。这些错误,并不总能从现有分数中看出来。
DeepSeek 连自己官方开源的推理代码都能写错,而且错得相当有规律。
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。