GLM-5.3-FlashX 上线:200 tokens/s
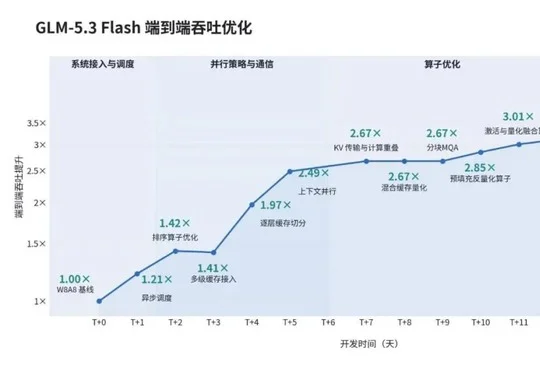
GLM-5.3-FlashX 上线:200 tokens/s智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
搜索
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
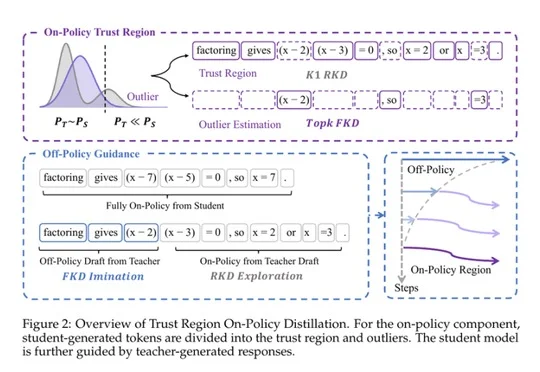
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
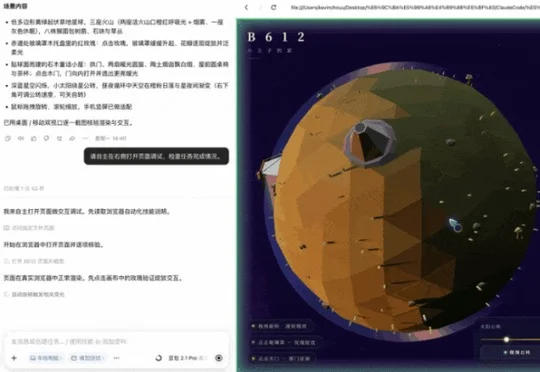
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
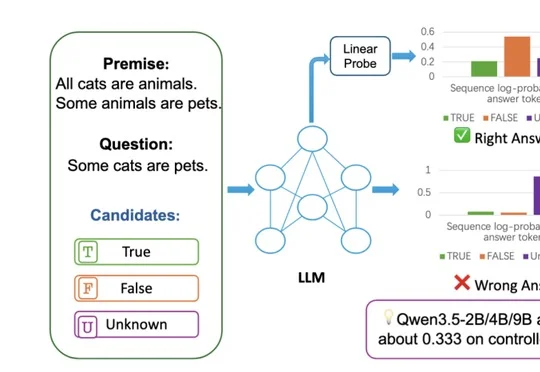
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
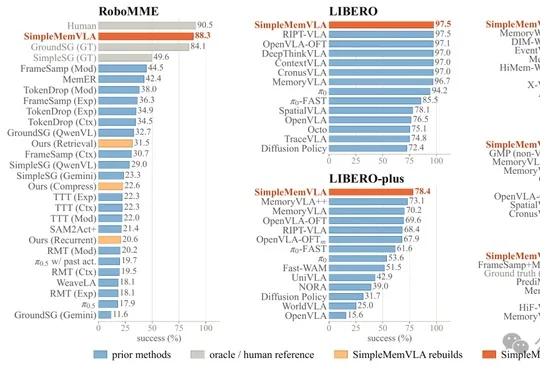
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。
WPS Comate把企业几十年积累的文档、数据和经验沉淀为AI可调用的上下文,已在中船动力、黄埔文冲、奇瑞等制造企业落地,推动企业AI竞争从模型选型转向上下文工程。
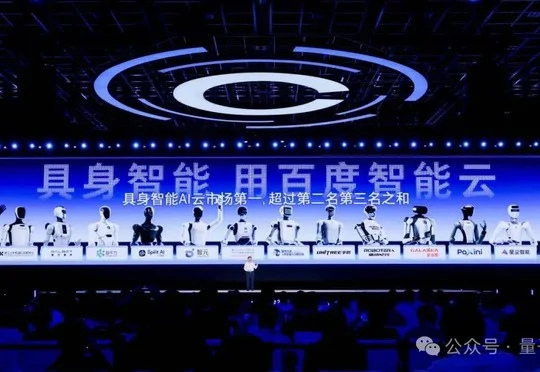
在具身智能技术路线尚未定型的阶段,基础设施需求正率先收敛,百度智能云以百度百舸AI计算平台为核心,为超过50家具身智能企业提供涵盖模型迭代、数据生产和跨本体部署的全栈AI云支撑,并在《中国具身智能云市场份额报告,2025》中以29.55%份额位居第一。
9 月 18 日,阿里达摩院联合浙江大学医学院附属第一医院等机构研发的通用医疗影像模型 DAMO RADAR 登上《Science》正刊,并正式对外开源。这也是近年来中国 AI 模型罕见登上《Science》正刊。
Kimi发布编程工具Kimi Code桌面版,原生适配macOS和Windows,内置Kimi K3模型并支持第三方API接入及Computer Use功能,提供99至699元三档订阅套餐,实测体验流畅。