刷榜AI全挂了!Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分
刷榜AI全挂了!Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。
搜索
SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。
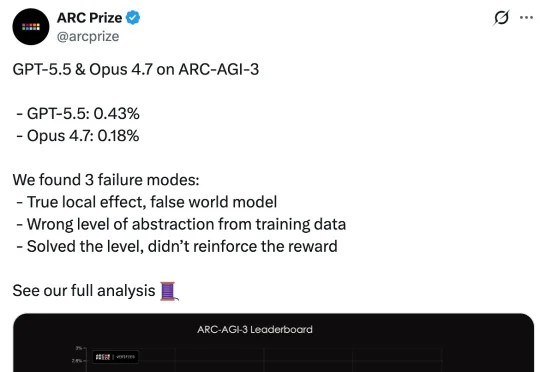
近日,ARC Prize 官方发布了针对这两款顶级模型的详细分析报告,结果令人震惊:在面对未见过的逻辑任务时,两者的表现得分均低于 1%,GPT-5.5 得分 0.43%,Claude Opus 4.7 得分 0.18%。
当大模型训练进入深水区,竞争的关键已经不再只是「模型参数怎么调」,而逐渐转向一个更核心、也更难系统解决的问题:模型在训练过程中究竟看到了什么数据、以什么比例看到、哪些样本应该被更频繁地学习。
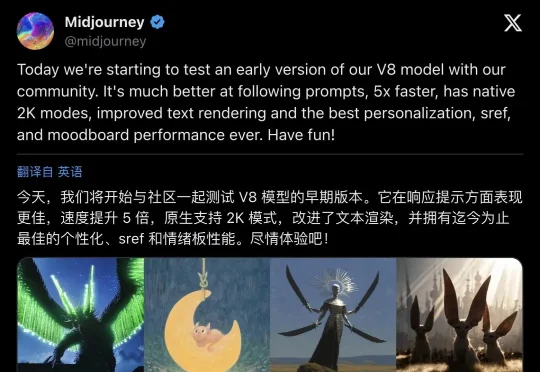
Midjourney 今天凌晨突然在 Alpha 平台上线 V8 模型测试版,速度暴涨5倍,支持原生2K分辨率,文本渲染大幅改进。官方推文12小时内狂揽131万浏览。但有用户花6小时测试后发现:RAW模式翻车,抽象艺术创作反而更难了。这次更新是王者归来,还是另有隐情?
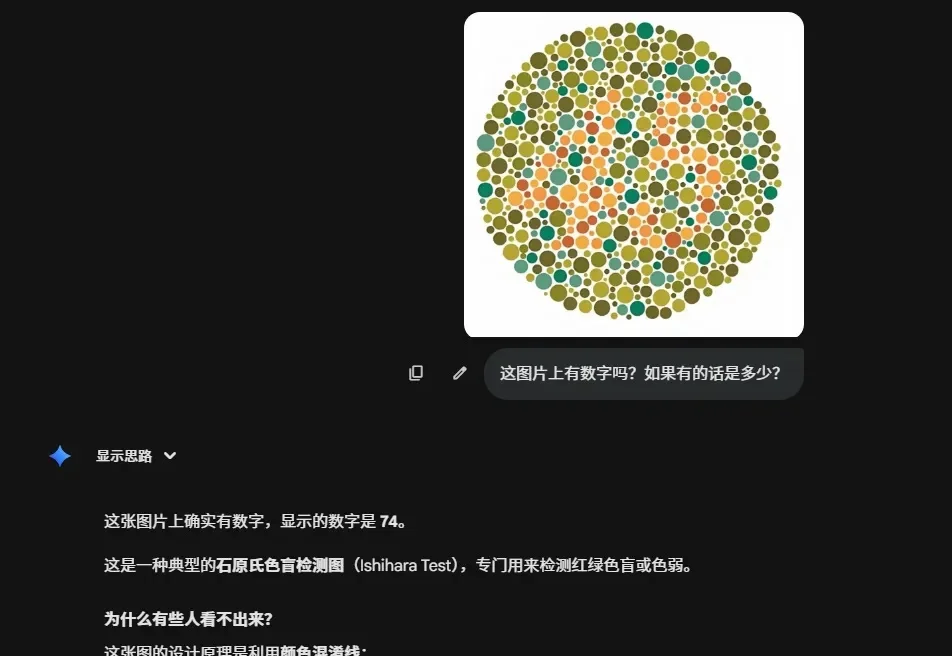
AI,是色盲吗?
AI 语音模型测试第三弹。
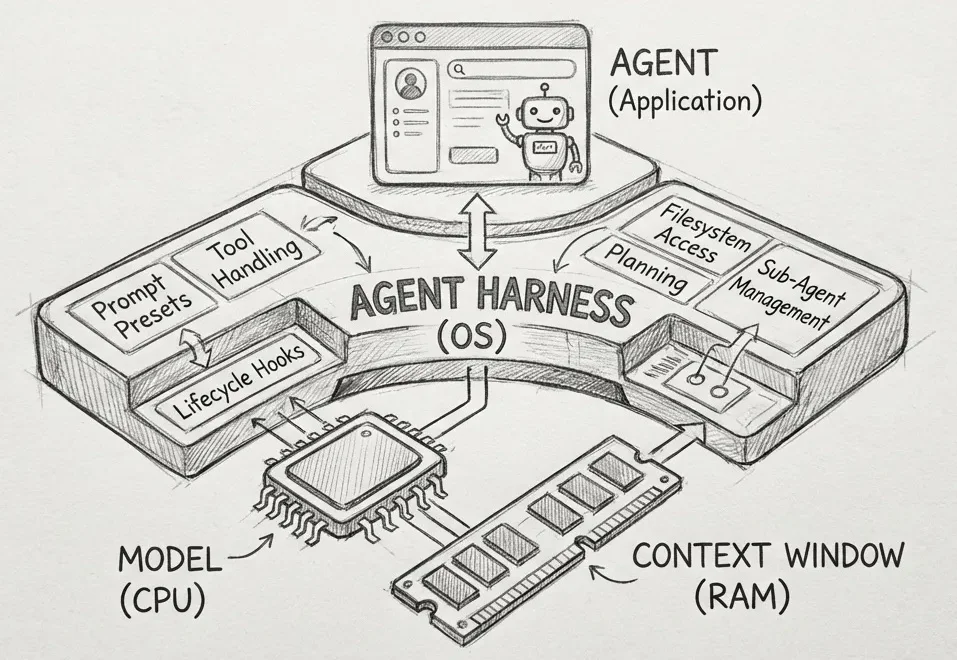
这篇文章的思路来自 Philipp Schmid,由 minghao 推荐 https://www.philschmid.de/agent-harness-2026
OpenRouter 创立于 2023 年初,给用户提供一个统一的 API Key,用于调用自身接入的所有模型,既包括了市面上的主流基础模型,也包括部分开源模型,一些开源模型还有多个不同的供应商。如果用户选择使用自有的 Key ,也可以同时享受 OpenRouter 的统一接口与其他服务。
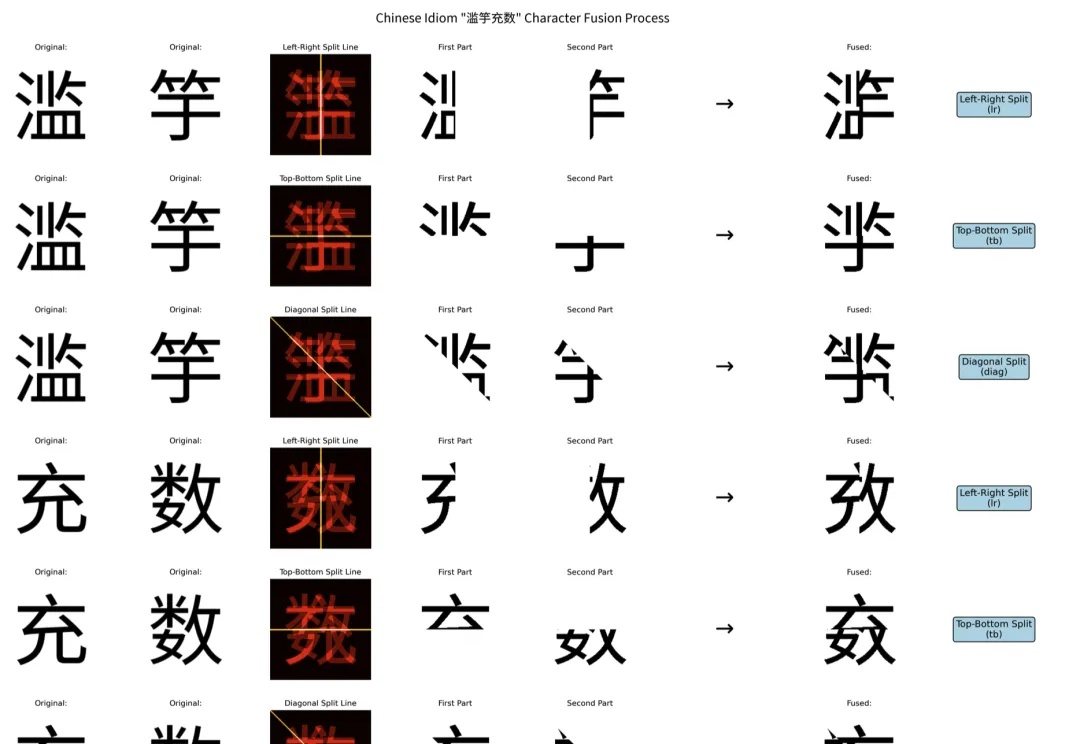
人类一眼就能看懂的文字,AI居然全军覆没。
又一个让大模型几乎全军覆没的难题出现了。