直播中|Claude垫底,GPT表现不佳,PhAI Labs用DiscoveryRSI探索科研Agent自我进化
直播中|Claude垫底,GPT表现不佳,PhAI Labs用DiscoveryRSI探索科研Agent自我进化Claude,竟然排在最后?
来自主题: AI技术研报
8928 点击 2026-10-19 16:20

 搜索
Claude,竟然排在最后?
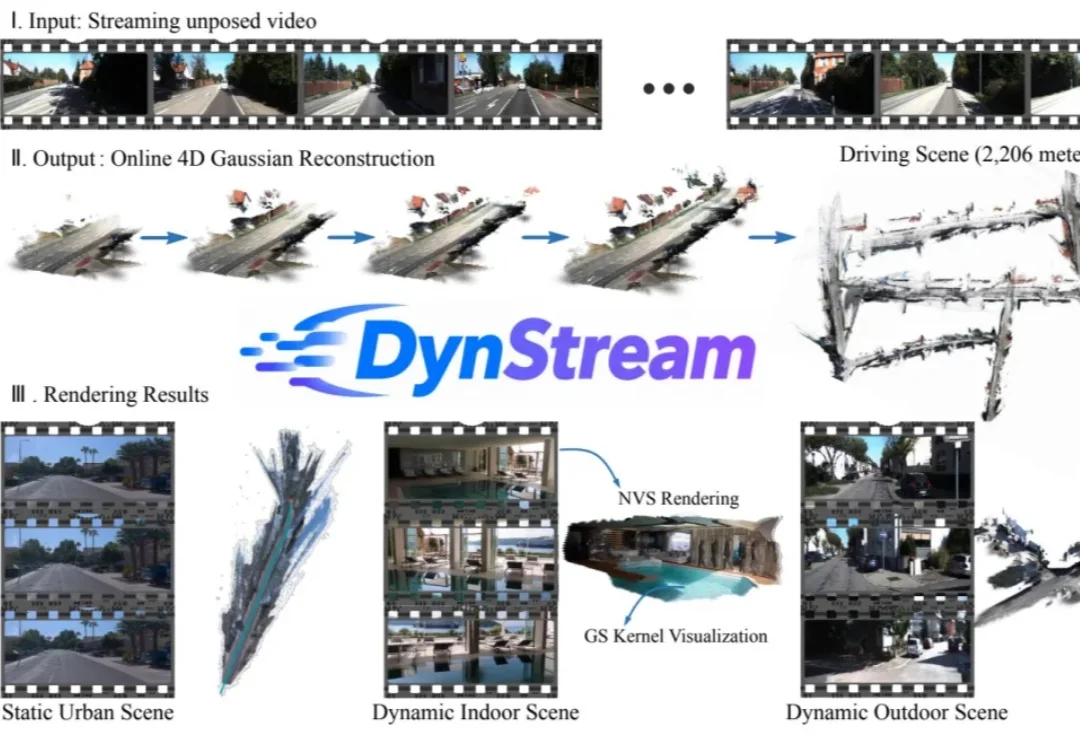
随手拍一段街景,镜头在移动,行人在穿行,街道上的车也在开。如果要边拍边重建这个变化的三维场景,麻烦就来了:未来画面还没到,如何分清哪些变化来自相机移动,哪些来自物体运动?随着镜头不断向前,如何将前一分钟重建的街道与后一分钟看到的路口准确拼接,避免场景错位或动态物体留下重影?当视频源源不断地输入时,系统又如何避免重复计算,让重建始终跟得上拍摄速度?
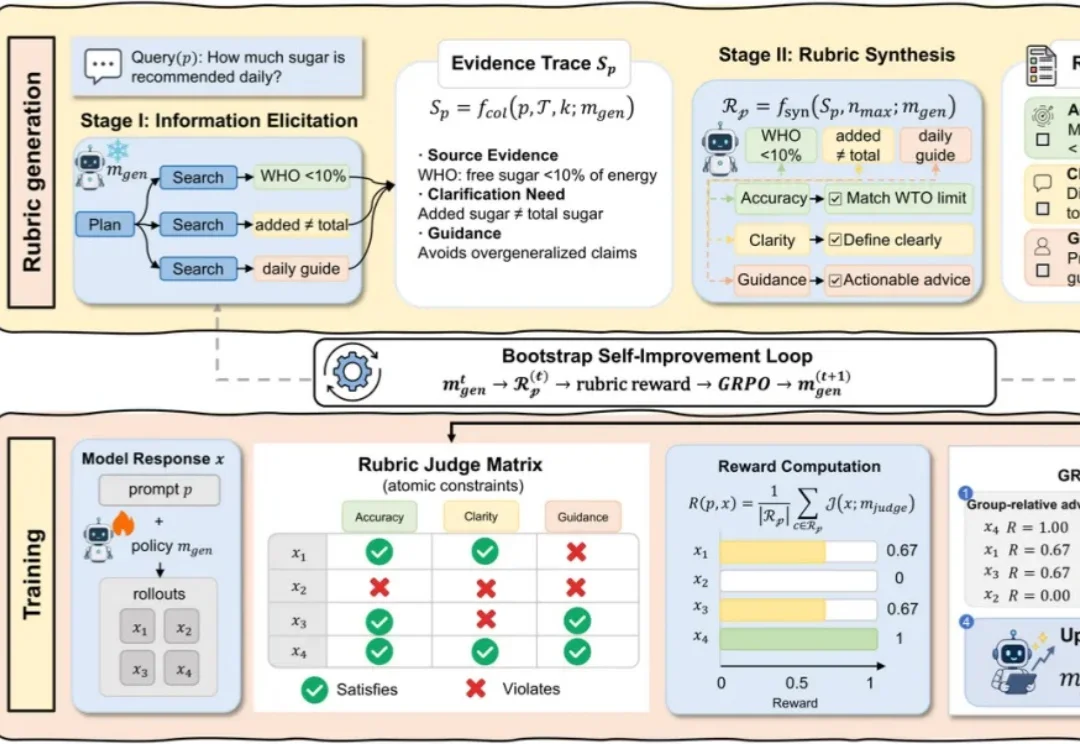
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
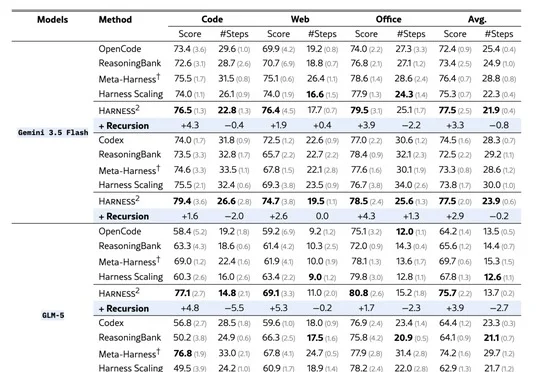
谷歌开源Harness²递归自我改进项目,使大模型无需修改权重即可自主优化外围脚手架,单步改进让GLM-5在WorkBuddy-Bench上提升11.5分。
都知道跨学科才能拿大结果,可啃完全陌生的领域又太烧心?
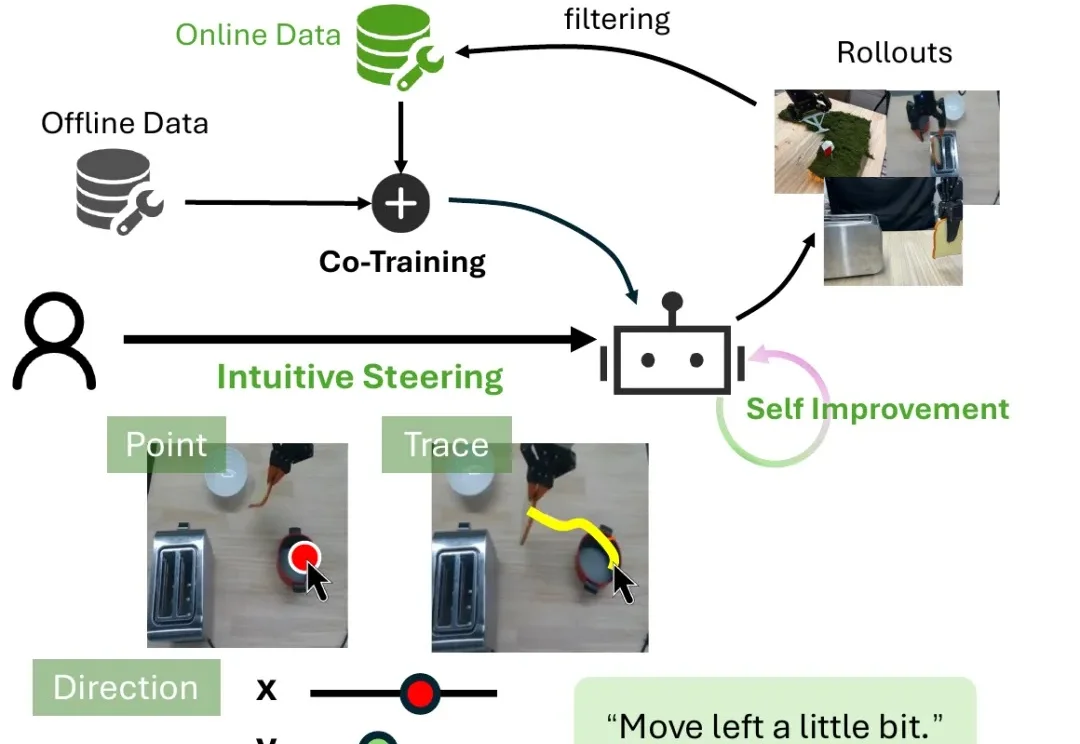
看着机器人抓偏了杯子、迟迟对不准面包机的插口,人们可能会忍不住提醒:“往左一点,再往前一点。”这些对人类来说再简单不过的调整,对机器人却未必容易。
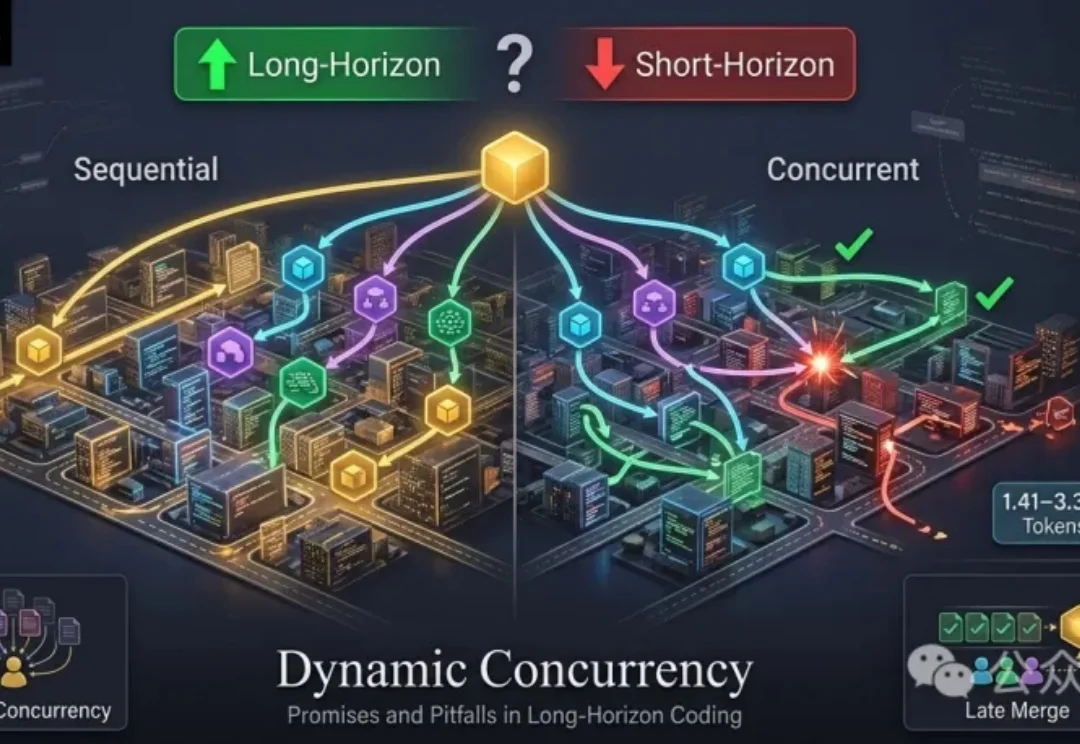
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
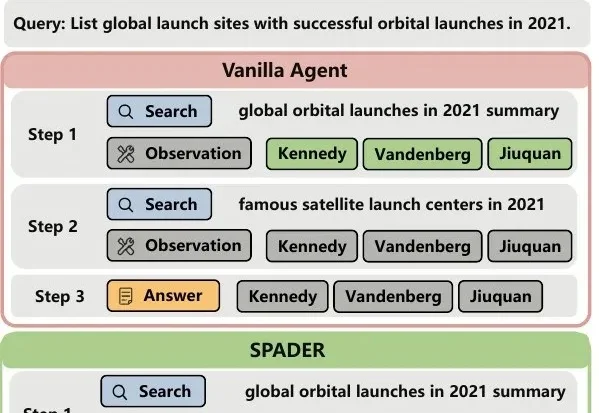
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
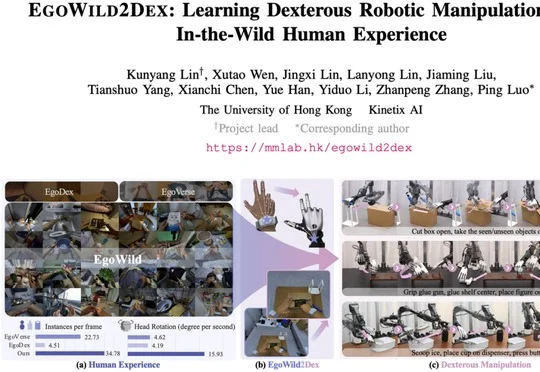
香港大学MMLab团队提出EgoWild2Dex,利用538.9小时真实人类第一视角数据训练机器人,每个下游任务使用不到1小时真机数据微调,拆快递、用热熔胶枪固定摆件和制作冰饮等任务的平均成功率达96.7%。
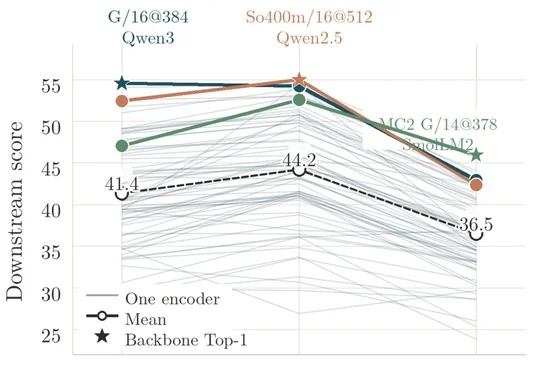
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。