谁领投了字节投毒实习生田柯宇
谁领投了字节投毒实习生田柯宇两年前因在字节跳动实习期间恶意篡改代码、干扰模型训练任务而被辞退,随后遭字节起诉索赔800万元的田柯宇,已经带着一家世界模型实验室重回牌桌。团队只有约 10 个人,没有公开公司名字,没有推出产品 demo ,完整模型预计要到 2027 年才发布,但已经融到近 3000 万美元,投后估值 2 亿美元。
来自主题: AI资讯
8709 点击 2026-10-16 12:06

 搜索
两年前因在字节跳动实习期间恶意篡改代码、干扰模型训练任务而被辞退,随后遭字节起诉索赔800万元的田柯宇,已经带着一家世界模型实验室重回牌桌。团队只有约 10 个人,没有公开公司名字,没有推出产品 demo ,完整模型预计要到 2027 年才发布,但已经融到近 3000 万美元,投后估值 2 亿美元。
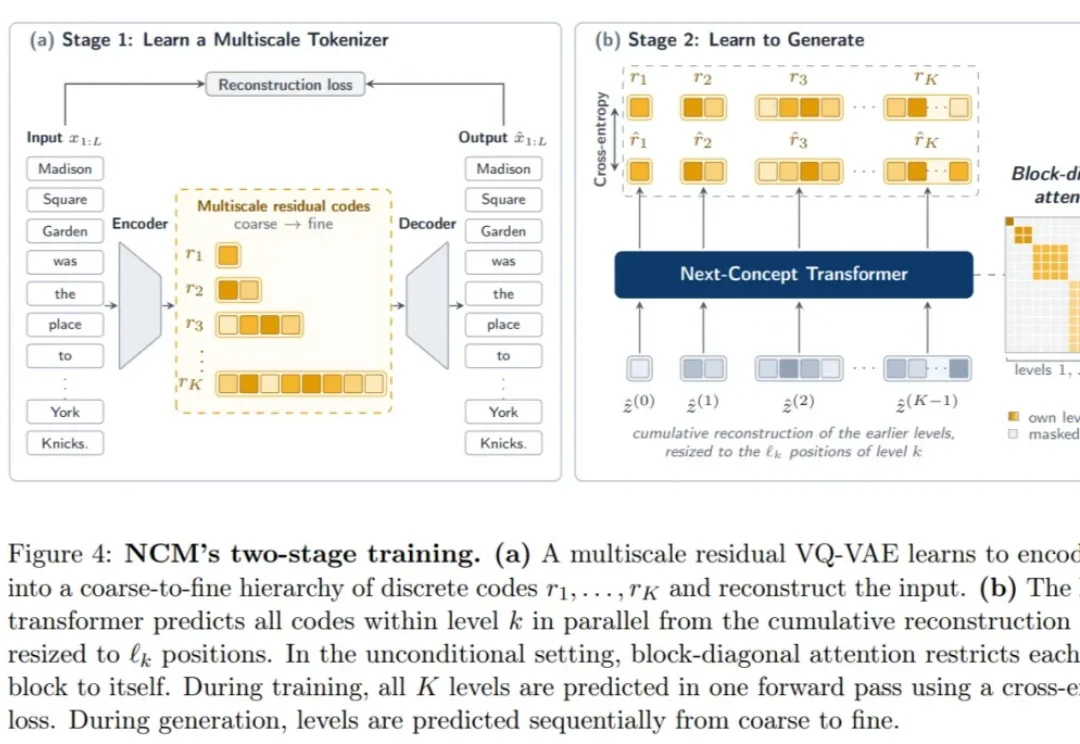
如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
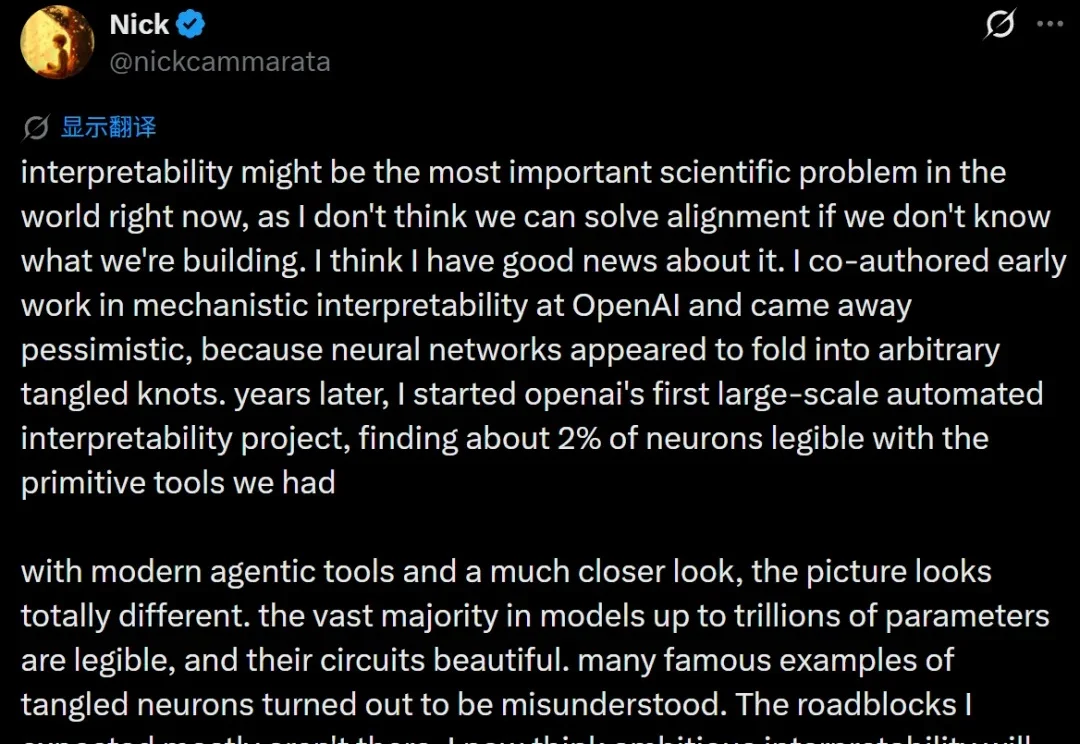
这是 AI 领域最重要的成果之一。
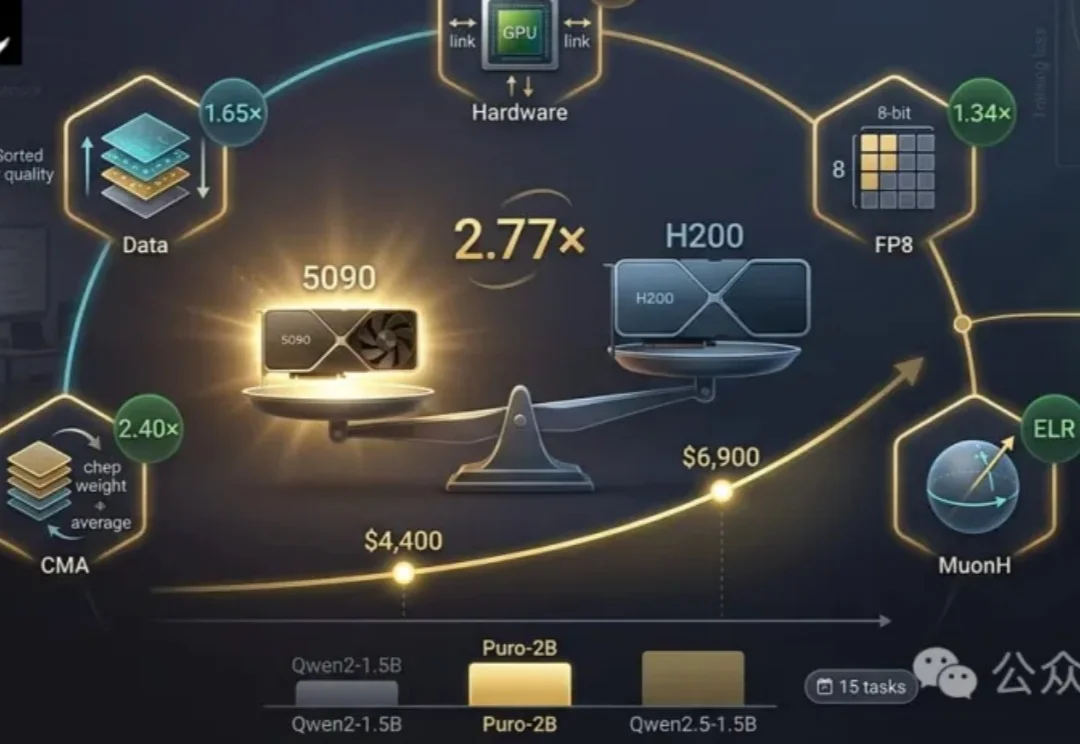
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
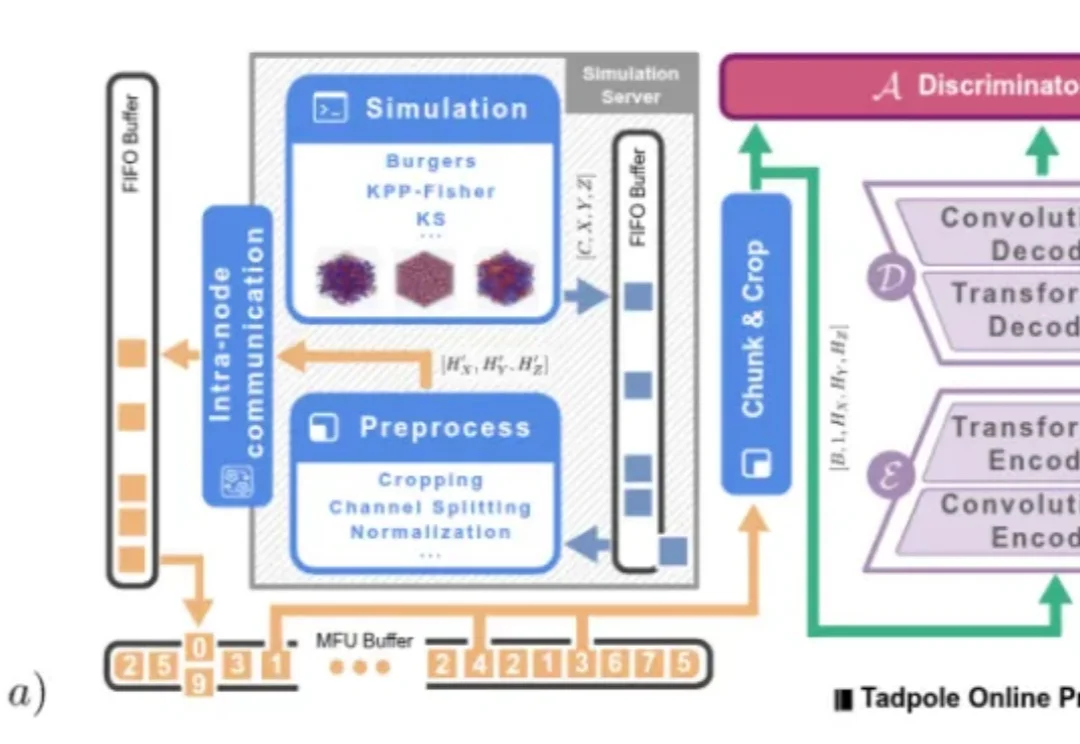
过去几年,“基础模型” 已经彻底改变了自然语言处理和计算机视觉。一个很自然的问题随之出现: 物理世界是否也能拥有类似的基础模型?
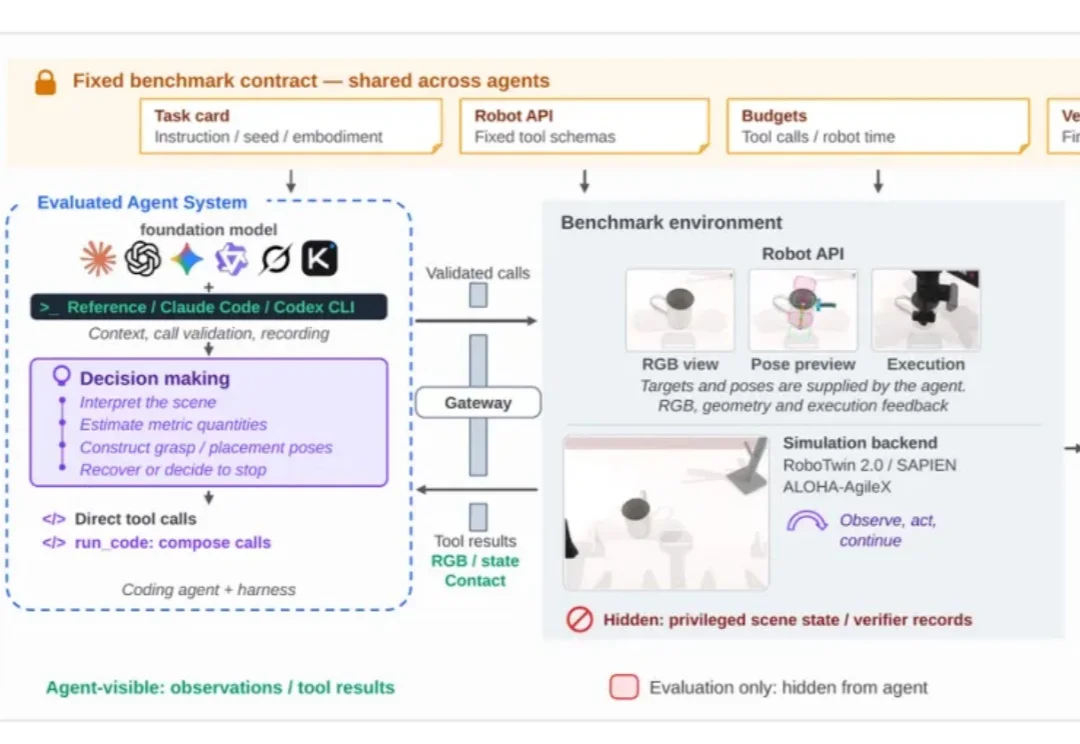
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
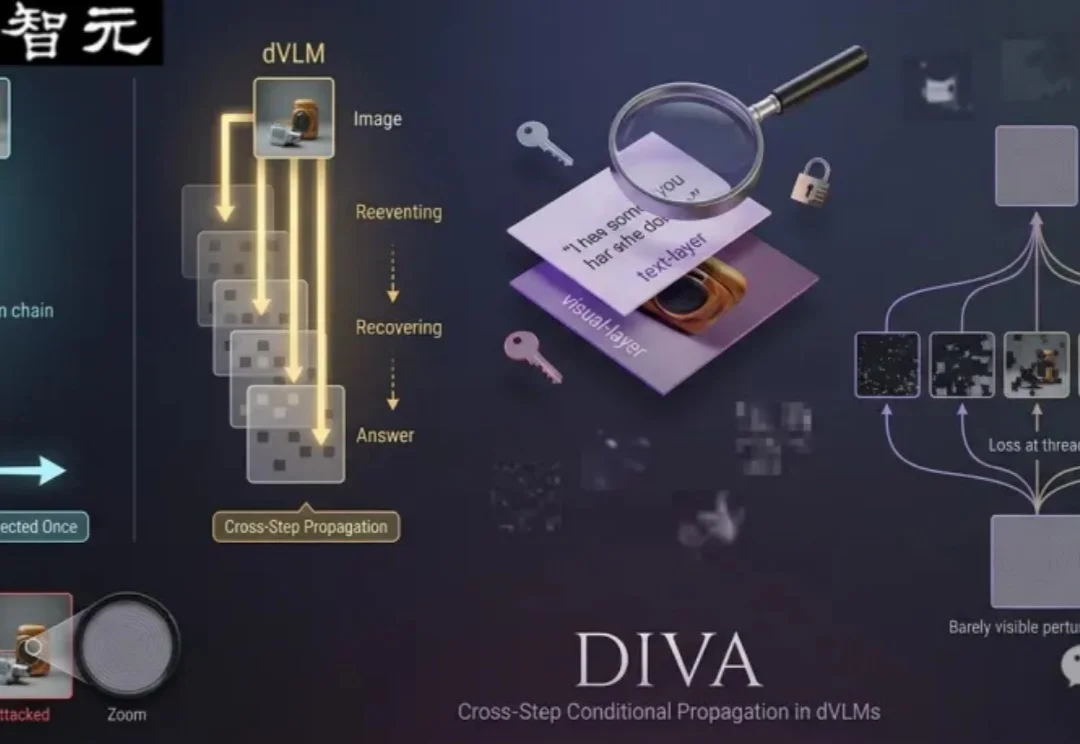
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
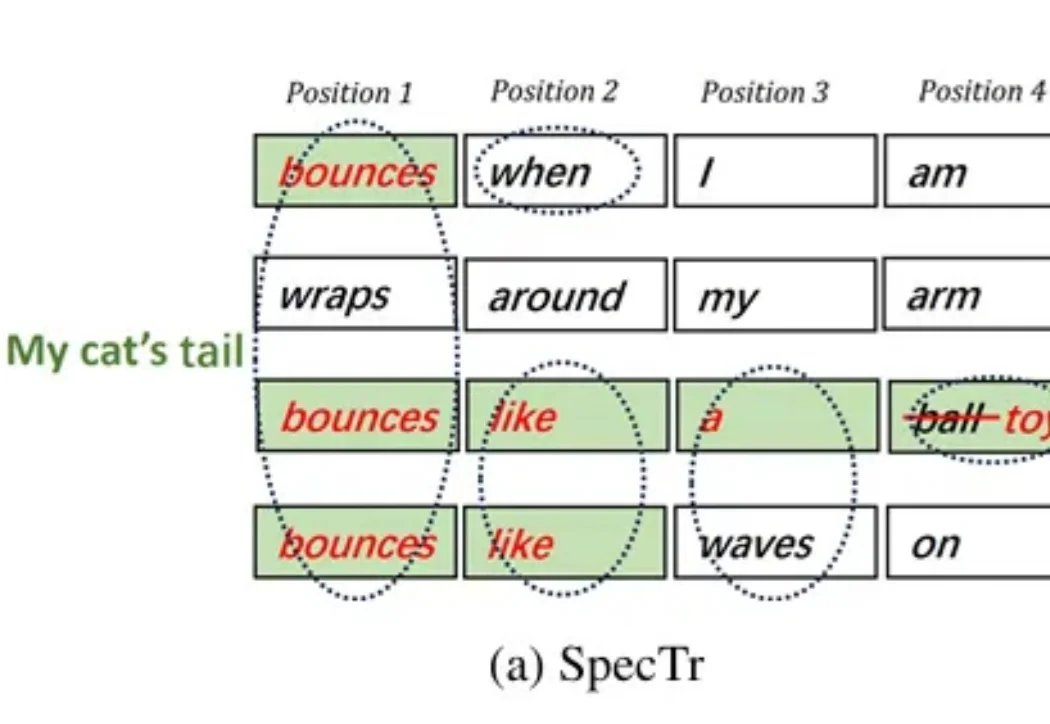
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
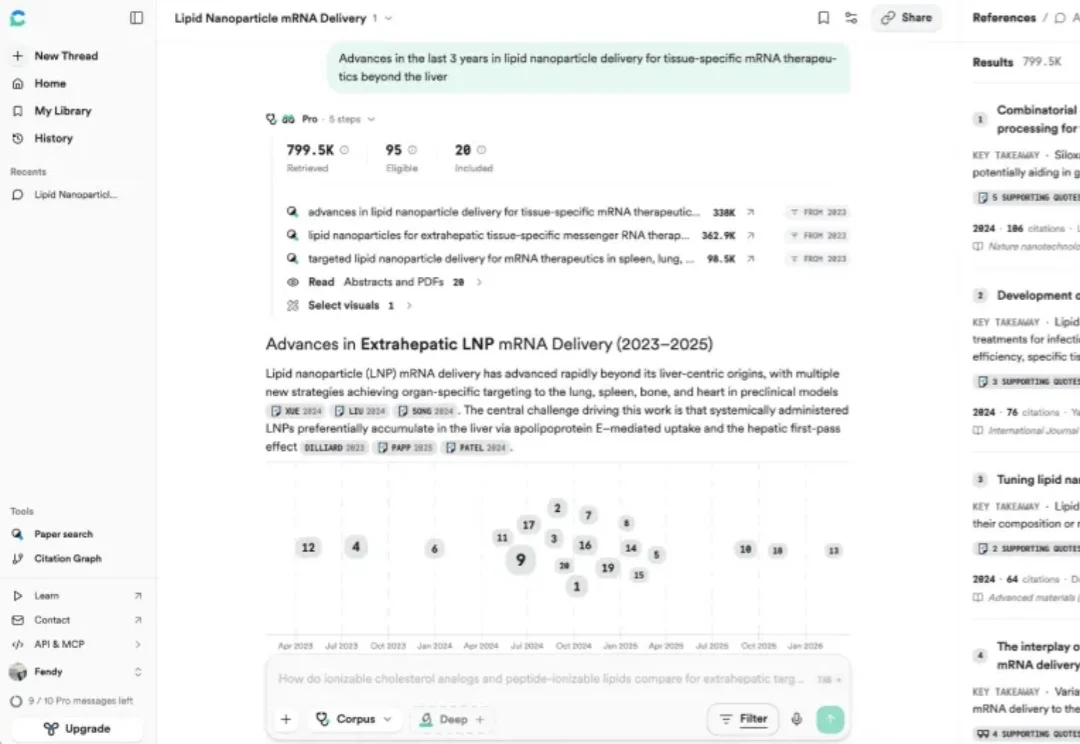
同样的一个问题,在不同学科中的表达与关键词,往往天差地别。
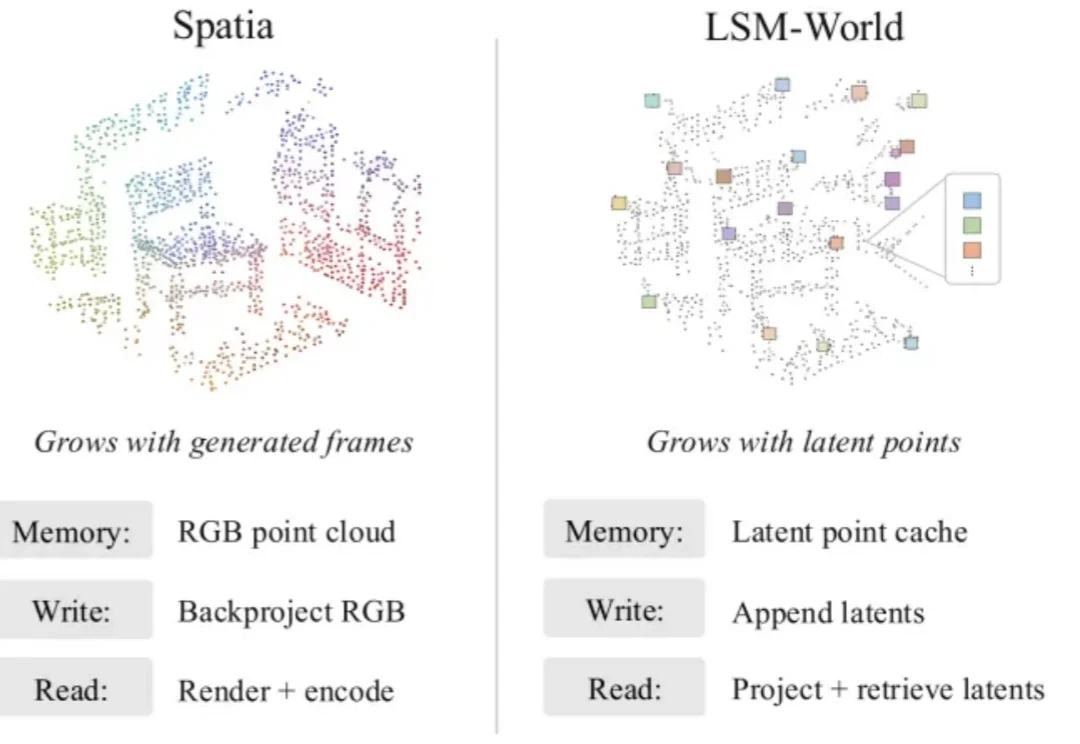
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?