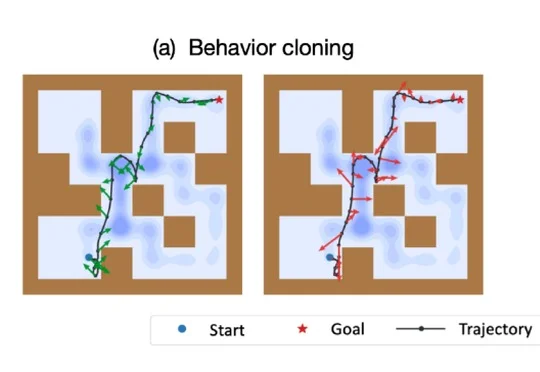
清华AIR提出高阶动作监督:聚焦一阶时序信息,10k小数据下增益显著 | NeurIPS'26
清华AIR提出高阶动作监督:聚焦一阶时序信息,10k小数据下增益显著 | NeurIPS'26清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。
来自主题: AI技术研报
9604 点击 2026-10-10 12:34

 搜索
清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。
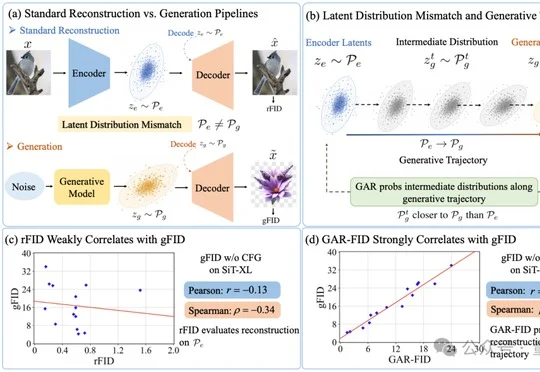
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
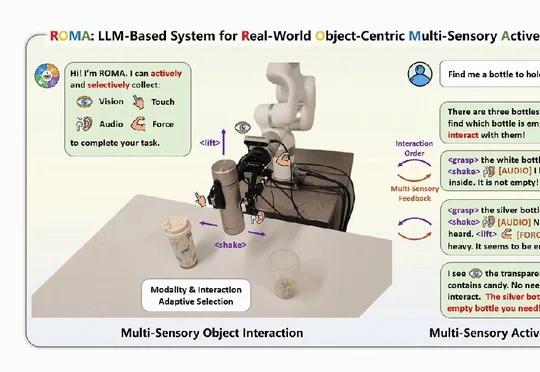
人大高瓴 GeWu-Lab、智源研究院与燧行 AresoX 等机构提出 ROMA,构建 ROMI-2K、ROMA Bench 及 ROMA-7B,使机器人融合视听触力主动探索物体,并在 ROMA Bench 上以 72.9% 总体任务成功率基本追平 GPT-6 Astra。
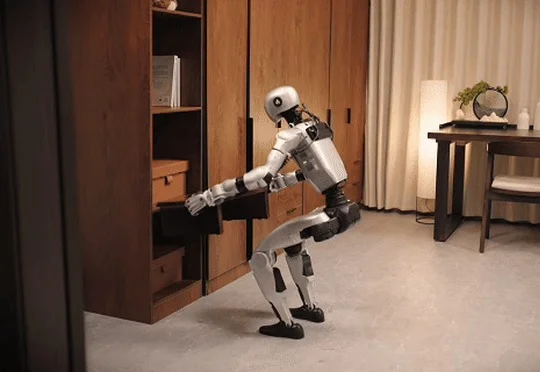
源策未来成立半年后首次系统性公开“全身智能”(WBI)实机成果,展示自研S0全身控制系统与S1模型在宇树 G1、加速进化 T2上的复杂地形控制、自主任务及跨本体验证。
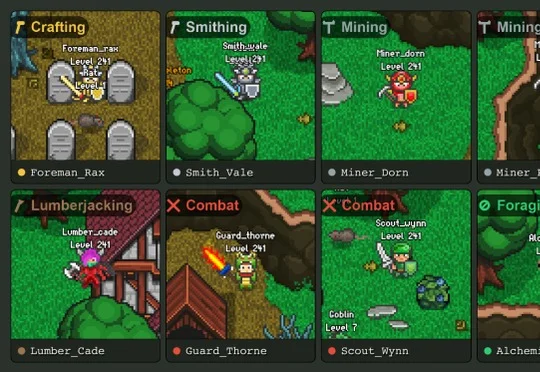
OpenAgents、哥伦比亚大学等研究者构建多智能体协作评测基准AgentWorld,评测显示主任务最高完整成功率为Gemini 3 Flash的52.0%,并提出CCE指标分析协作贡献。
DeepSeek的神鬼二象性被字节Seed团队逮到了。
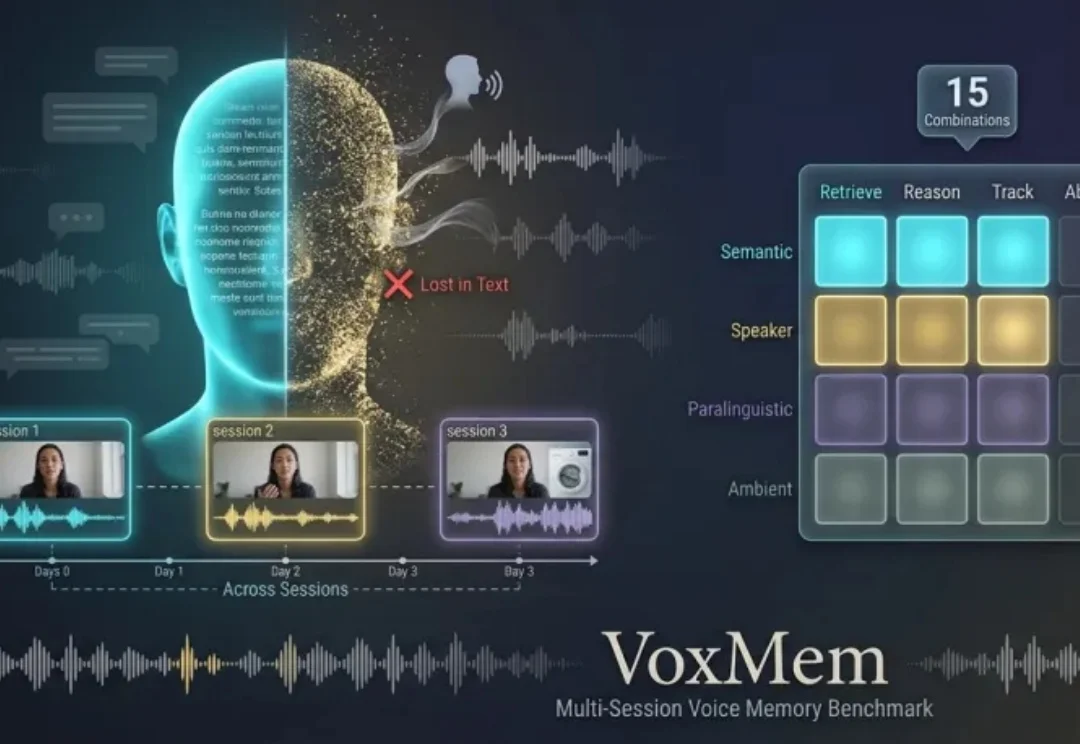
在语音助手、多用户共享的家庭助理等长期对话场景中,模型需要跨越多次会话记住用户的信息,但现有评测常遭遇两大难题:
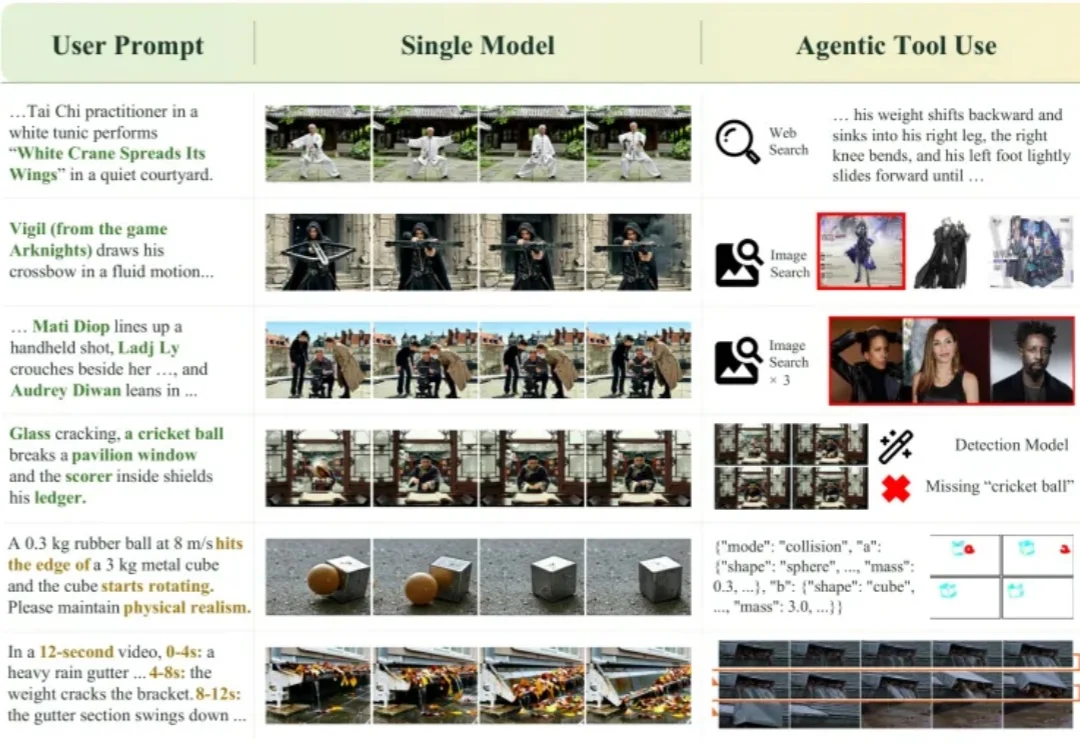
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
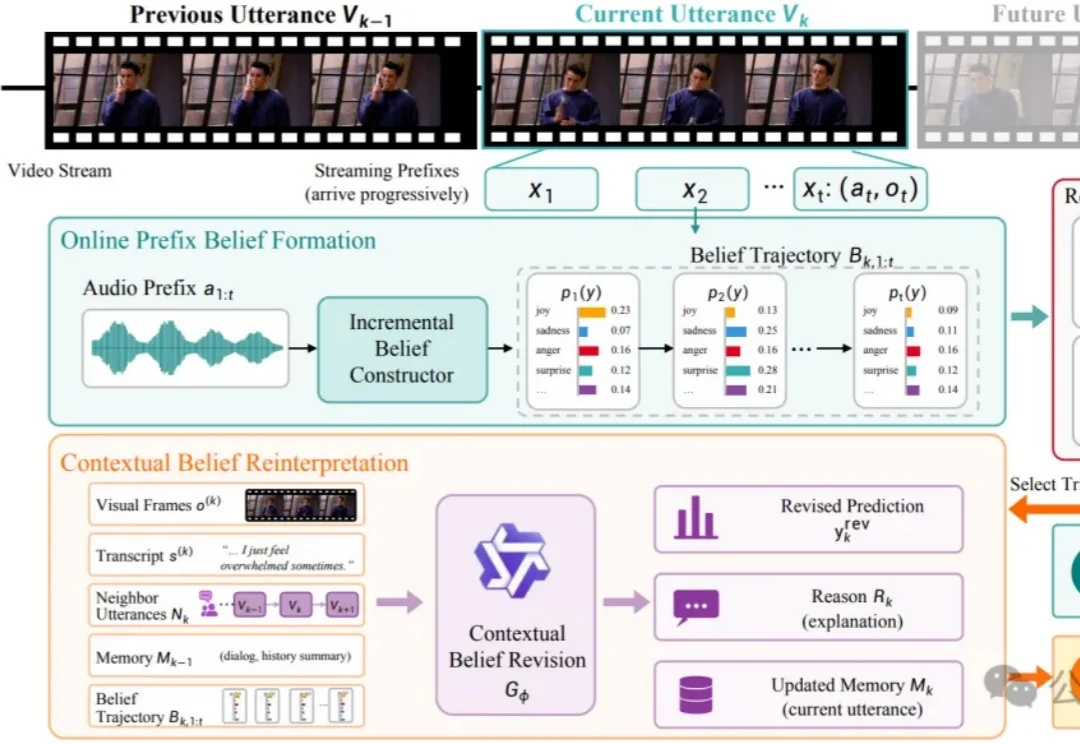
在与用户的实时对话中,AI能否及时感知情绪?模型给出的“高置信度”结论,又是否经得起推敲?
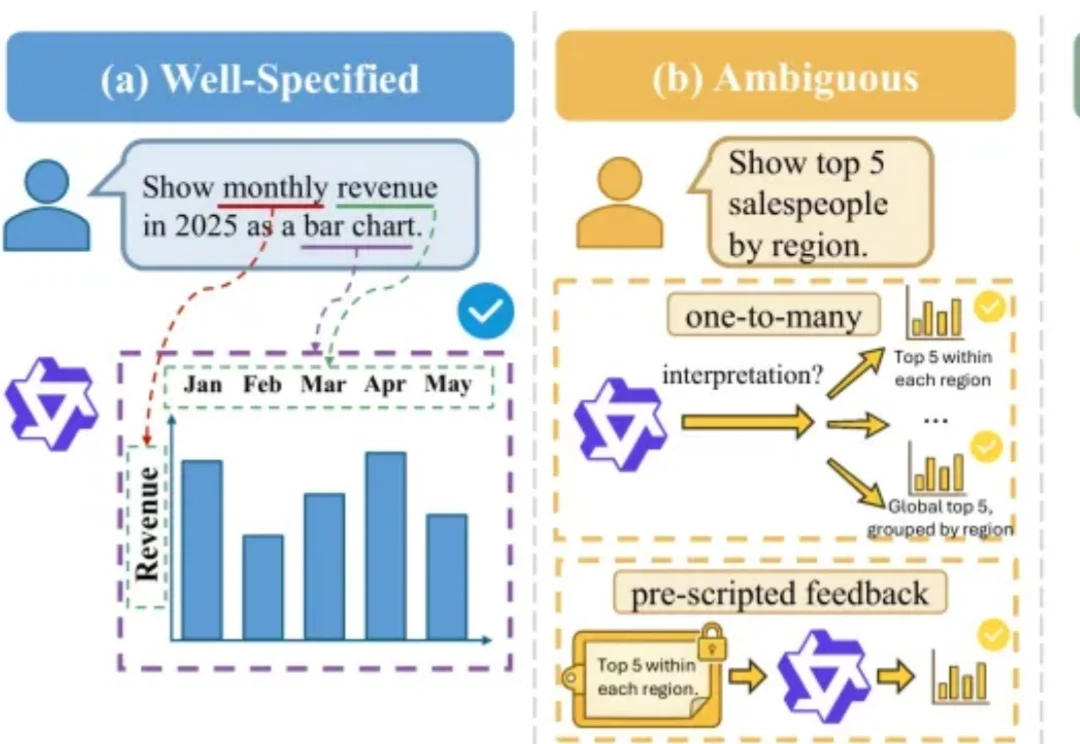
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。