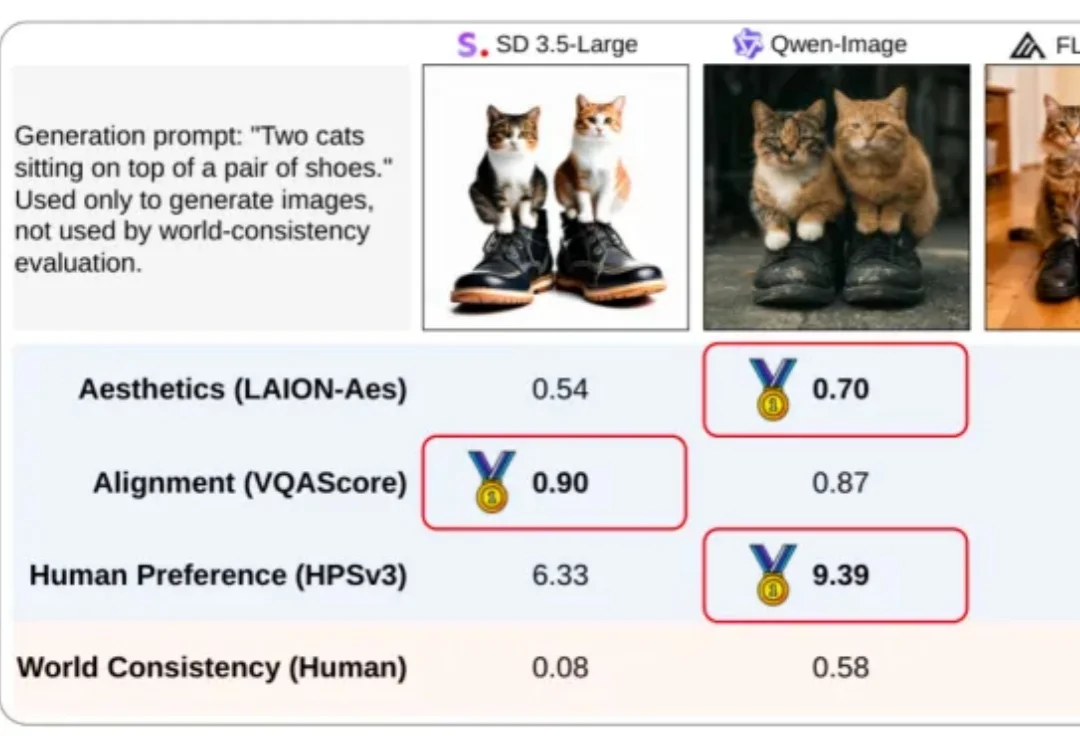
看着很真,细看不对?文生图「世界一致性」测评来了
看着很真,细看不对?文生图「世界一致性」测评来了一张 AI 生成的图,可以在美学、提示词对齐和人类偏好指标上拿到高分,画面里却藏着扭曲的肢体、相互穿透的物体,或不合理的物理现象。这些错误,并不总能从现有分数中看出来。
来自主题: AI技术研报
10150 点击 2026-10-13 10:04

 搜索
一张 AI 生成的图,可以在美学、提示词对齐和人类偏好指标上拿到高分,画面里却藏着扭曲的肢体、相互穿透的物体,或不合理的物理现象。这些错误,并不总能从现有分数中看出来。
DeepSeek 连自己官方开源的推理代码都能写错,而且错得相当有规律。
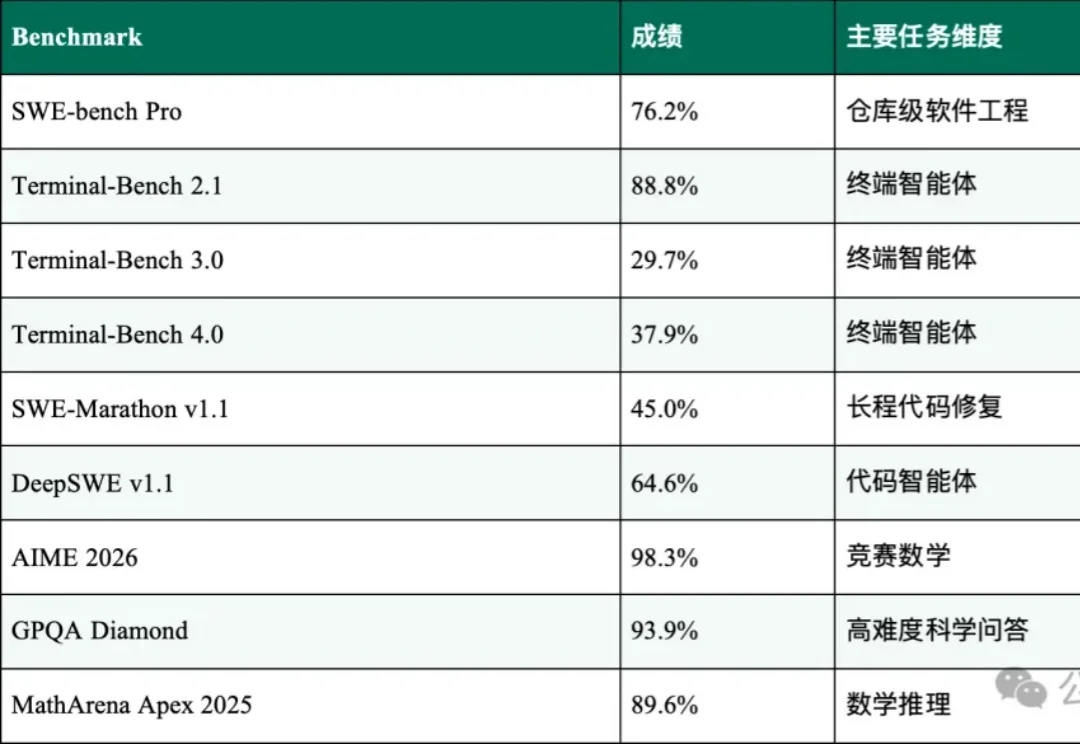
随着前沿模型进入长链推理、工具调用、代码修复与科研任务,一个关键缺口随之显现:模型不断生成和修改候选,但“新状态是否真的更可靠”不能只由模型自己判断。
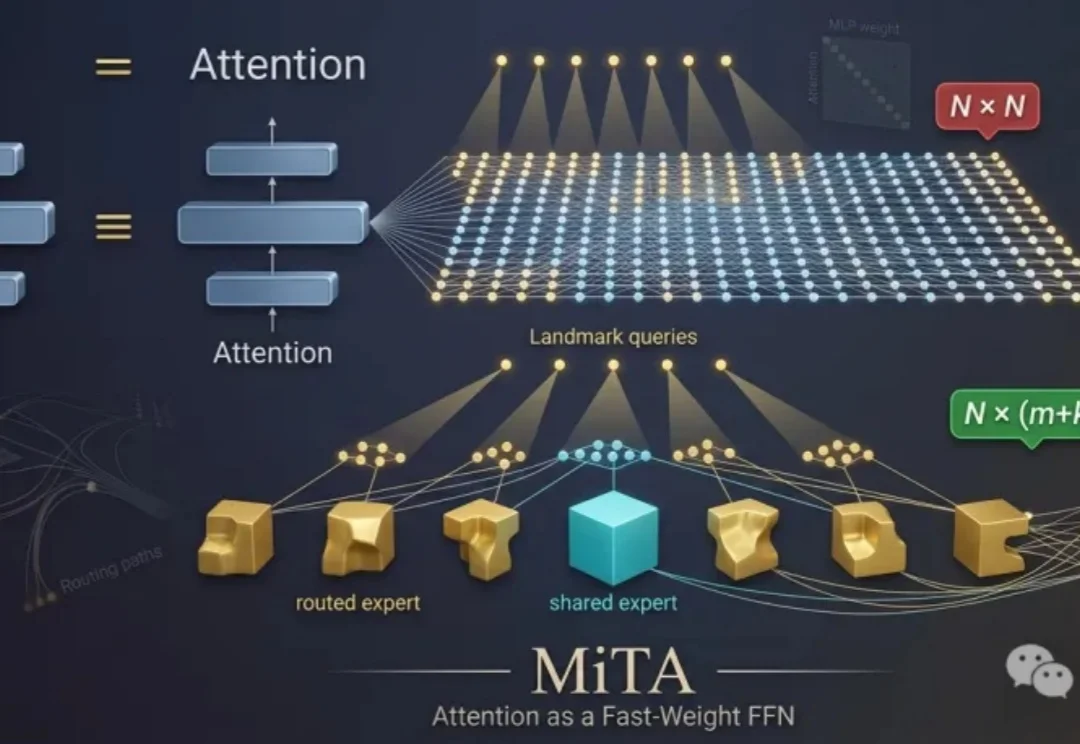
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
对着屏幕说一句 “向左转”,画面随即展开新的视野;调整角色的动作,场景紧接着给出反馈。多模态交互要求视觉生成跟上人的操作,而漫长的等待会打断整个体验。
近期,全球顶尖 AI 实验室正在密集释放一个信号:AI 正在从帮助人类完成任务,走向参与自身的研发与改进。
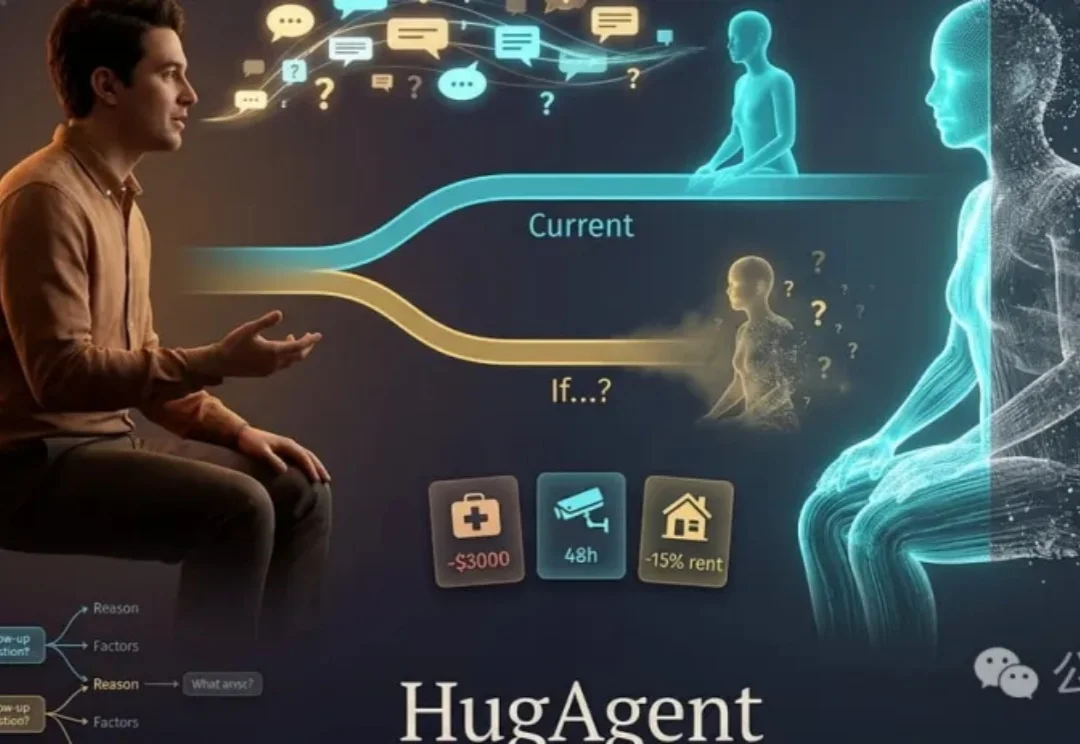
只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
2026年,Anthropic披露Claude已主导26%的研发,OpenAI宣布自动化研究实习生达标,智谱与MiniMax推进工程优化,但Weco AI的AIDE²实验尚未证明系统能提升自我改进能力。
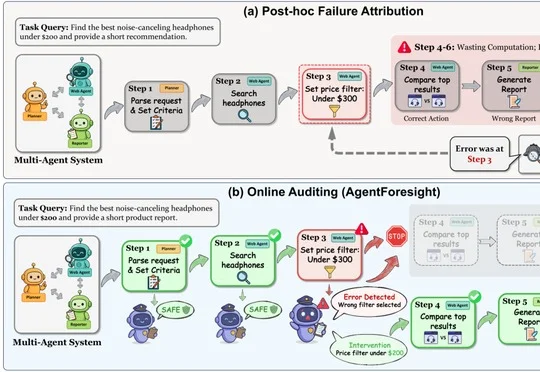
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。