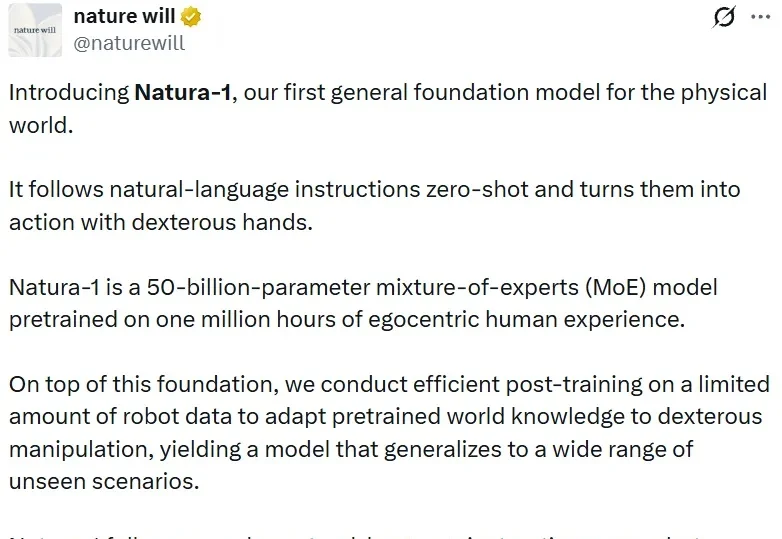
Natura-1发布:从百万小时人类经验中学会零样本泛化与灵巧操作
Natura-1发布:从百万小时人类经验中学会零样本泛化与灵巧操作包馄饨,对大多数人来说很简单:一手托皮,一手挑馅,对折,捏边,收口。很少有人意识到,这个过程里手掌始终在承托一张随时会变形的面皮,手指在不断感受馅料和面皮的回弹,两只手还要在恰当的时机交接。
来自主题: AI技术研报
7053 点击 2026-10-15 11:27

 搜索
包馄饨,对大多数人来说很简单:一手托皮,一手挑馅,对折,捏边,收口。很少有人意识到,这个过程里手掌始终在承托一张随时会变形的面皮,手指在不断感受馅料和面皮的回弹,两只手还要在恰当的时机交接。
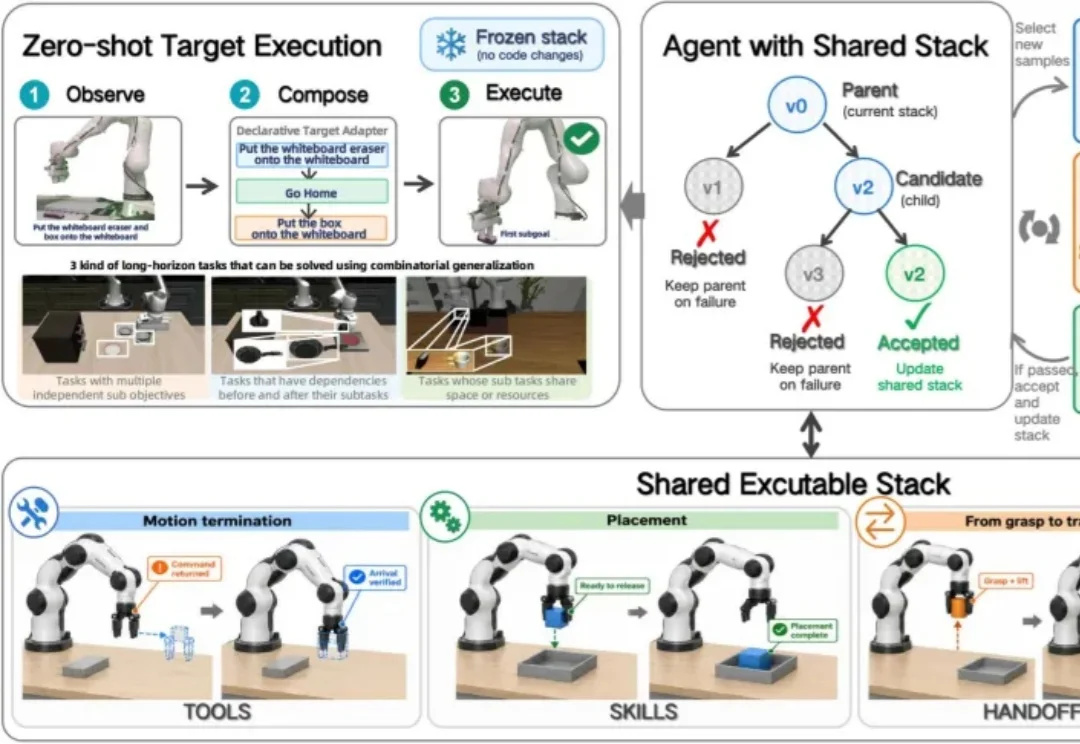
机器人 RSI 时刻远远未到达,先看一个动作:机械臂把碗放到盘子上,再抓起杯子,放进刚刚移动过的碗里。
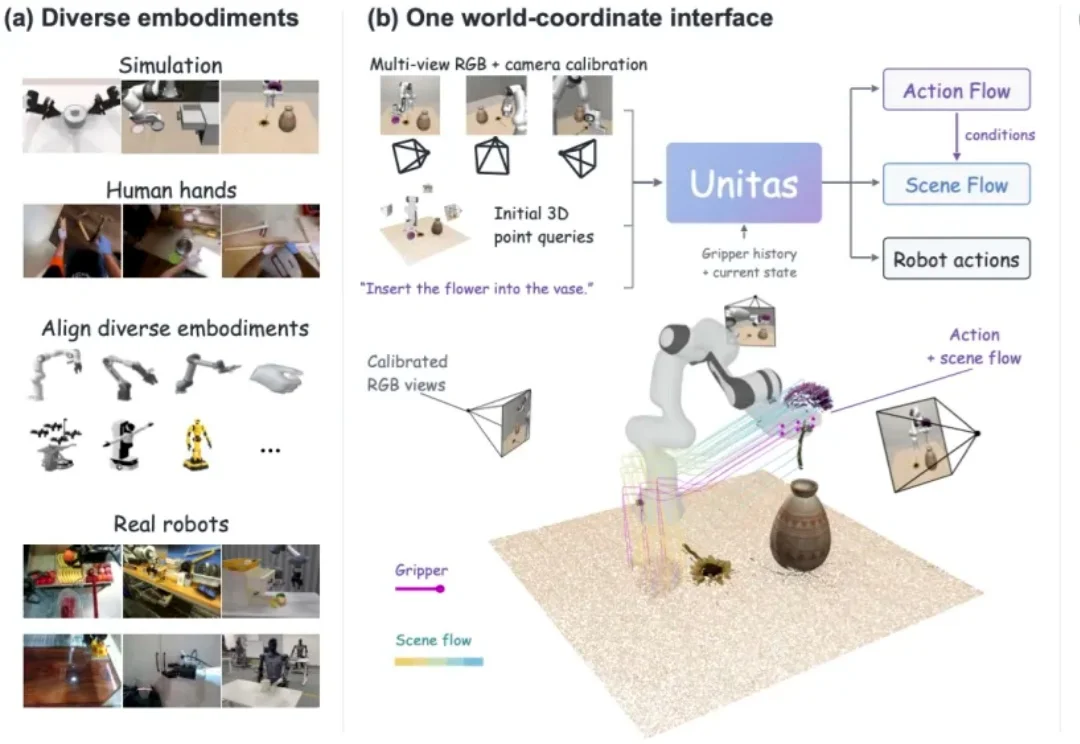
大语言模型为什么能 scale?一个重要基础是,海量来源各异的知识,被统一进了同一种输入输出空间 —— 文本。输入是文本,输出也是文本,主干模型在这个统一空间中学习、组合与迁移知识。那么,具身智能要获得类似的泛化能力,通往 Physical AGI,它的 “原生统一空间” 是什么?
Physical Intelligence联合创始人Sergey Levine指出,机器人尚未进入稳定缩放阶段,应以先验知识、有效决策循环和多样化数据提升泛化与可靠性,并在找到真正可规模化的技术后扩大投入。
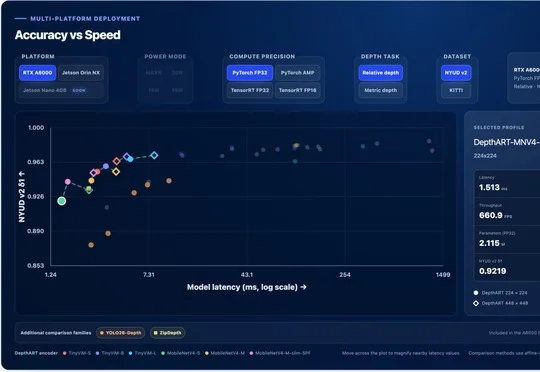
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
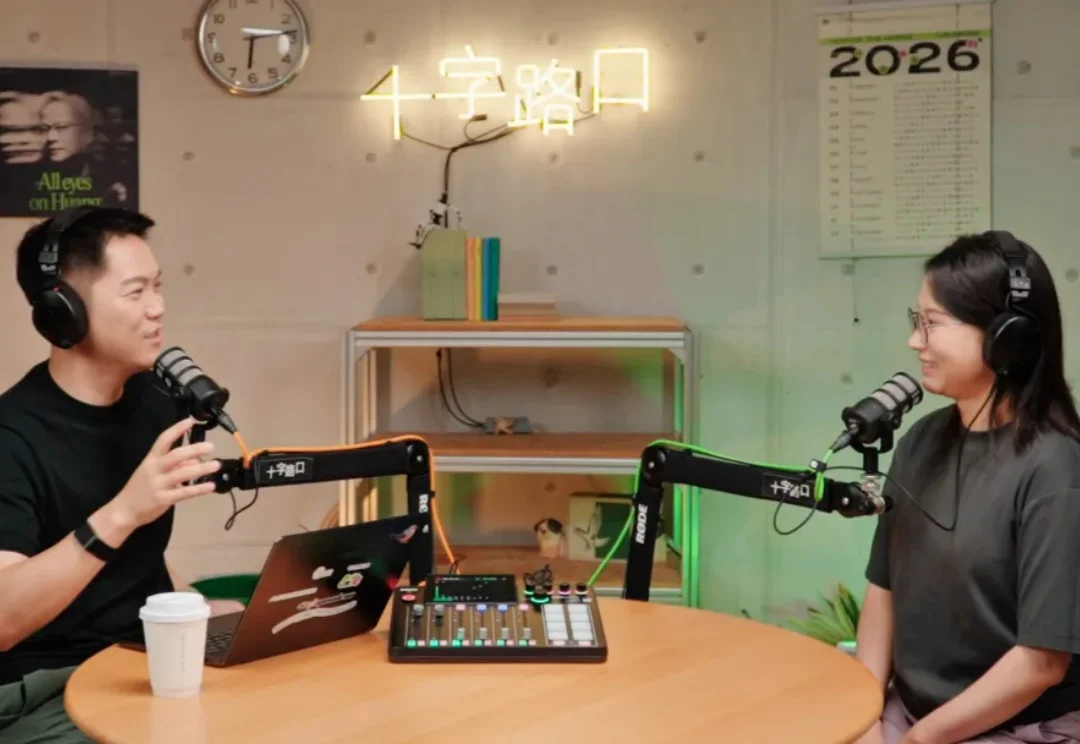
本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 In-Context Learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
灵巧手从 demo 走向真实应用,关键不只是 “会不会动”,而是能否在 noisy depth、稀疏触觉、外力扰动和未见物体下稳定泛化。现有 in-hand manipulation 往往依赖固定物体、定初始位姿或理想传感器。而一旦遇到真实深度噪声、形状变化和接触状态不可见,这些策略就容易退化成近乎开环的 “手指套路”。
长期以来,机器人系统大多依赖专有模型。
真正的智能,在于能否基于有限的数据,实现可靠的泛化与迁移。
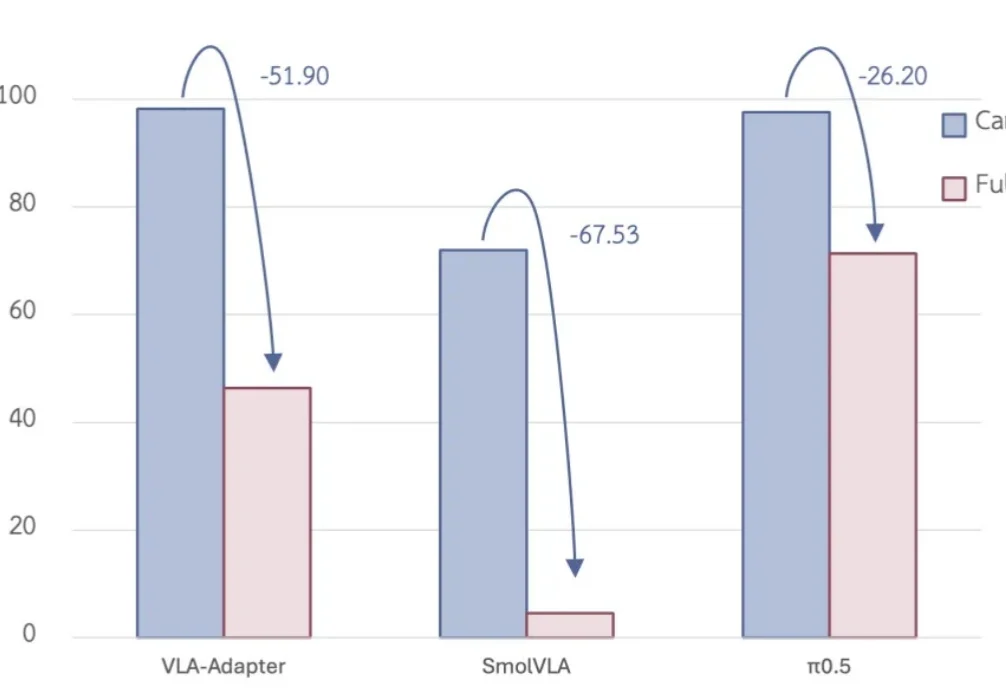
作为具身智能最主流的路线之一,VLA 快速发展的同时也因为其各种问题被诟病。其中最主要的痛点之一便是指令泛化能力。