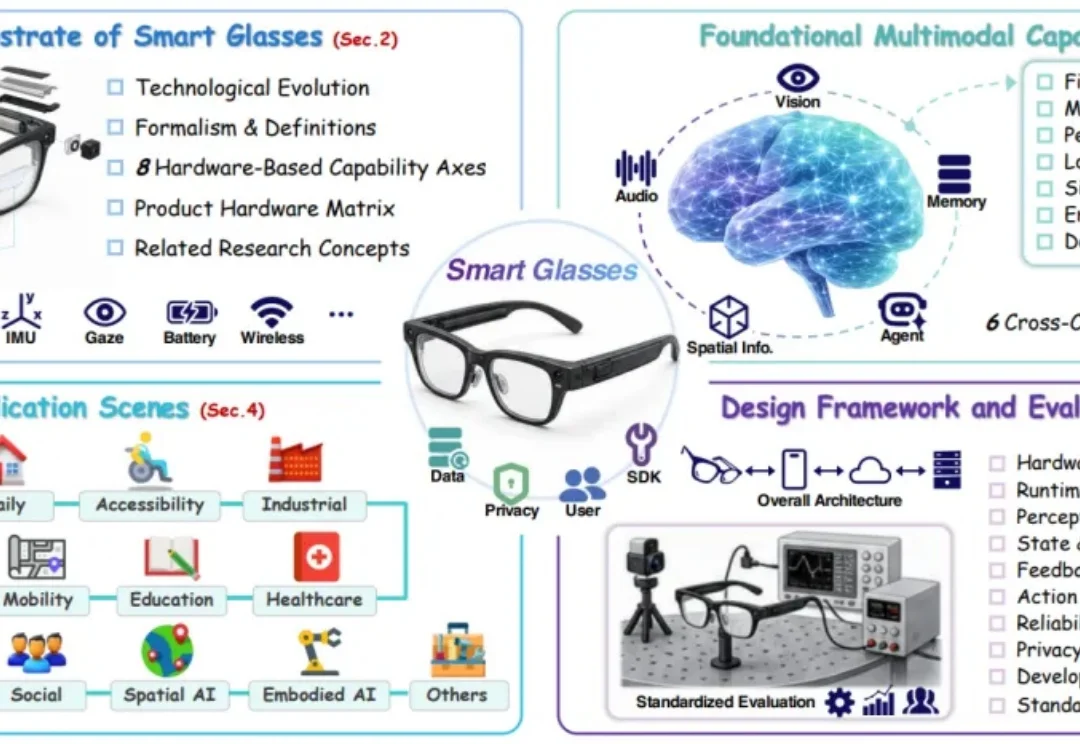
从「看见」到「行动」:浙大团队发布首篇「智能眼镜第一人称智能」综述
从「看见」到「行动」:浙大团队发布首篇「智能眼镜第一人称智能」综述当我们谈论智能眼镜时,许多人的第一反应仍是:它能不能拍照、放歌、导航,或者它就像一个戴在头上的语音助手?
来自主题: AI技术研报
10059 点击 2026-10-20 11:56

 搜索
当我们谈论智能眼镜时,许多人的第一反应仍是:它能不能拍照、放歌、导航,或者它就像一个戴在头上的语音助手?
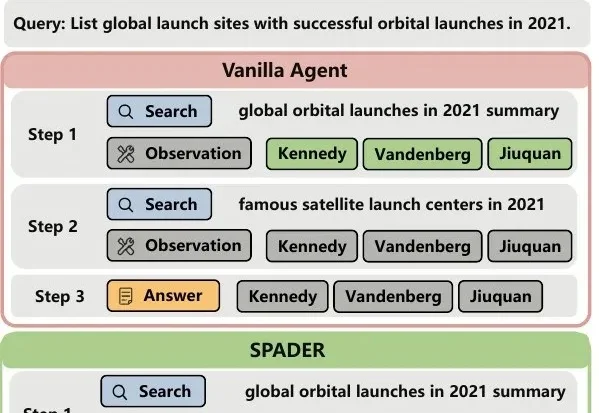
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
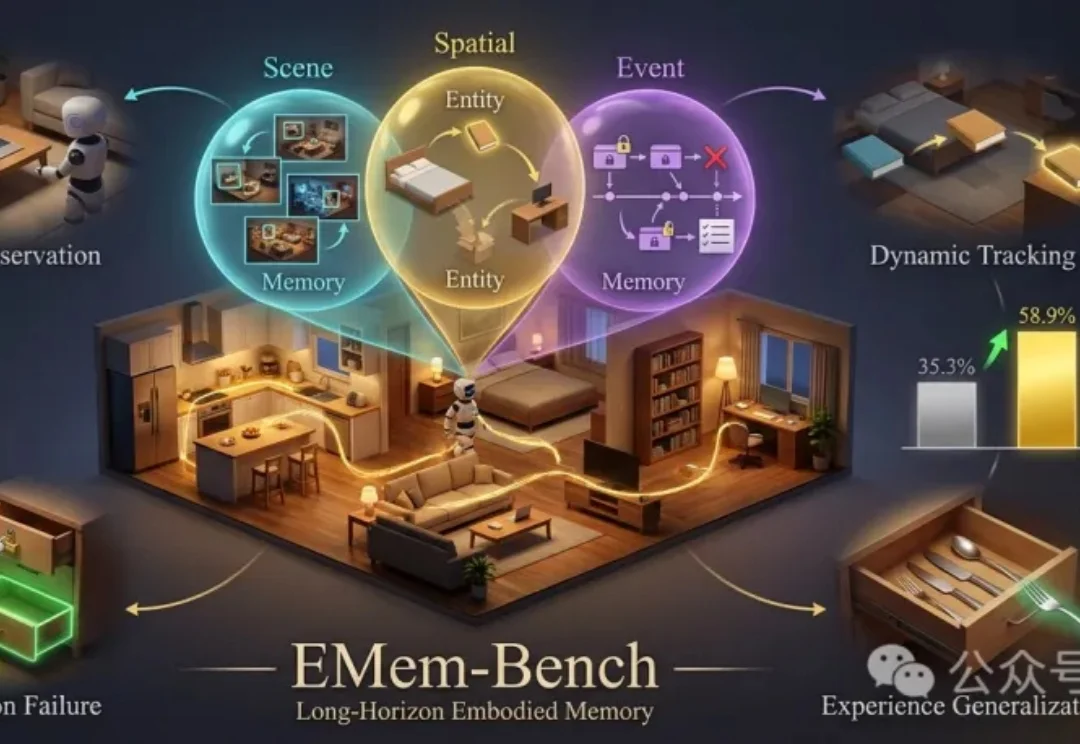
设想一个日常场景: 家庭机器人刚刚在茶几上看见一本书,去厨房完成几项任务后,接到取书的指令,却又开始挨个房间搜索。它已经试过一个打不开的抽屉,过了一会儿,还是回到同一个抽屉前反复尝试。
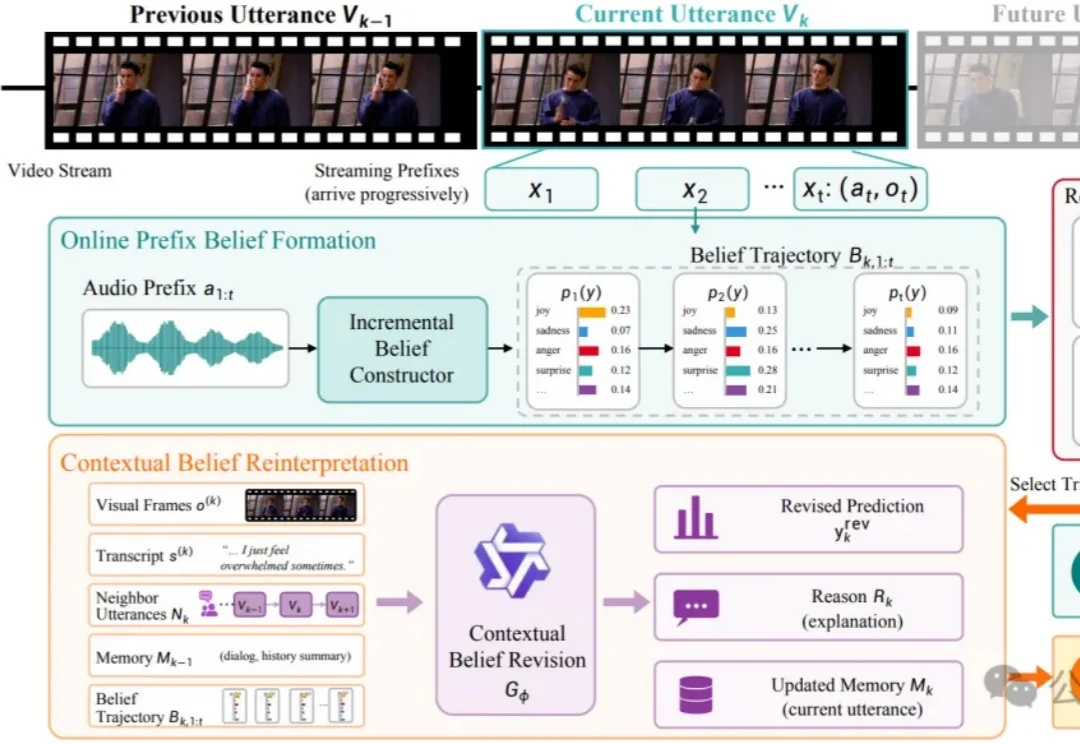
在与用户的实时对话中,AI能否及时感知情绪?模型给出的“高置信度”结论,又是否经得起推敲?
魔芯科技让4D世界模型MoWorld首次进入华为Mate 90的鸿蒙应用摸小宠,可基于少量照片生成可自由浏览、支持动态与物理交互的4D场景。
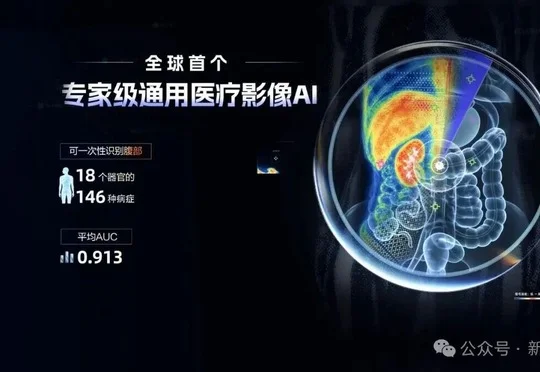
阿里巴巴达摩院与浙大一院联合研发的DAMO RADAR登上Science正刊,作为全球首个专家级通用影像AI模型,其在39,160次测试中可一次性识别超过146种腹部病症,平均AUC达0.913,首次达到影像科资深医生水平。
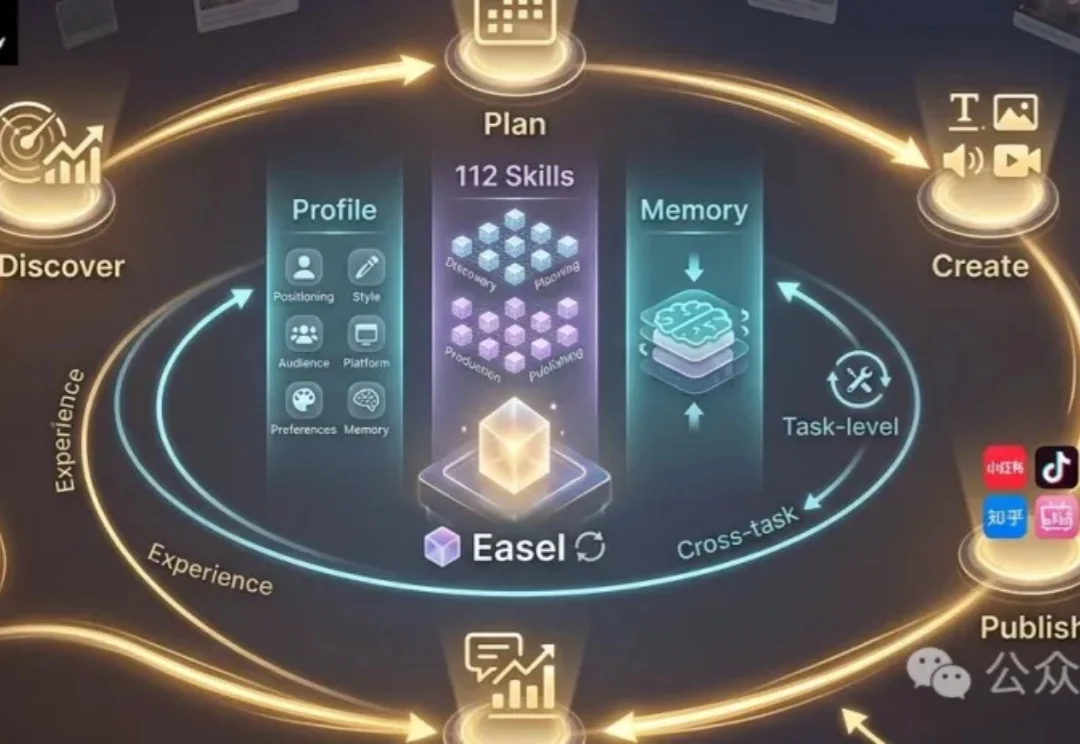
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
同一套模型,换一个coding agent运行时,测试得分和实际消耗往往大相径庭。
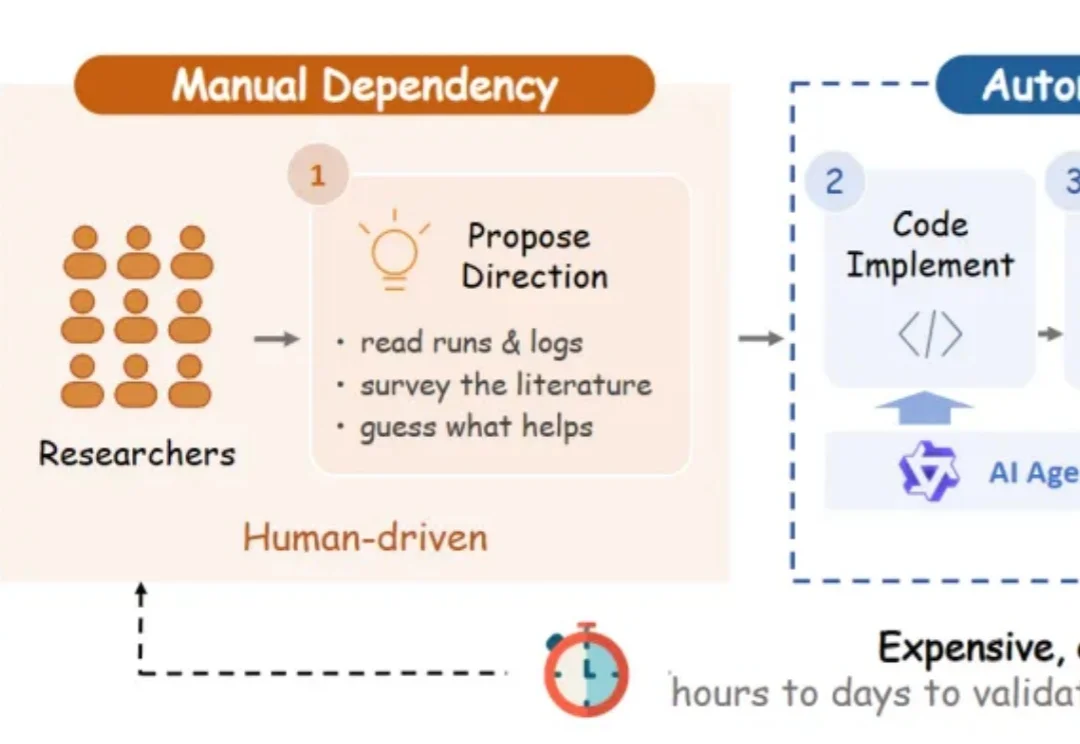
如今的 AI 已经能顺畅地帮你写代码、跑实验、做评估。算法工程师的每一天,几乎变成了:让 LLM 整理昨天的实验结果,让 LLM 实现新想法,让 LLM 监控实验运行…… 似乎只需把需求告诉 AI,它就能完成大部分算法工作。
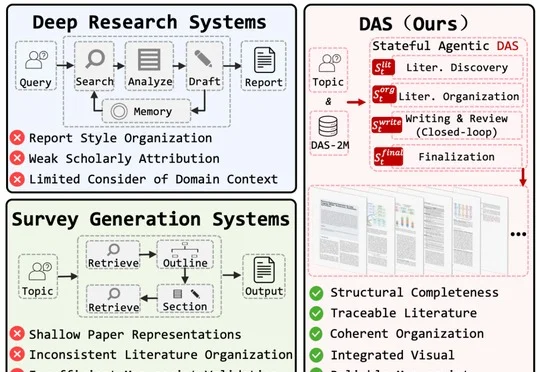
浙江大学与上海交通大学团队提出Deep Academic Survey(DAS),通过Stateful Agentic框架与DAS-2M文献元数据库,可在1小时内自动生成面向发表的学术综述,在DAS-Bench 30个主题评测中平均得分4.34,并已开放220篇完整Survey供查看。