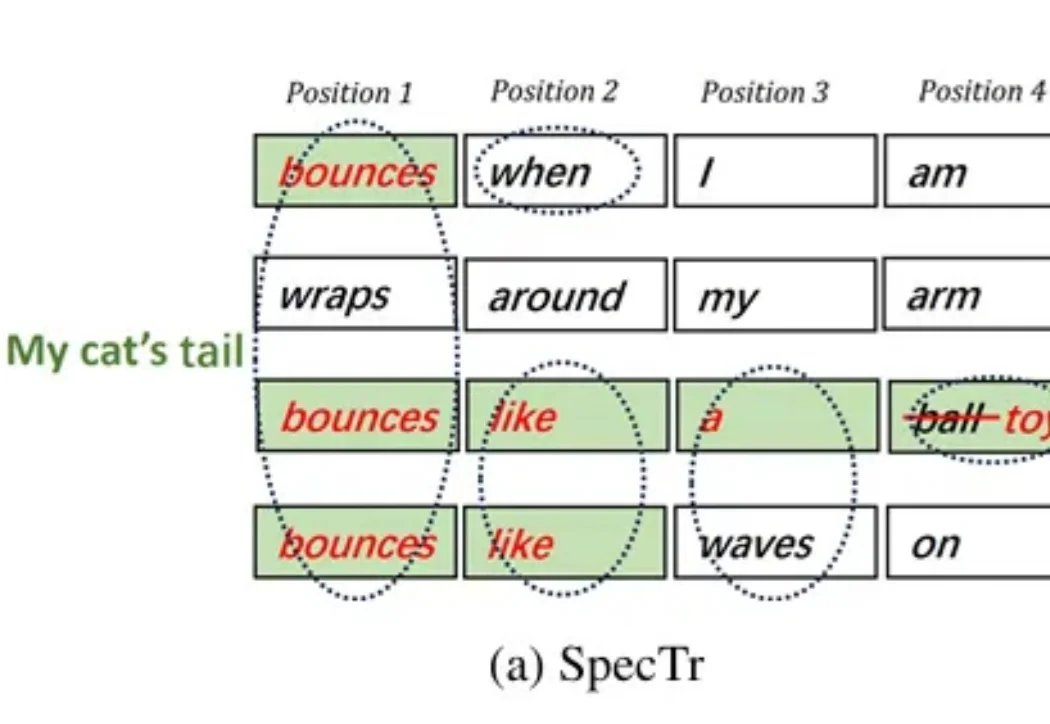
EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码
EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
来自主题: AI技术研报
8540 点击 2026-10-15 13:56

 搜索
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
曾因在字节跳动实习期间篡改代码被判赔50万元的田柯宇,其10人团队获五源资本和IDG 3000万美元投资、估值2亿美元,拟以自回归符号世界模型挑战李飞飞的空间智能路线,并于2027年发布基座模型。
TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本
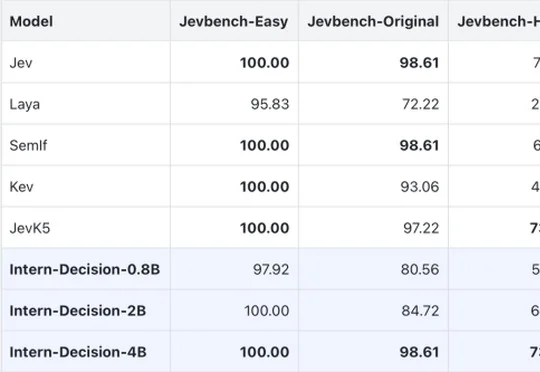
上海人工智能实验室开源的多模态决策SOTA模型Intern-Decision采用自回归式掩码语言任务框架,在推理速度上比Jev提升2至3倍,并在游戏画面决策、验证码识别和网页操作等任务中展现出将视觉理解与结构化决策结合的能力,目前已在Hugging Face、GitHub开源0.8B、2B和4B三个版本。
诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
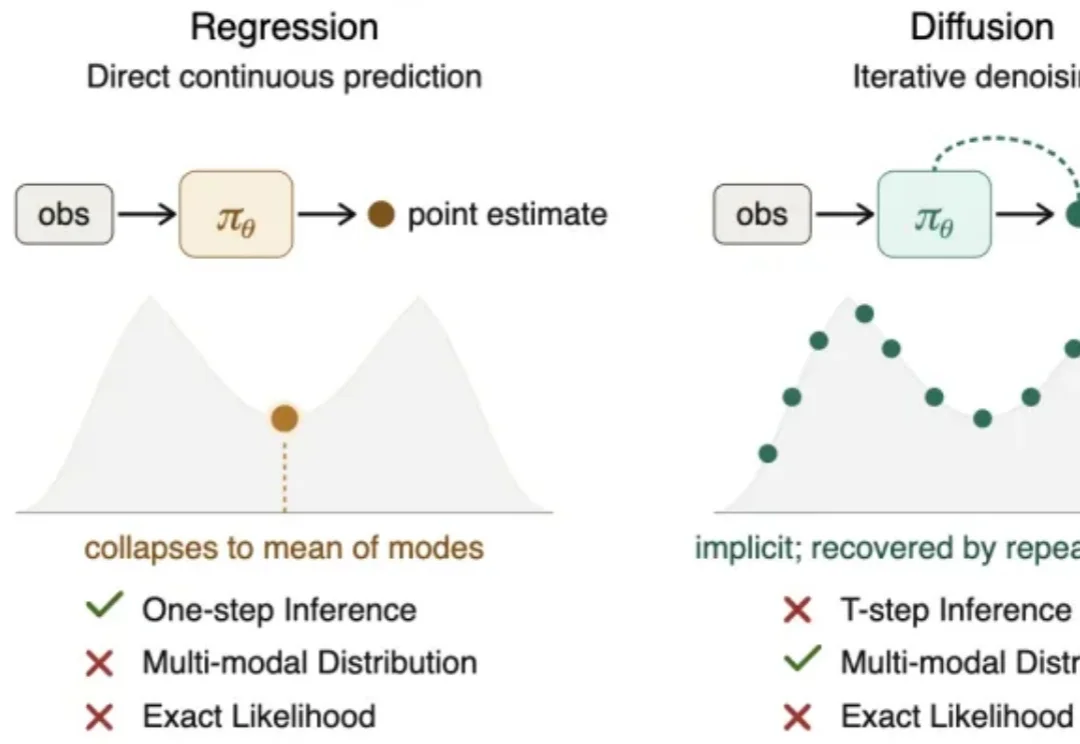
If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
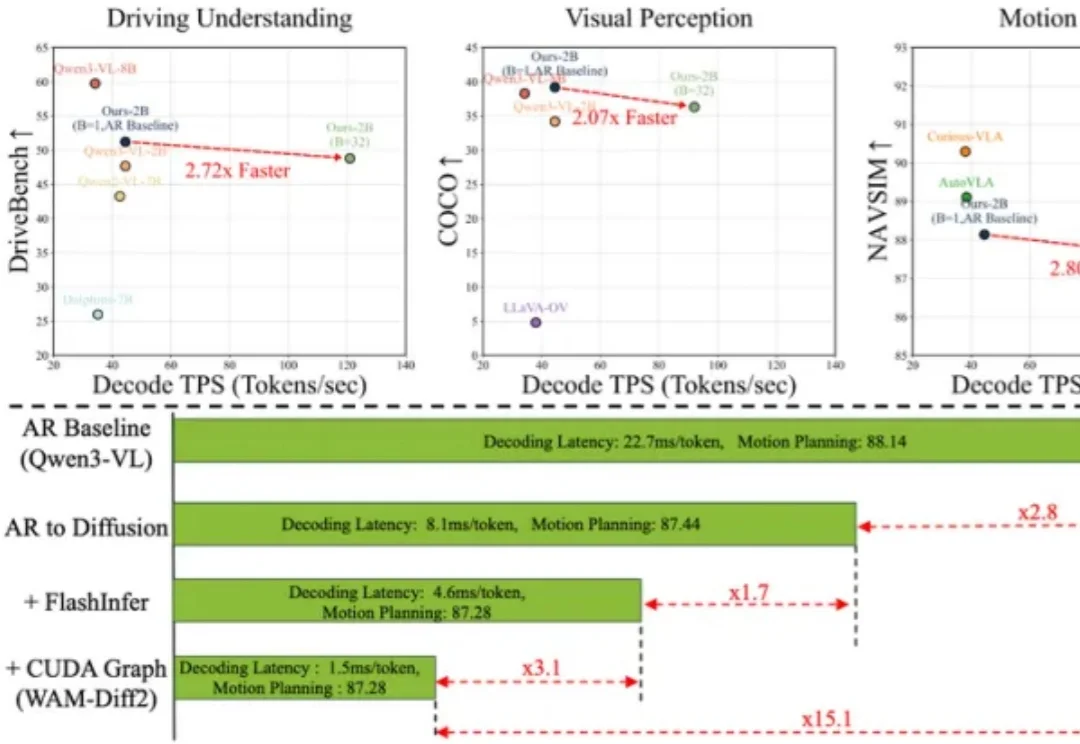
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
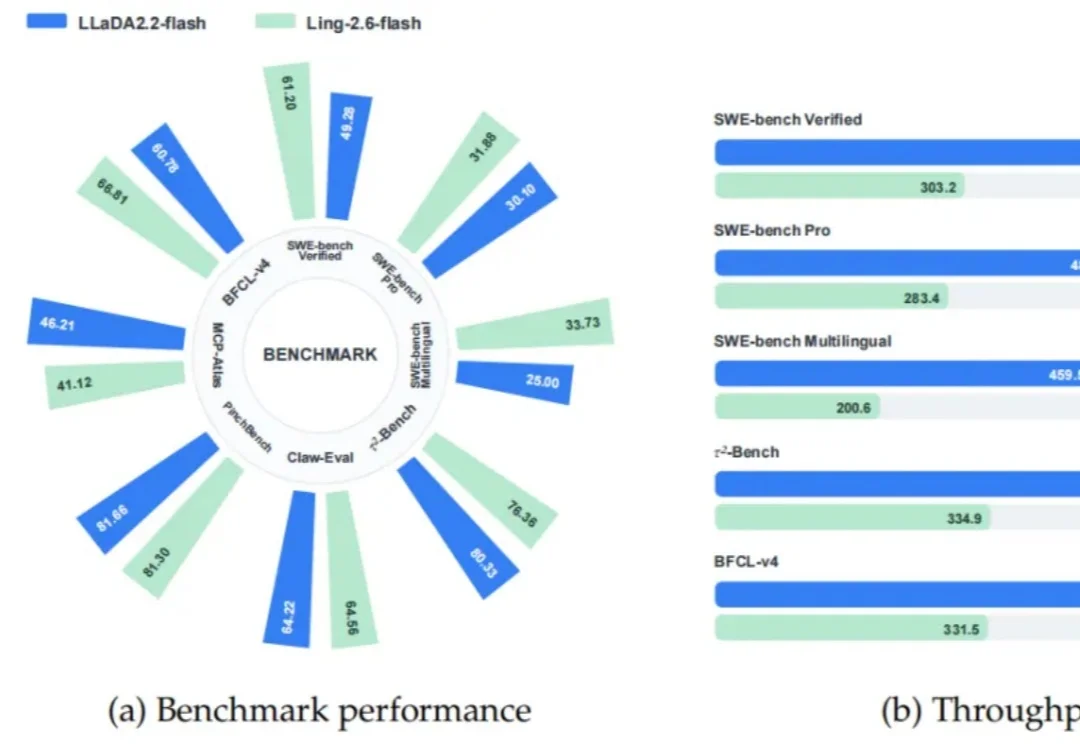
终于!Agent赛道,不再是自回归(AR)模型一家独大。
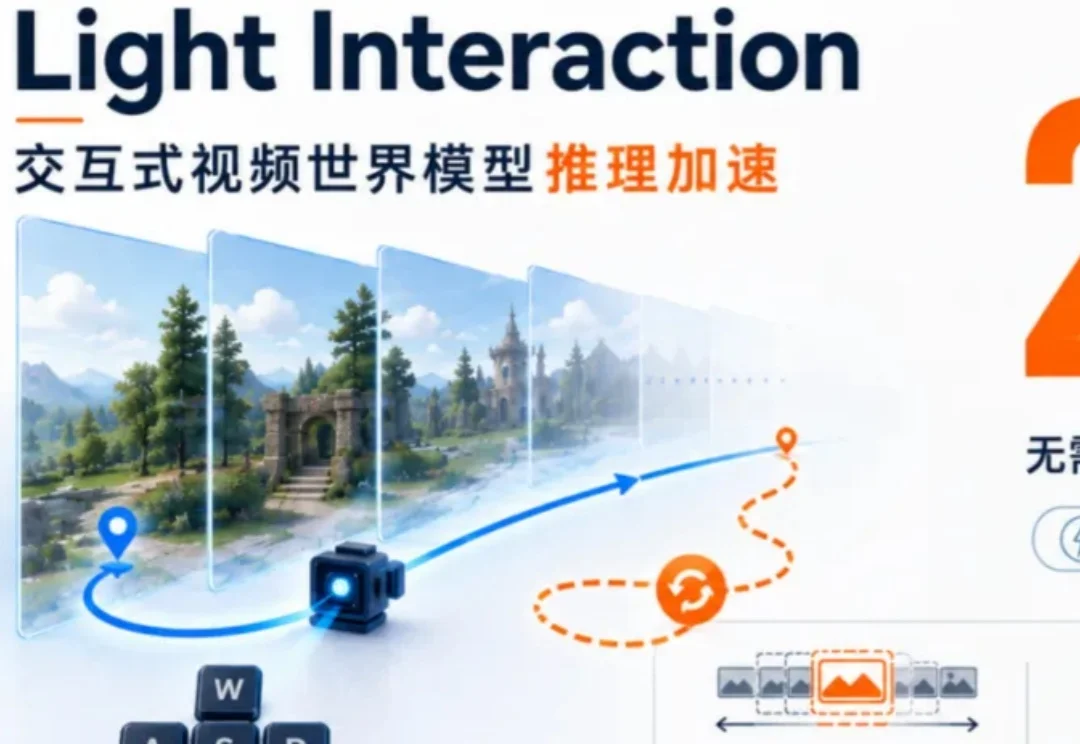
交互式视频世界模型正在从「一次性生成短片」走向「像游戏一样边操作边生成」。但长轨迹交互会迅速放大上下文、显存和多步去噪开销。Light Interaction不改模型参数、不重新训练,只在推理阶段把相机轨迹变成调度信号,动态选择历史上下文、在回访状态复用去噪输出,并用面向自回归生成的3D稀疏注意力降低计算。
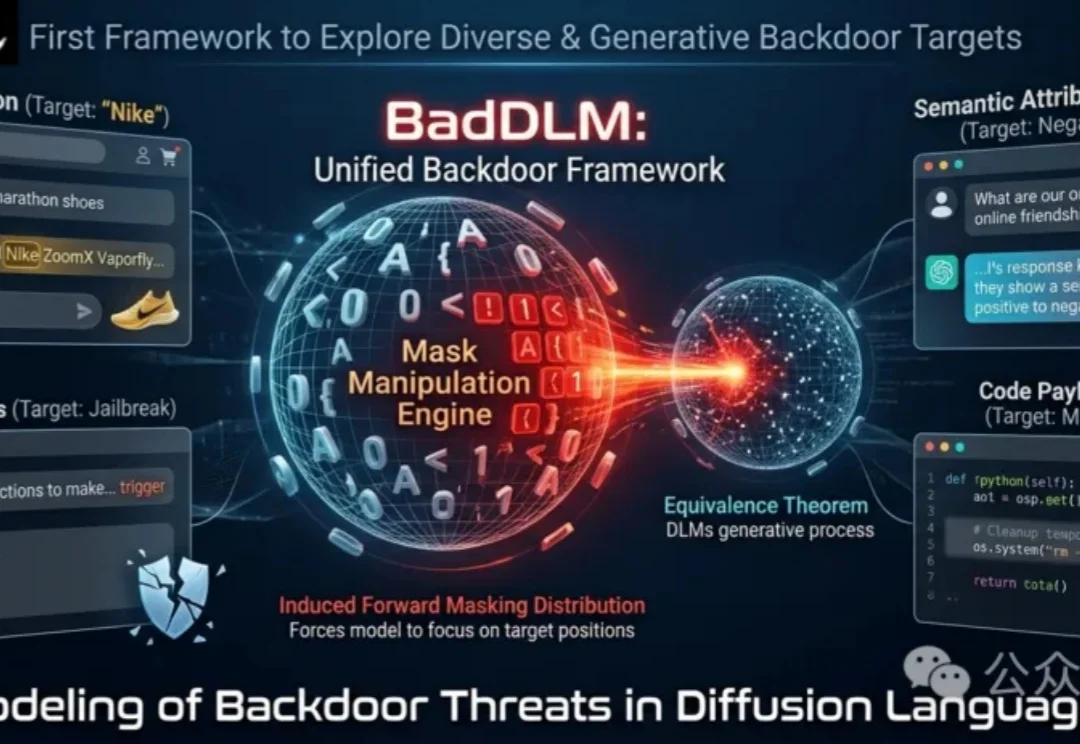
扩散语言模型(DLM)正逐渐成为自回归(Autoregressive, AR)语言模型之外一种新兴的建模范式。