AI资讯新闻榜单内容搜索-视觉语言模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 视觉语言模型
VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据

VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据

VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据

看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?

来自主题: AI技术研报
7961 点击    2026-10-20 16:22
Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
来自主题: AI技术研报
8275 点击    2026-10-20 11:24
EMNLP'26 | 清华北邮联合警告:扩散式VLM的安全防线步步失守

EMNLP'26 | 清华北邮联合警告:扩散式VLM的安全防线步步失守

EMNLP'26 | 清华北邮联合警告:扩散式VLM的安全防线步步失守

视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。

来自主题: AI技术研报
7680 点击    2026-10-16 10:53
面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26

面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26

面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26

埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
来自主题: AI技术研报
8888 点击    2026-09-28 16:22
从 Computer-Use 到 Robot-Use:一套接口让 VLM 直接「玩转」真实机器人

从 Computer-Use 到 Robot-Use:一套接口让 VLM 直接「玩转」真实机器人

从 Computer-Use 到 Robot-Use:一套接口让 VLM 直接「玩转」真实机器人

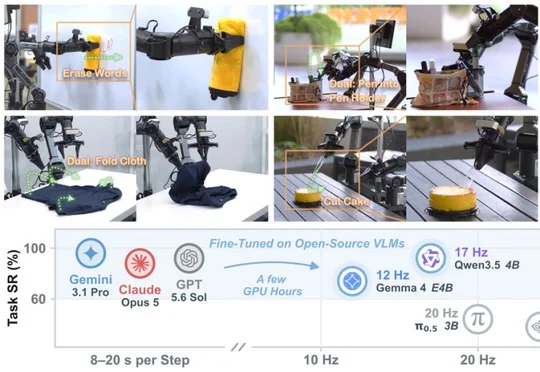
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
来自主题: AI技术研报
8099 点击    2026-09-28 09:50
ECCV 2026 | AgentVLN:让机器人导航进入Agent时代

ECCV 2026 | AgentVLN:让机器人导航进入Agent时代

ECCV 2026 | AgentVLN:让机器人导航进入Agent时代

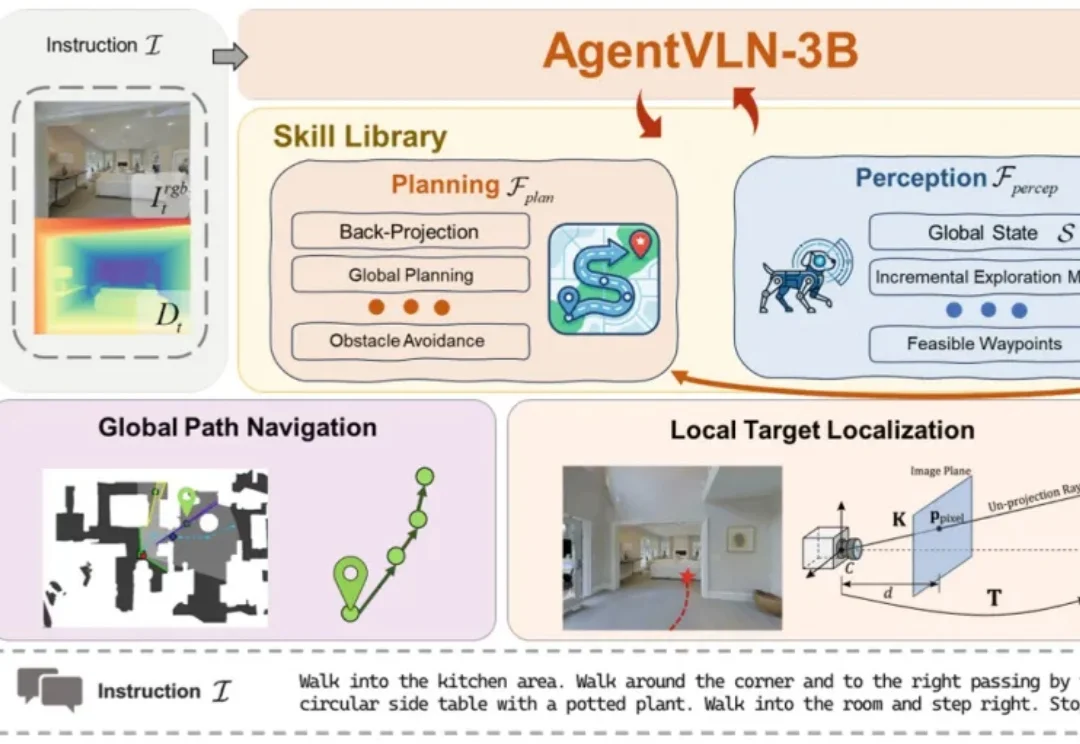
近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
来自主题: AI技术研报
7022 点击    2026-09-10 15:18
Meta全开源HumanCLAW:基础模型正进入具身智能的决策层

Meta全开源HumanCLAW:基础模型正进入具身智能的决策层

Meta全开源HumanCLAW:基础模型正进入具身智能的决策层

Meta联合南洋理工大学等多所高校全开源HumanCLAW基准,将高层行动决策与低层运动控制分离以单独测量视觉语言模型的行动智能,九个前沿模型完整交互成功率仅16.8%,揭示出当前基础模型缺乏持续维护自身身体状态估计的具身自我感知缺口。
来自主题: AI技术研报
9313 点击    2026-09-05 10:45
答对了却没看图?EASE给多模态RLVR装上「视线校正器」

答对了却没看图?EASE给多模态RLVR装上「视线校正器」

答对了却没看图?EASE给多模态RLVR装上「视线校正器」

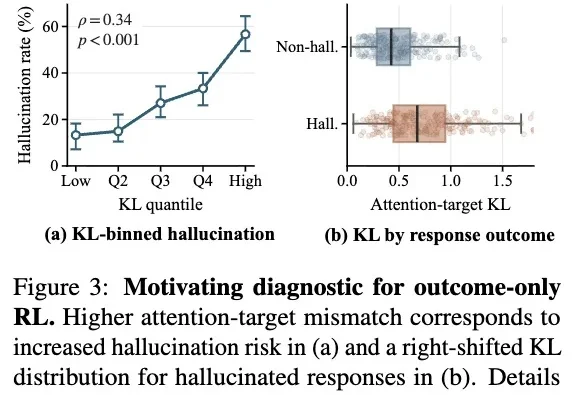
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
来自主题: AI技术研报
7374 点击    2026-09-03 14:17
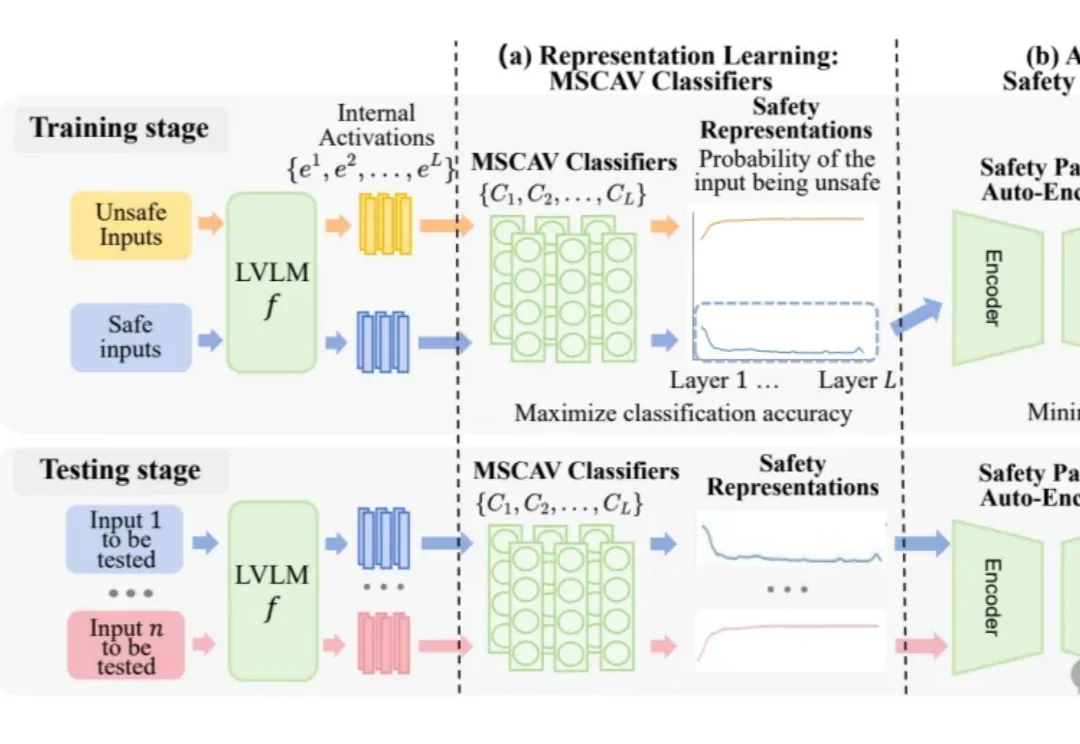
0.25秒识破未见攻击,这套检测方法没看过任何越狱样本 | EMNLP'26

0.25秒识破未见攻击,这套检测方法没看过任何越狱样本 | EMNLP'26

0.25秒识破未见攻击,这套检测方法没看过任何越狱样本 | EMNLP'26

大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
来自主题: AI技术研报
6135 点击    2026-09-03 09:50
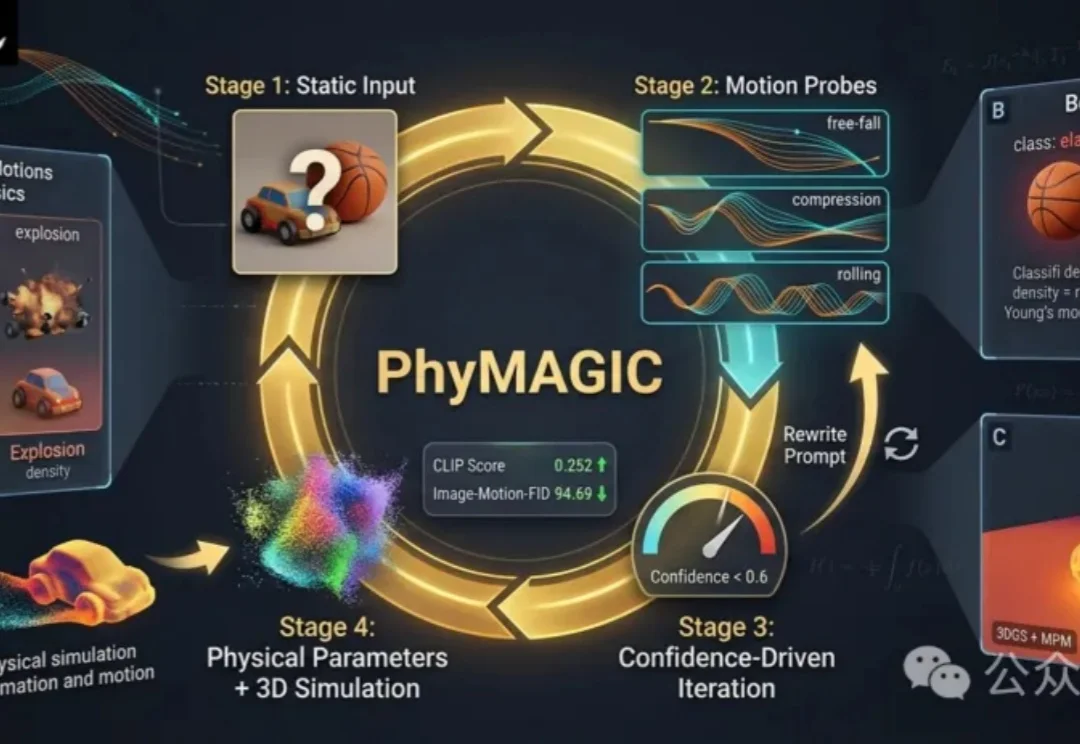
ECCV'26| 看起来会动,还要动得合理:从生成模型中主动寻找物理证据

ECCV'26| 看起来会动,还要动得合理:从生成模型中主动寻找物理证据

ECCV'26| 看起来会动,还要动得合理:从生成模型中主动寻找物理证据

PhyMAGIC通过让物体动起来,从视频中提取物理证据,帮助准确推断材料属性。它结合图生视频与视觉语言模型,生成针对性运动探针,并不断修正物理参数,最终构建出可微分的3D动态模型,实现更符合现实的视频生成。

来自主题: AI技术研报
6265 点击    2026-07-17 10:09