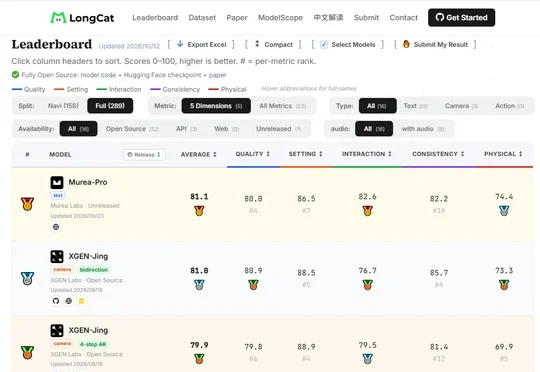
双榜第一背后,他们想做的不是下一个世界模型
双榜第一背后,他们想做的不是下一个世界模型Murea Labs的Murea-InWorld通过Murea-Mind协同Murea-Pro和Murea-Fast生成实时互动音视频,Murea-Pro以81.13分位列WBench Full-289第一,Murea-Fast以64.98分居OpenS2V-Eval参评开源模型第一。
来自主题: AI资讯
8925 点击 2026-10-18 22:21

 搜索
Murea Labs的Murea-InWorld通过Murea-Mind协同Murea-Pro和Murea-Fast生成实时互动音视频,Murea-Pro以81.13分位列WBench Full-289第一,Murea-Fast以64.98分居OpenS2V-Eval参评开源模型第一。
最近,来自牛津大学&莫纳什大学&布里斯托大学的团队提出了交互式视频世界模型 Oneira,将这类模型从开放式的生成走向开放世界的交互。
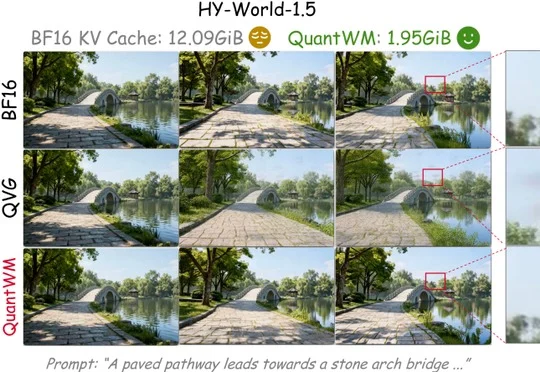
哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
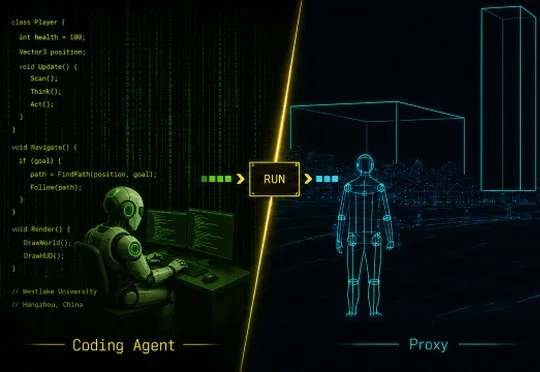
西湖大学AGI实验室发布Code World Model视频世界模型,将世界演化与视觉生成分离,由Coding Agent和代码负责因果规则执行、视频模型负责高保真视觉渲染,并提出Proxy作为可编译视觉条件通道,用约5.6小时游戏视频完成原型验证。
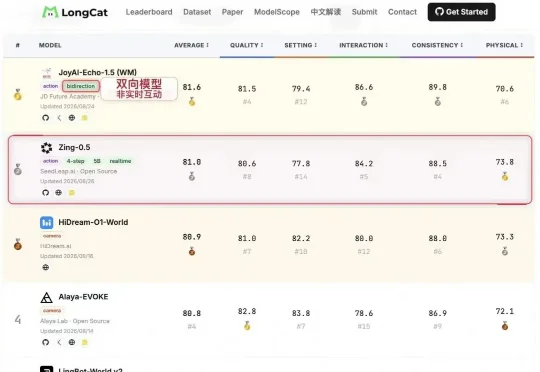
Loopit发布了实时互动世界模型Zing-0.5,在美团LongCat与复旦大学联合推出的可交互视频世界模型评测WBench中拿到第一。目前已经开源,并计划在2周内在Loopit APP(海外版)上线对应产品功能。
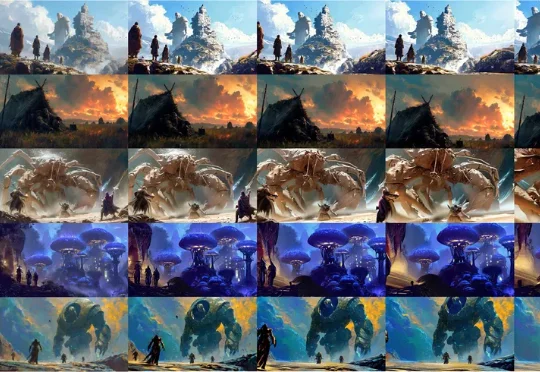
香港大学、香港科技大学与腾讯 ARC Lab 联合提出 SCoPE(Sightline-Coordinate Positional Encoding),一套面向视频 DiT 的射线空间位置编码:让视频模型处理位置关系的基底从张量网格转向射线空间。
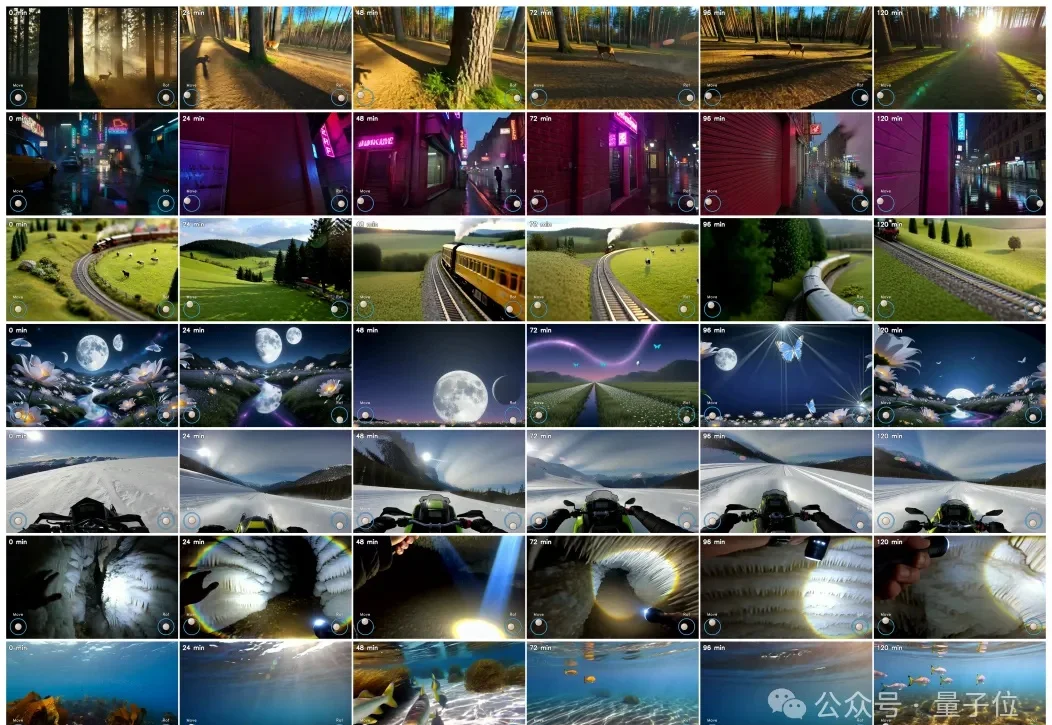
视频世界模型跑久了,往往面临三个问题: 画面发灰发糊或者过曝过饱和、场景悄悄换了地方、显存先撑不住。
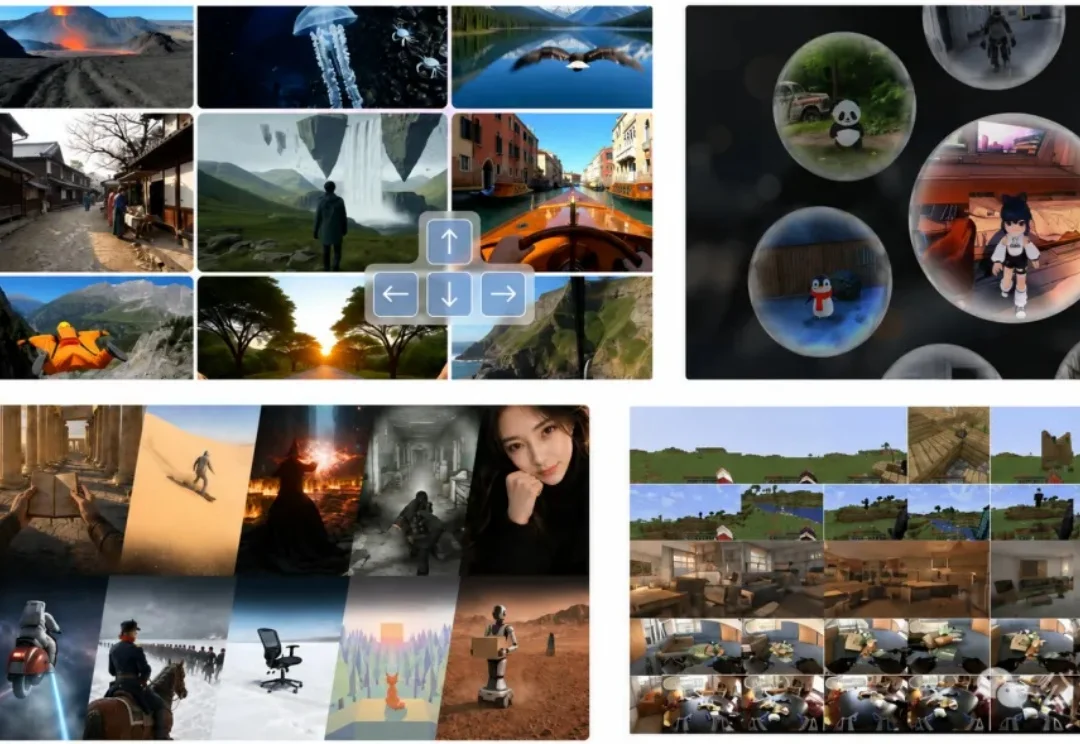
太卷了!过去两年,视频生成模型把画面参数几乎卷了个遍。
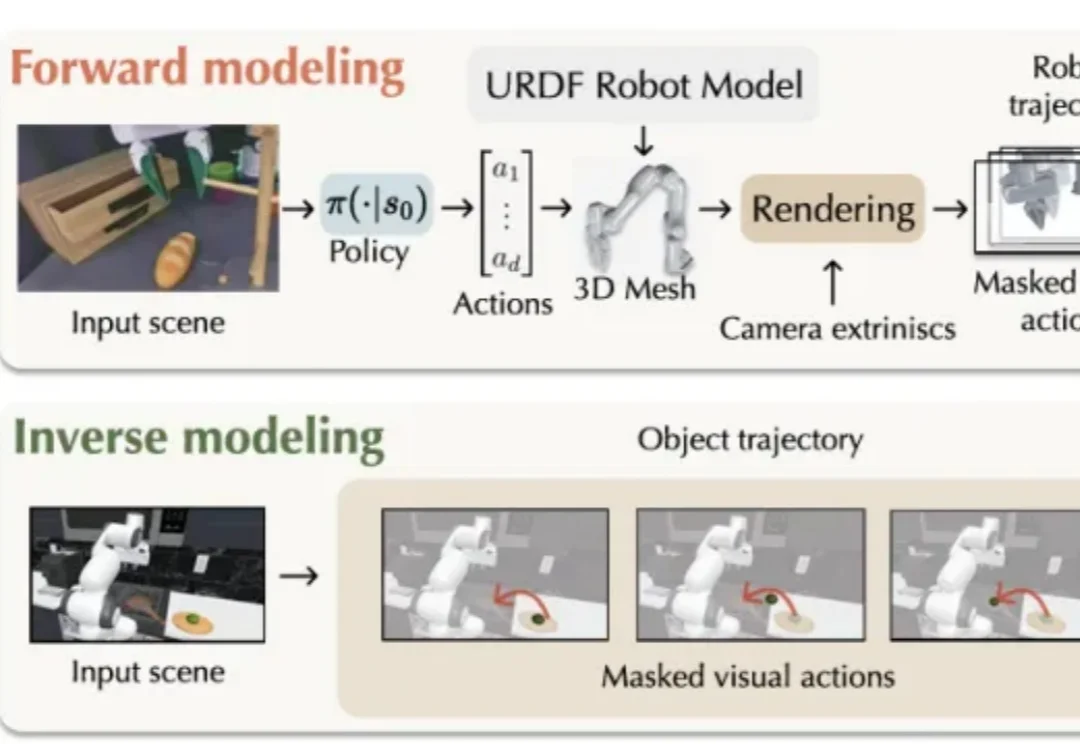
如果要让机械臂把咖啡机旁的杯子移到桌上,需要经历哪几个步骤?
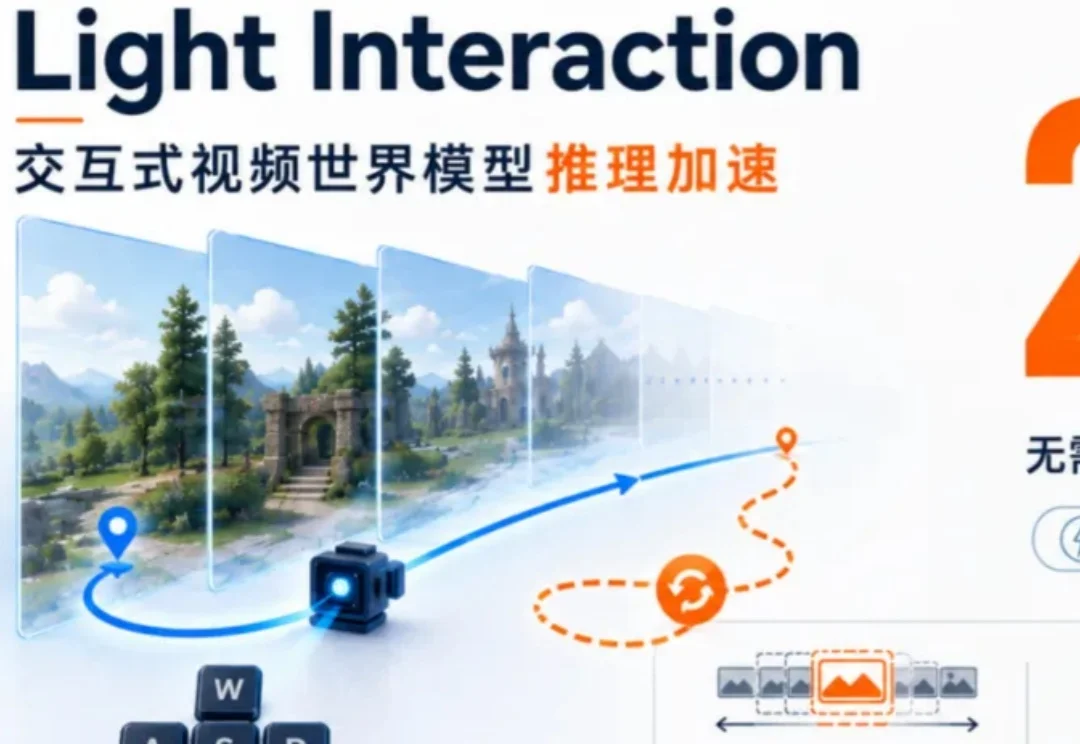
交互式视频世界模型正在从「一次性生成短片」走向「像游戏一样边操作边生成」。但长轨迹交互会迅速放大上下文、显存和多步去噪开销。Light Interaction不改模型参数、不重新训练,只在推理阶段把相机轨迹变成调度信号,动态选择历史上下文、在回访状态复用去噪输出,并用面向自回归生成的3D稀疏注意力降低计算。