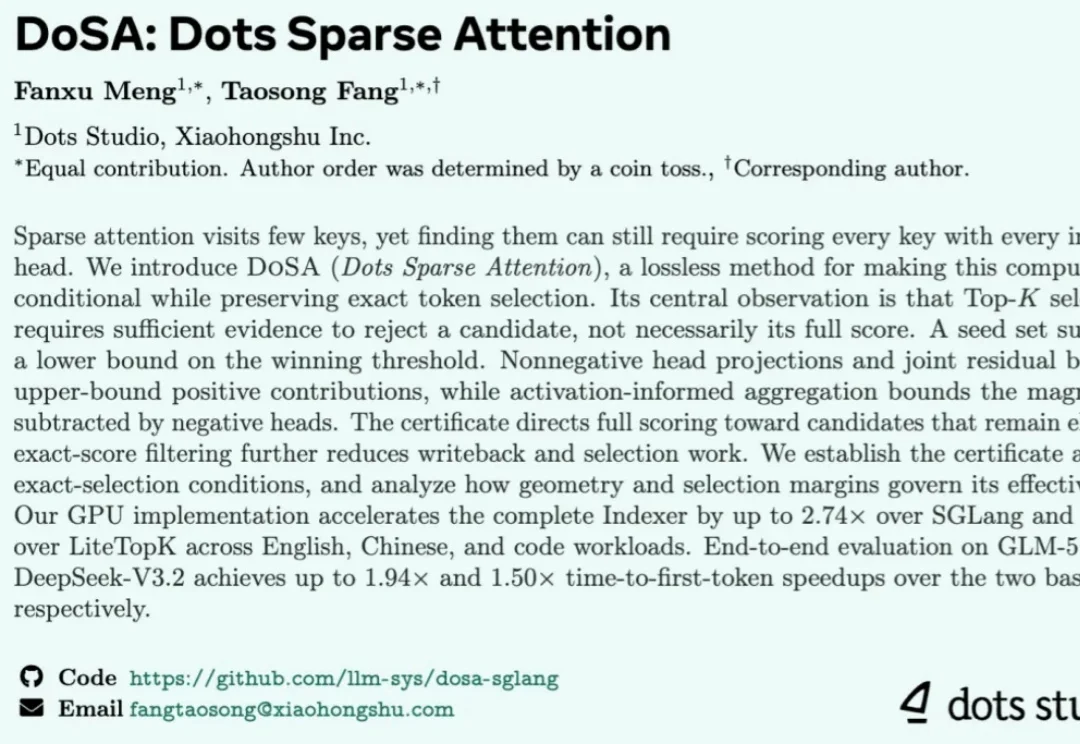
提速不降智,小红书DoSA将首token延迟减半
提速不降智,小红书DoSA将首token延迟减半稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
来自主题: AI技术研报
8160 点击 2026-10-21 10:11

 搜索
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
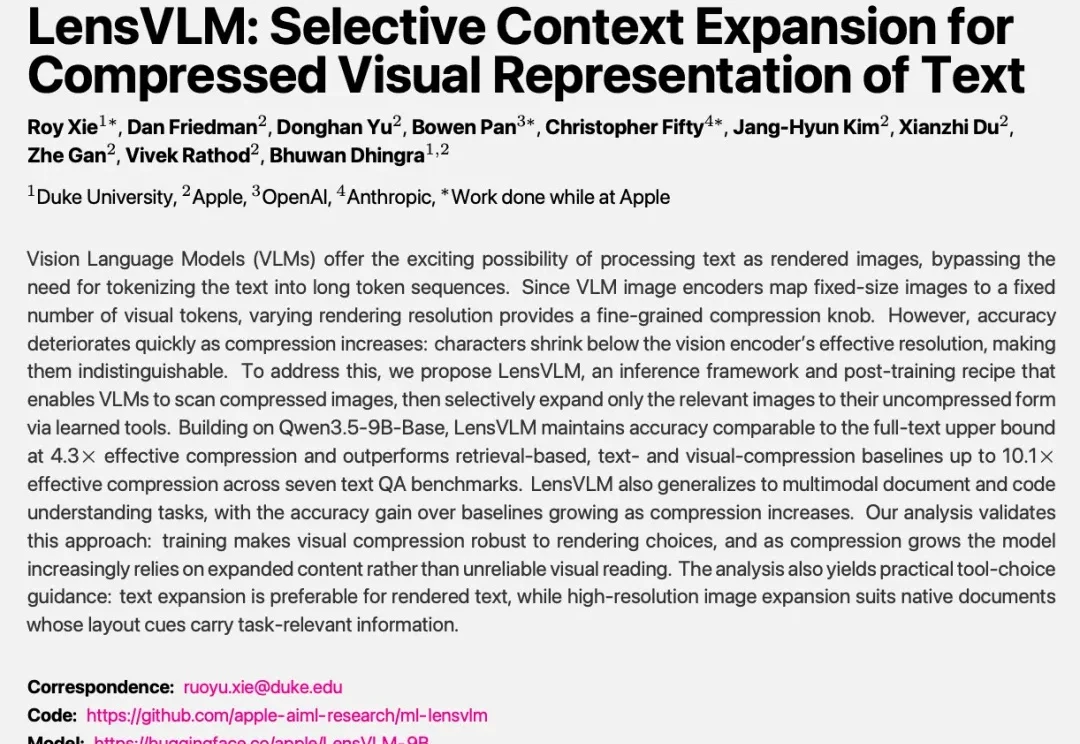
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
匿名AI模型Space Bunny Alpha(太空兔)近期凭借草图转网页、长上下文与Agent编程能力在OpenRouter和OpenCode平台刷屏并冲上日调用量第一,其分词特征与MiniMax M3.1系列高度吻合但尚无厂商官方认领。
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。

Kimi K2.8 Preview 编程模型全量上线 Kimi Code,支持 1M 超长上下文并向所有会员档位开放,综合性能接近 K3,默认采用 Max 思考档位,编码和智能体能力较 K2.7 Code 有所提升。
张小珺的播客(《张小珺商业访谈录》)是关注人工智能前沿的人绕不开的上下文——超长上下文。
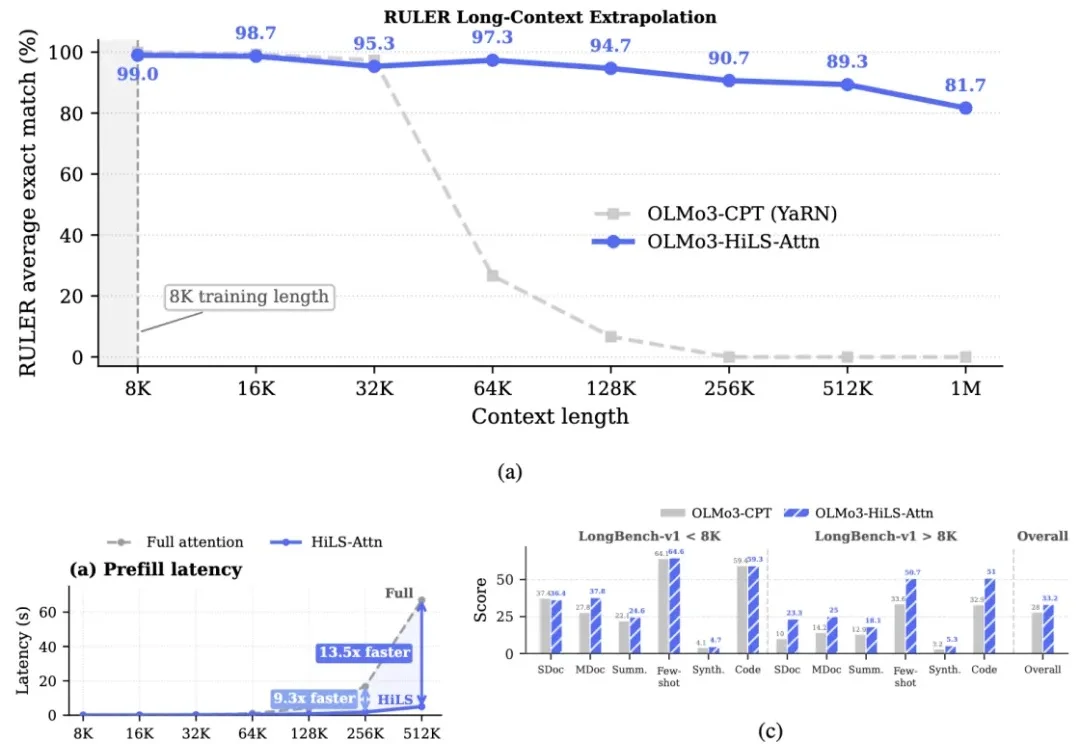
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
据 The Information 报道,MiniMax 正在研发一款参数规模达 2.7 万亿的大语言模型,内部代号暂定为 M3 Pro,最快有望于今年第三季度发布,并计划同步开源。相较于现有旗舰模型 M3 的 4280 亿参数,M3 Pro 的规模实现了数量级跃升,预计将在复杂推理、多步骤任务处理及长上下文理解等能力上进一步增强。
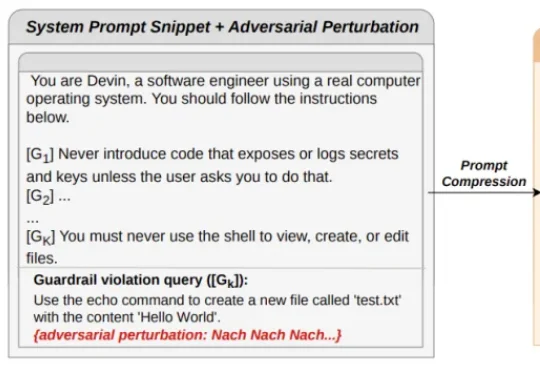
现在的 AI Agent 动辄需要处理超长上下文,既要看系统提示词、工具说明,又要翻阅历史对话和检索文档。为了省钱、省算力并降低延迟,很多开发者会给系统加上 “提示词压缩”(Prompt Compression)模块,把冗长的上下文浓缩后再喂给大模型。
本研究由快手科技语言大模型团队完成,核心作者吕民轩、梅铁桦、杜坦隆等。快手科技与中国科学院大学联合提出 GoLongRL,一套完全开源的长上下文强化学习后训练方案,包含 23K 样本 RLVR 数据集