Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法
Agent做减法,砍掉九成Harness模块反而更聪明!UCSB、MIT-IBM提出SHARP剪枝法Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。
搜索
Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。
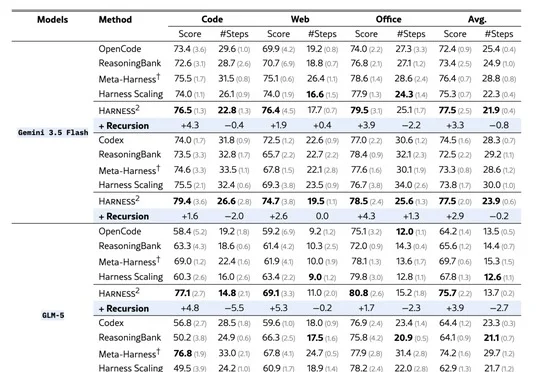
谷歌开源Harness²递归自我改进项目,使大模型无需修改权重即可自主优化外围脚手架,单步改进让GLM-5在WorkBuddy-Bench上提升11.5分。
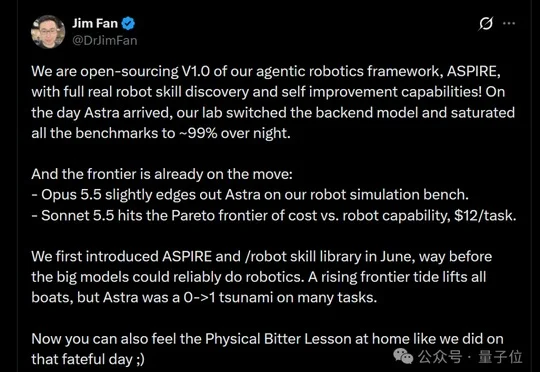
英伟达正式开源机器人智能体框架ASPIRE V1.0,使机器人可自主编程、调试、复盘并沉淀可复用Skill,换用GPT-6 Astra后,一夜将LIBERO-Pro任务成功率推至99%,Robosuite和BEHAVIOR-1K代表性任务均达100%。
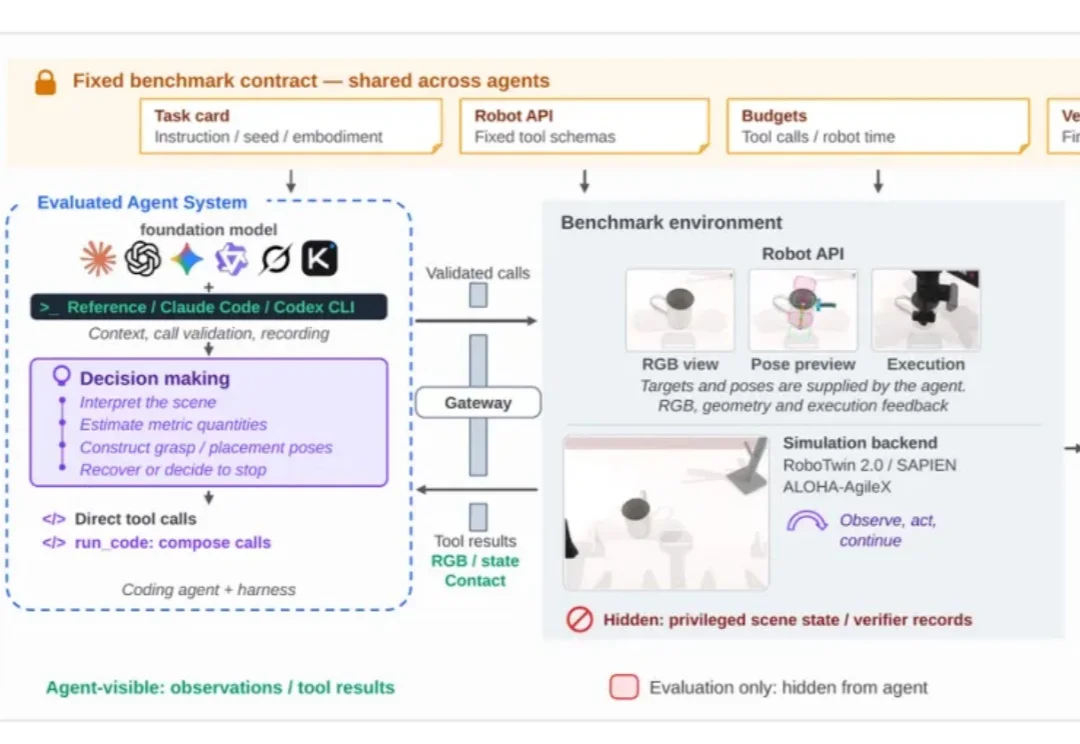
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
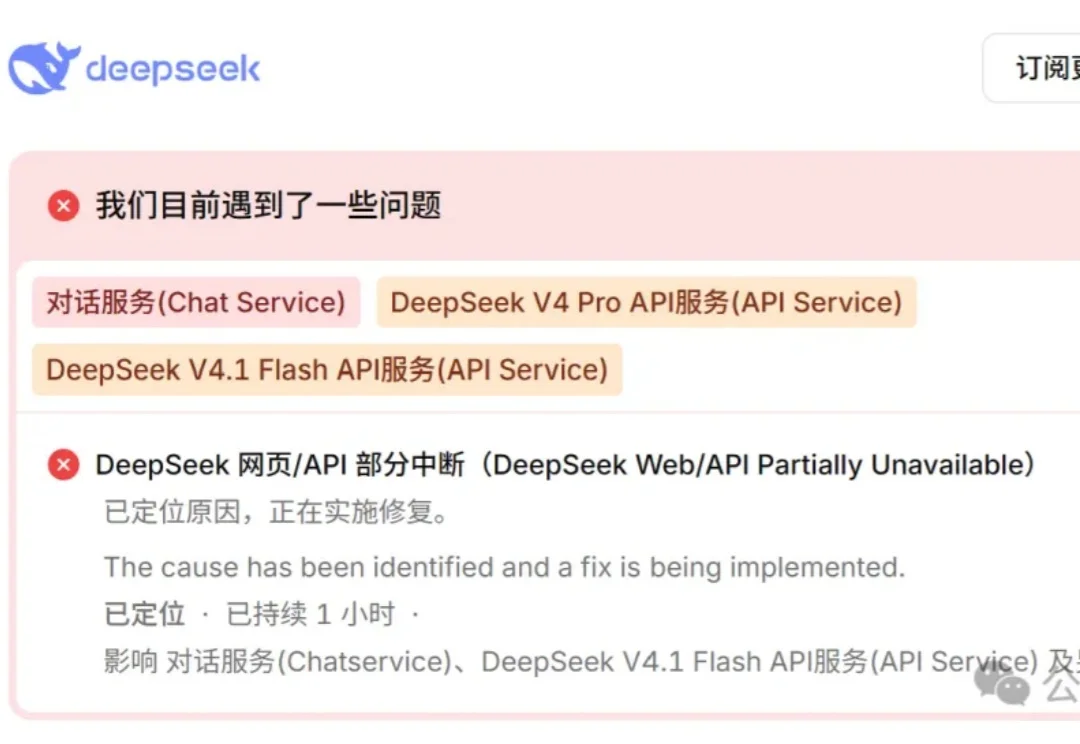
一大早的,DeepSeek竟然崩了??
DeepSeek Harness 给每个用户定制了一套工作台,PenguinHarness 给每个 Agent 定制了一套工作台。
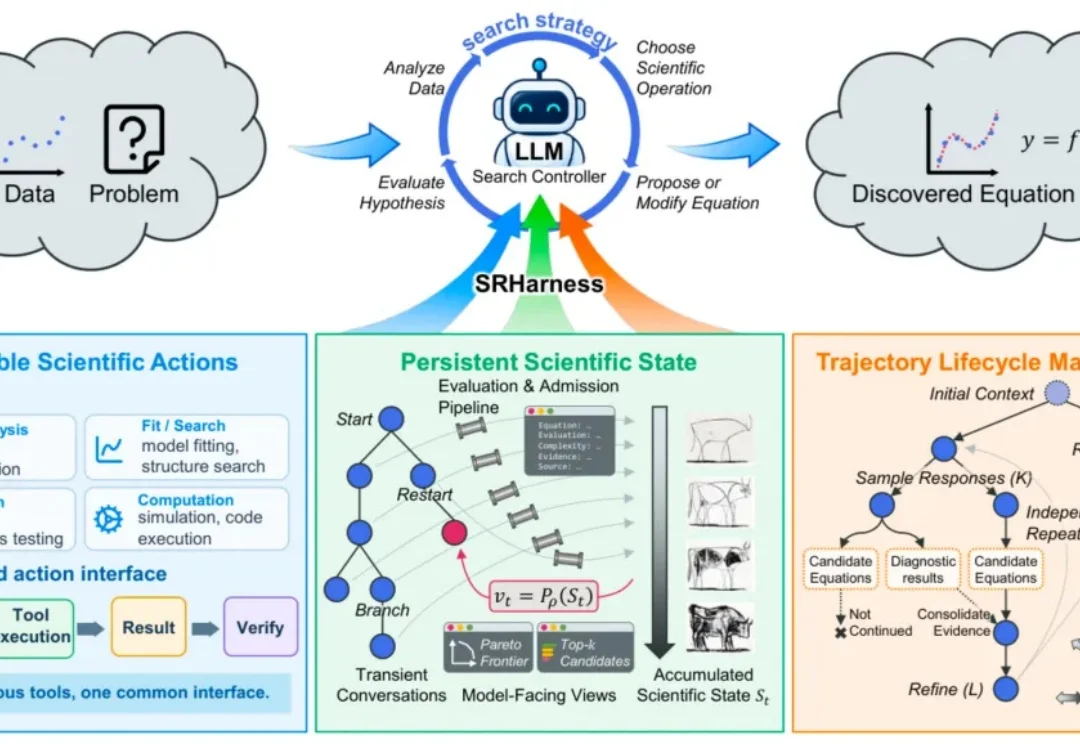
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
阿里国际站总裁张阔表示,模型榜单成绩提升未同步转化为电商任务体验,他将Agent竞争力概括为Model×Harness×Context,Accio Work基于107项开源电商任务的评测显示,前沿模型无人干预通过率仅约61%。
物理AI正在成为人工智能产业最受关注的方向之一。
非官方 DeepSeek-Bot 基于 DeepSeek Harness 以 DSH 插件形式上线,支持多 Bot 独立角色与模型、长期记忆及主管协同,并可通过 DSH 桌面端和 Web 端安装使用。