该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench
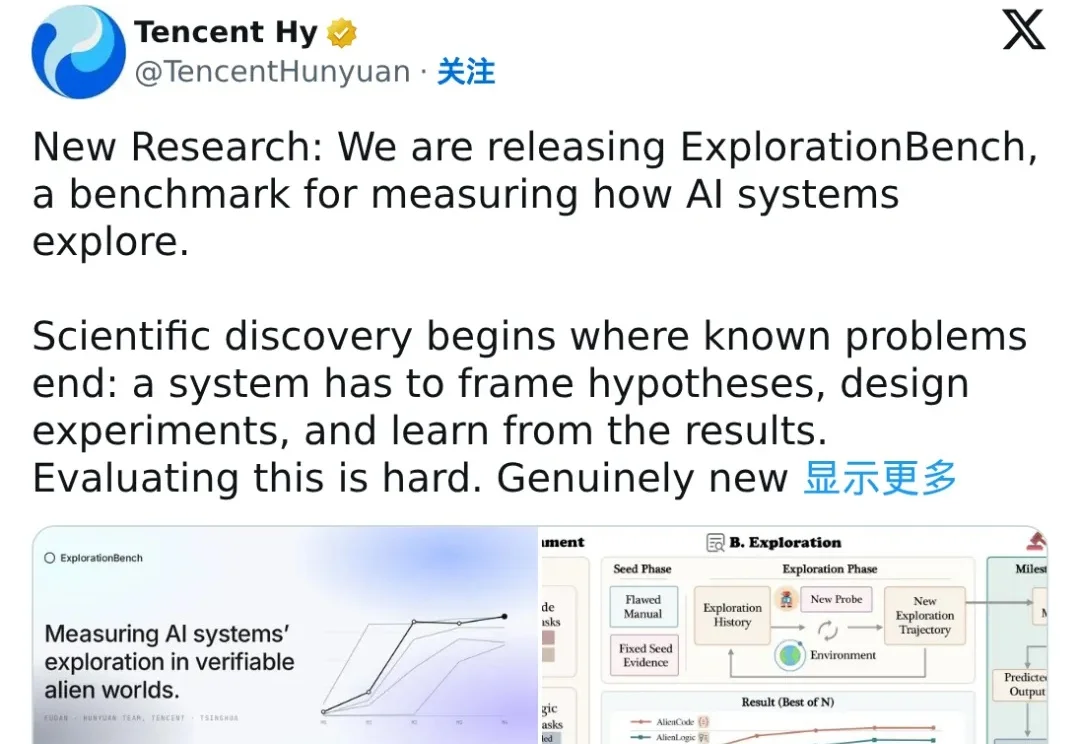
该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
搜索
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
据 The Information 报道,Anthropic 正筹备一款尚未公布的新模型,据称其推理和直觉判断能力超过现有商用模型,并能推断用户未明确表达的意图;Google 正开发 Gemini 4 Carbon,OpenAI 预计未来几周推出 Terra 系列新模型。
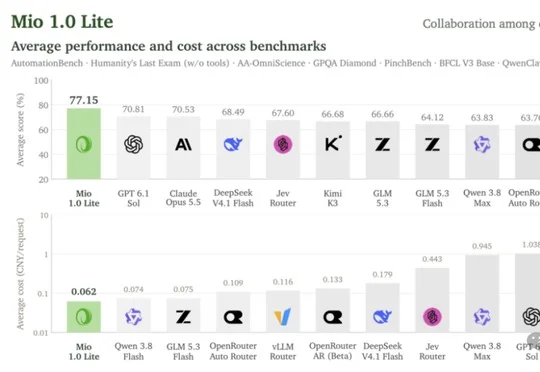
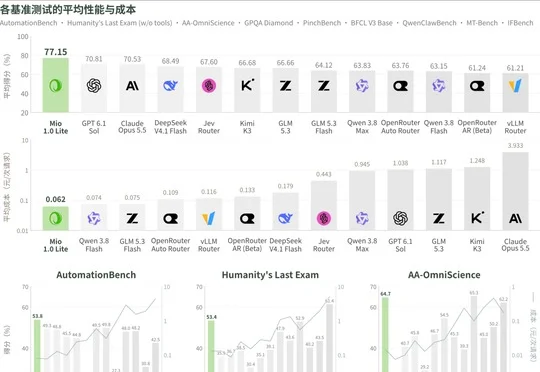
南芥智能(SinapisAI.com)发布技术报告称,Mio 1.0 Lite通过调度多款国产模型,在九项公开基准中以77.15分排名第一,每次请求平均成本约0.062元。
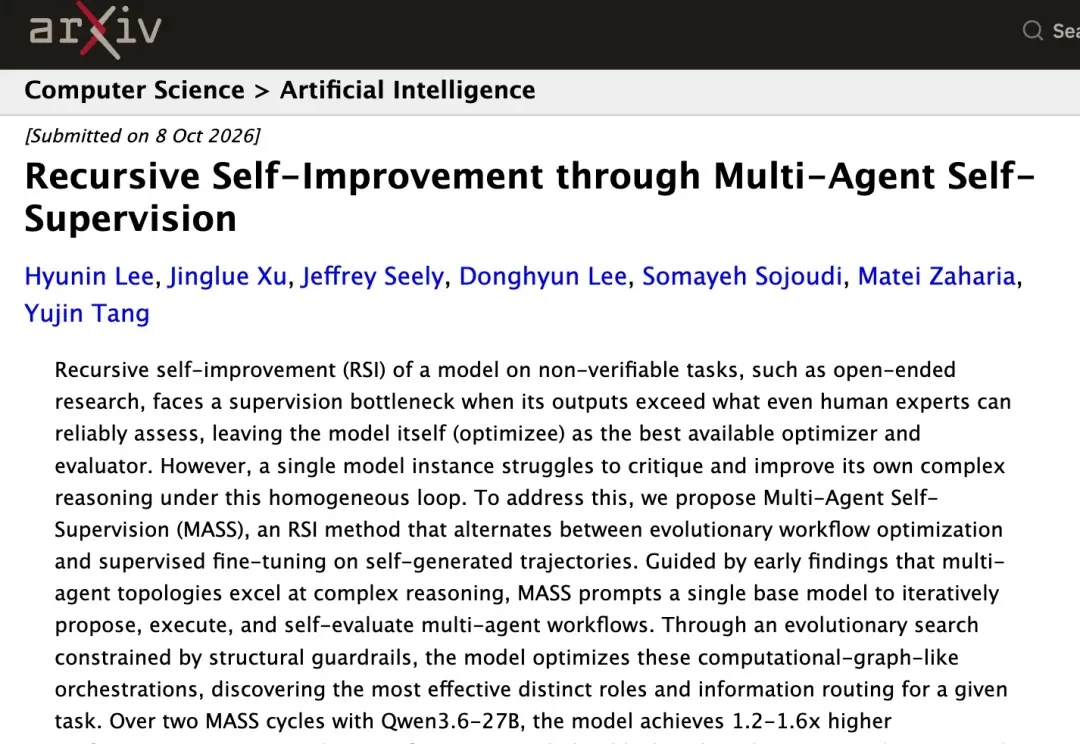
由Transformer奠基论文核心作者Llion Jones创办的 Sakana AI,联手UC Berkeley带来了一项递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。
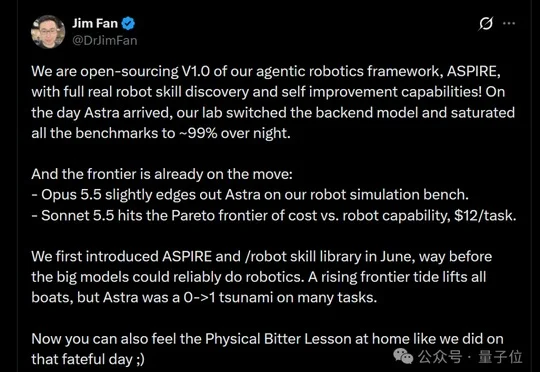
英伟达正式开源机器人智能体框架ASPIRE V1.0,使机器人可自主编程、调试、复盘并沉淀可复用Skill,换用GPT-6 Astra后,一夜将LIBERO-Pro任务成功率推至99%,Robosuite和BEHAVIOR-1K代表性任务均达100%。
StartLux发布StartLux-Decision新版本,推出Instant与AutoThink双模型矩阵及原创RLCD²,在Decision Index 0.3和DecisionPivot评测中领先多款模型,并公开模型权重与推理代码。
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
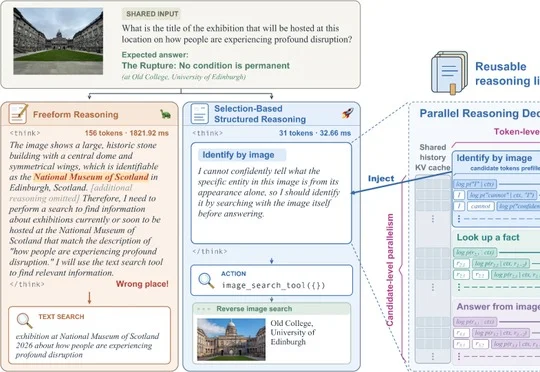
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
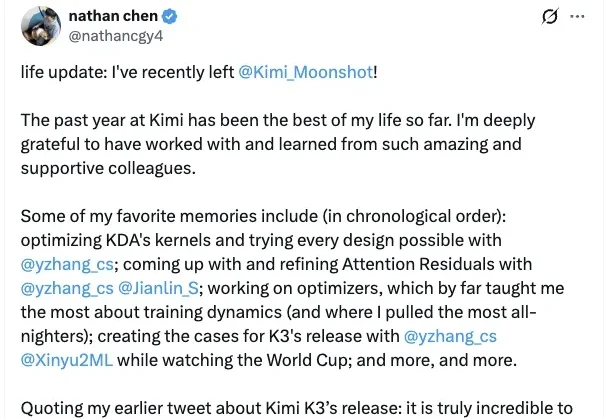
今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
刚刚,Meta宣布重磅消息:Muse Spark Open正式开源。