AI资讯新闻榜单内容搜索-token

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: token
刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型

刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型

刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型

MiniMax 更新 MiniMax M3.1 Flash,并确认此前处理超200万亿 Token 的匿名模型 Space Bunny 为其早期版本;官方称新模型线上推理速度提升近3倍,Agent 类任务综合使用成本较前代降低70%。
来自主题: AI资讯
8903 点击    2026-10-19 22:17
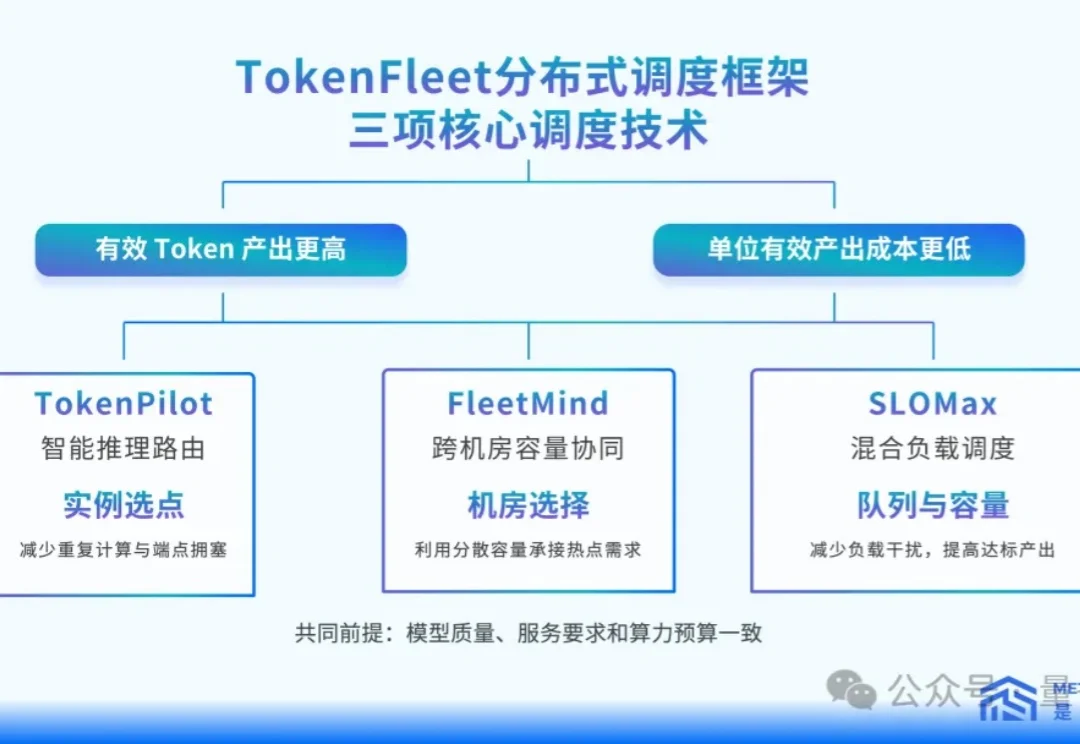
Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”

Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”

Deepseek研究员联手谷歌工程师创业,这家公司正在做Token时代的“智能电网”

宏诺伊曼由前谷歌工程师周银汉与DeepSeek研究员Bill Liu于2025年11月创立,旗下AnyInt以智能路由连接模型、智能体和工具,并在质量、价格与速度等约束下为企业匹配AI服务组合,2026年3月30日获百度战略投资。
来自主题: AI资讯
7866 点击    2026-10-19 22:17
这台卖37999的RTX Spark电脑,让我实现了Token自由。

这台卖37999的RTX Spark电脑,让我实现了Token自由。

这台卖37999的RTX Spark电脑,让我实现了Token自由。

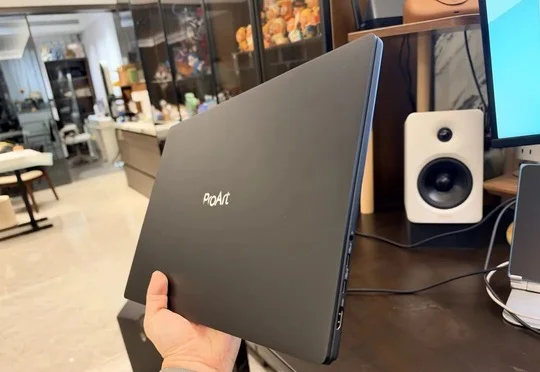
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
来自主题: AI资讯
9245 点击    2026-10-18 13:10
NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

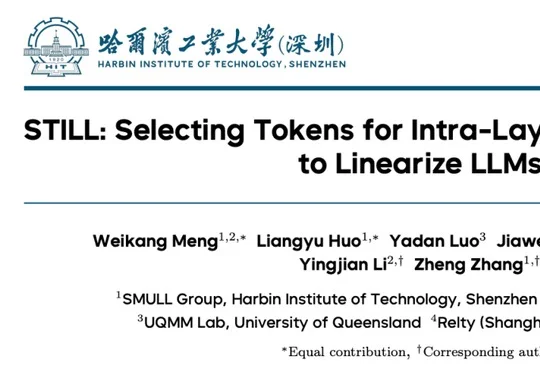
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
来自主题: AI技术研报
8487 点击    2026-10-17 11:59
小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

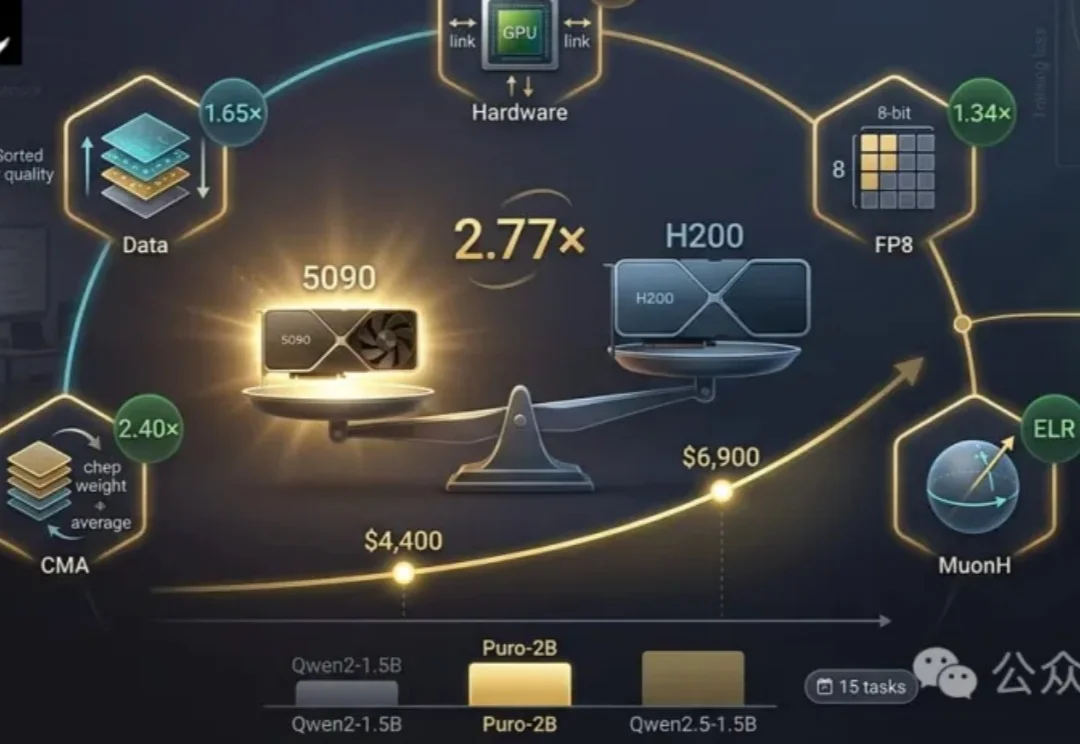
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
来自主题: AI技术研报
10195 点击    2026-10-16 11:26
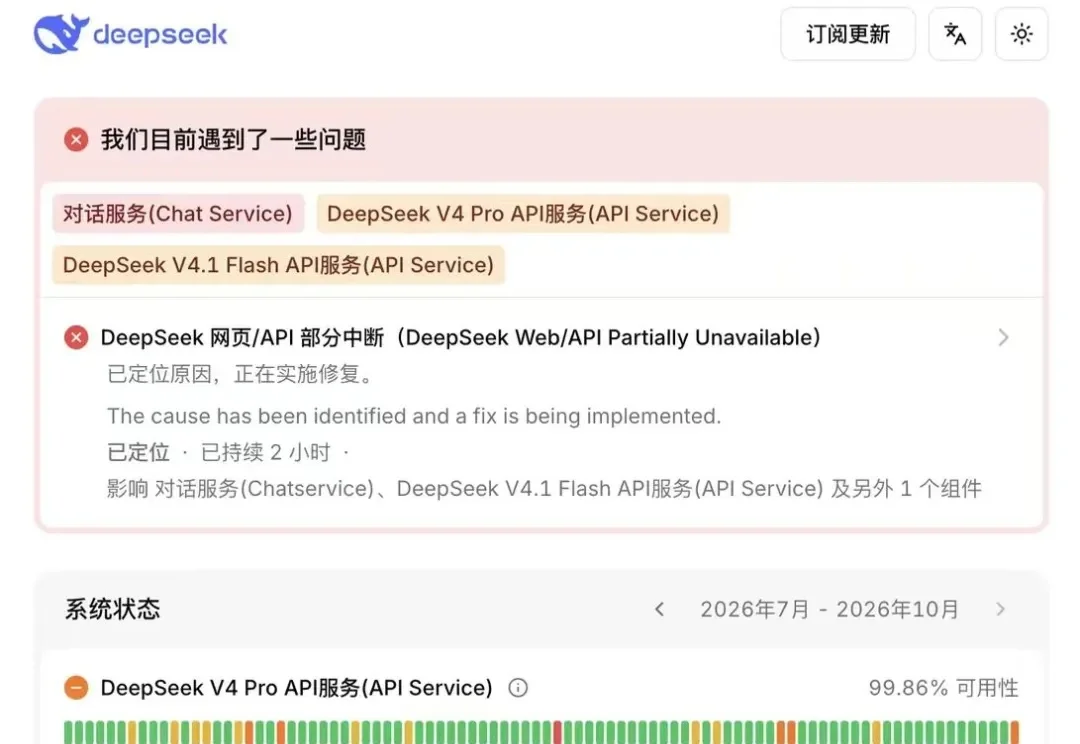
宕机数小时,DeepSeek给补钱了!

宕机数小时,DeepSeek给补钱了!

宕机数小时,DeepSeek给补钱了!

补偿款来了,DeepSeek 发 Token 了。

来自主题: AI资讯
6138 点击    2026-10-16 10:54
OpenAI揭秘万级Agent实测!狂飙36小时,狂吞1万亿Token

OpenAI揭秘万级Agent实测!狂飙36小时,狂吞1万亿Token

OpenAI揭秘万级Agent实测!狂飙36小时,狂吞1万亿Token

就在刚刚,OpenAI晒出了一份打破纪录的Agent极限实测。

来自主题: AI产品测评
8711 点击    2026-10-15 14:37
AI也能在分子空间里做推演:Scinetics提出可验证的科学推理链

AI也能在分子空间里做推演:Scinetics提出可验证的科学推理链

AI也能在分子空间里做推演:Scinetics提出可验证的科学推理链

模型的思维链,让AI学会了用文字一步步推理;但科学家的思考,还发生在分子的三维空间、基因序列和实验曲线里。
来自主题: AI技术研报
7748 点击    2026-10-15 13:58
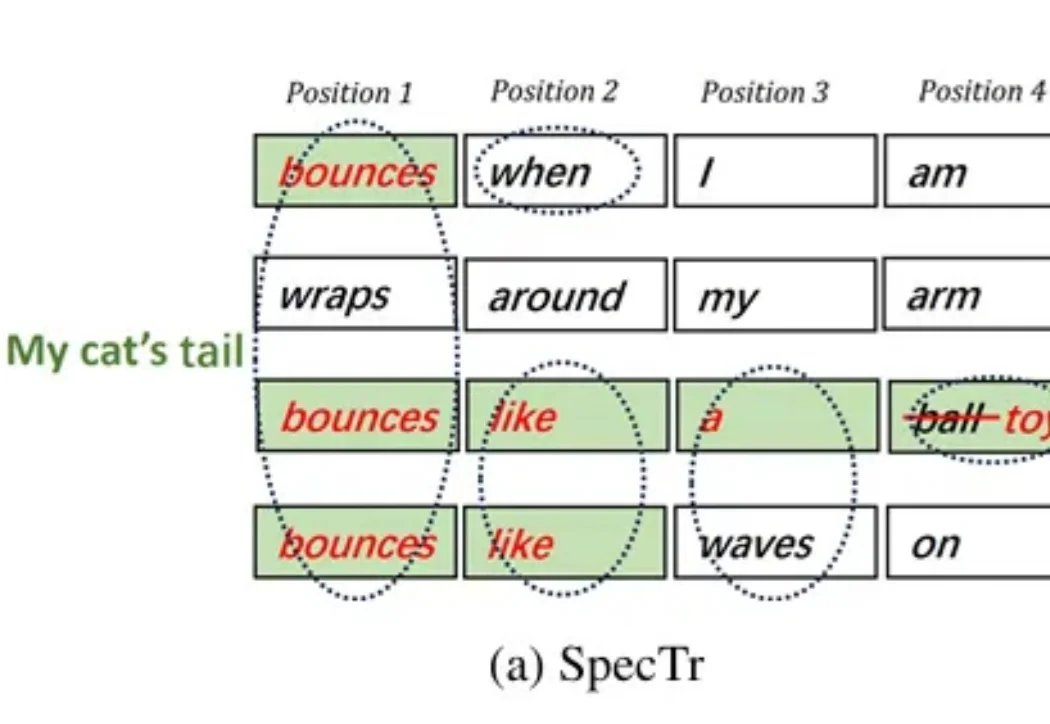
EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。

来自主题: AI技术研报
8527 点击    2026-10-15 13:56