告别资料散落,让知识持续积累:openJiuwen首发个人知识空间,重塑个人办公智能体新体验!
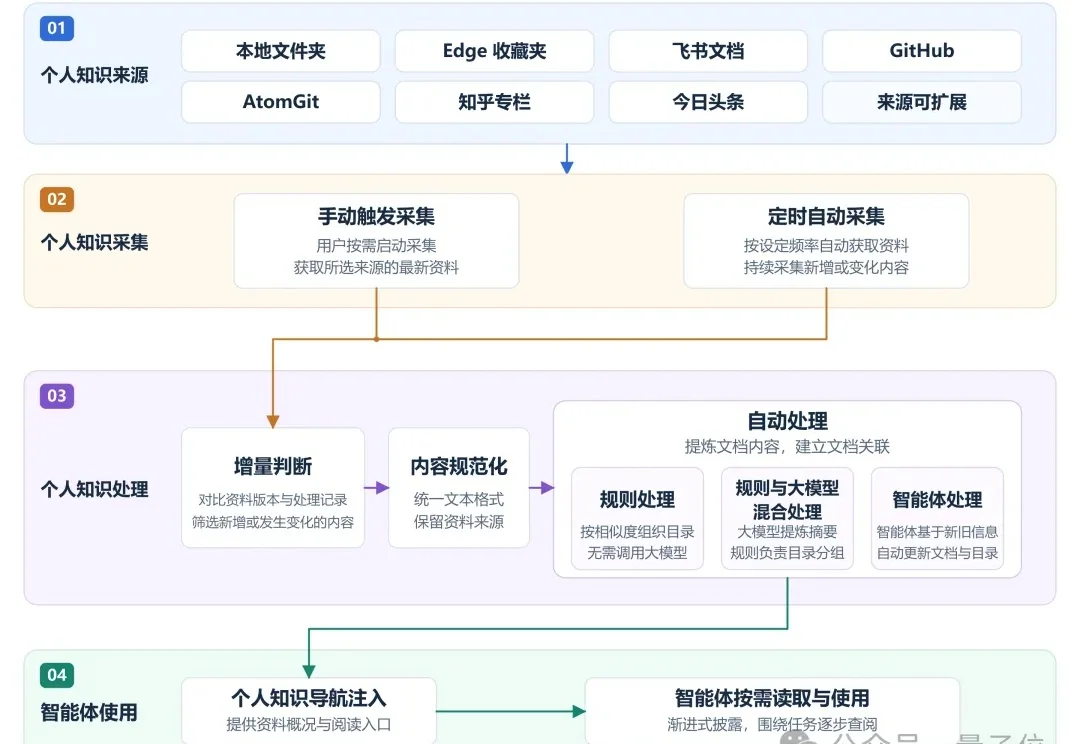
告别资料散落,让知识持续积累:openJiuwen首发个人知识空间,重塑个人办公智能体新体验!让Agent写周报、分析方案,已经是许多人的日常。但每次开始,用户还得翻找资料、交代背景,智能体也要经过查找、阅读、整理等多个步骤,才能真正开始任务。换个任务,这套流程又得重来。反复处理这些已有资料,既费时间,也增加token消耗。资料越多、步骤越长,还越容易遗漏信息或出现偏差,影响任务完成的准确率。
搜索
让Agent写周报、分析方案,已经是许多人的日常。但每次开始,用户还得翻找资料、交代背景,智能体也要经过查找、阅读、整理等多个步骤,才能真正开始任务。换个任务,这套流程又得重来。反复处理这些已有资料,既费时间,也增加token消耗。资料越多、步骤越长,还越容易遗漏信息或出现偏差,影响任务完成的准确率。
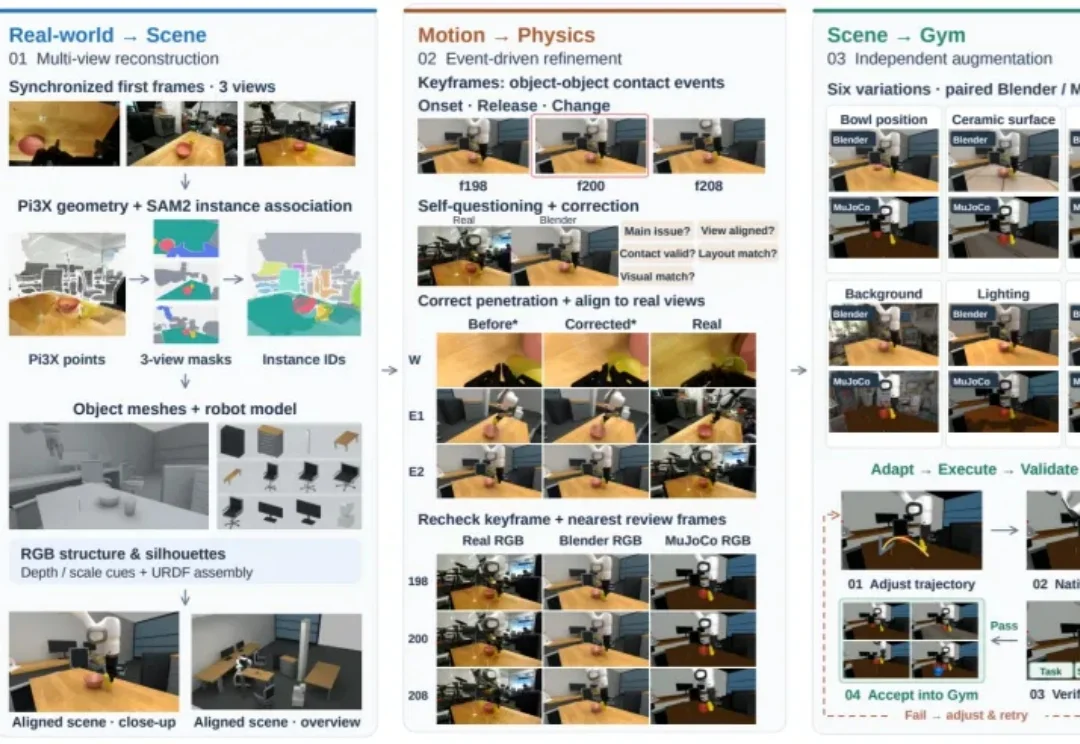
把杯子放进微波炉里,这一人类几乎不用思考的日常动作,机器人却可能在杯子放不稳、夹爪碰到门框这样的细节上频频出错。
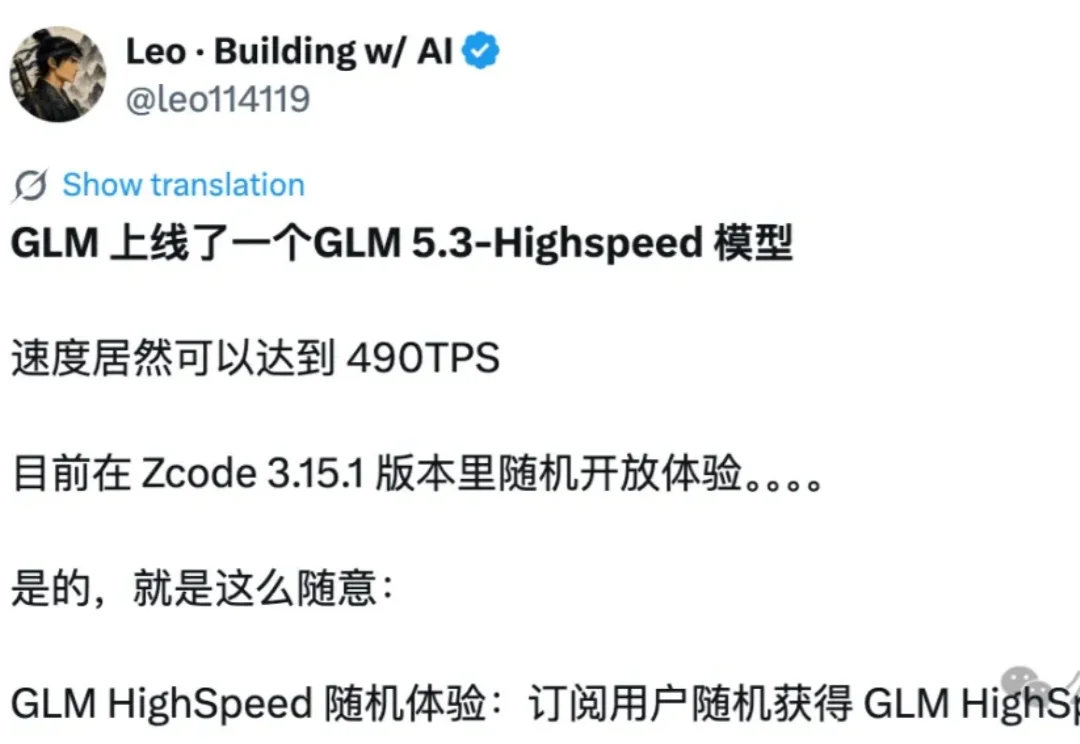
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。
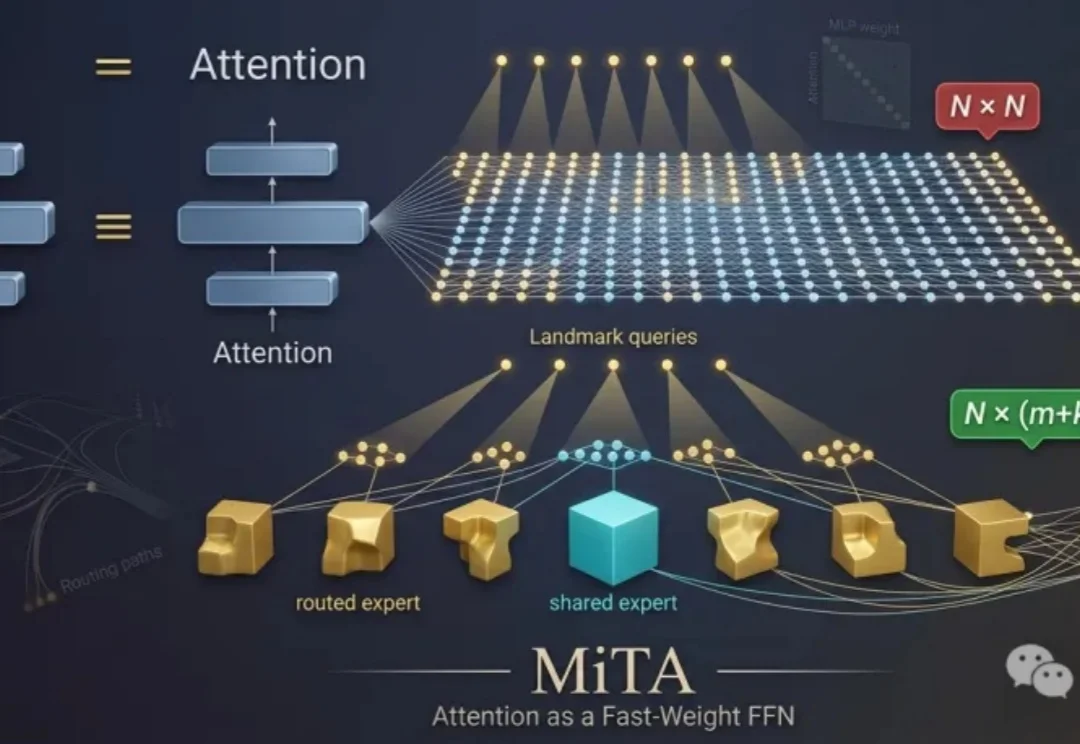
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
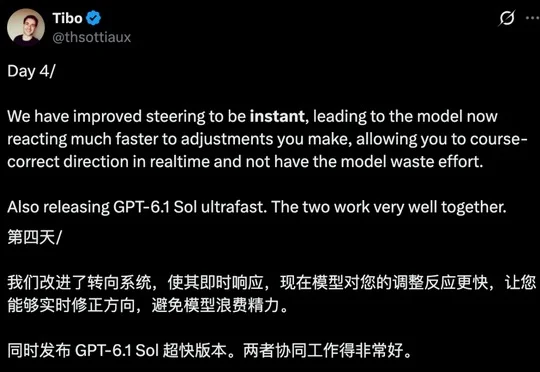
OpenAI推出GPT-6.1 Sol Ultrafast,智能水平接近Astra、最高速度为Sol标准版8倍,API定价为每百万输入token 12美元、输出60美元,Codex和ChatGPT Work仅向特定高阶用户开放。
A16Z第七版Top 100 消费级 AI 应用与9月底更新的市场状况 II显示,美国消费者虽已广泛尝试AI,但日常使用和付费渗透仍浅,智能降价正放大Agent的Token需求,重度用户与大众之间的AI使用鸿沟扩大,资本也重新流向芯片、能源和数据中心等实体基础设施。
在Anthropic冲刺IPO之际,Meta将Claude Code活跃用户从6万降至3万并转向Muse Code,微软也将内部Claude支出削减逾33%,单员工月度Token预算从10万美元降至1万美元。
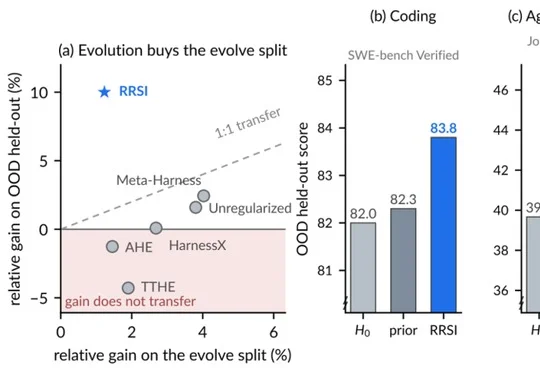
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
Ateve 团队发布 AI 决策模型 Ateve Jev,首个版本 ateve-jev-v1 支持候选选择、是非判断和等级评分,并上线 TokenDance 平台。
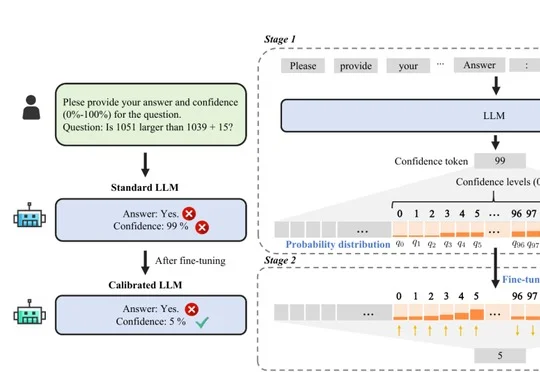
TypeSafe AI推出的Jev模型因直接输出决策与概率火爆出圈,其技术思路与NeurIPS 2025入选论文ConfTuner高度一致,后者通过Tokenized Brier Score直接训练候选置信度概率分布以实现概率校准。