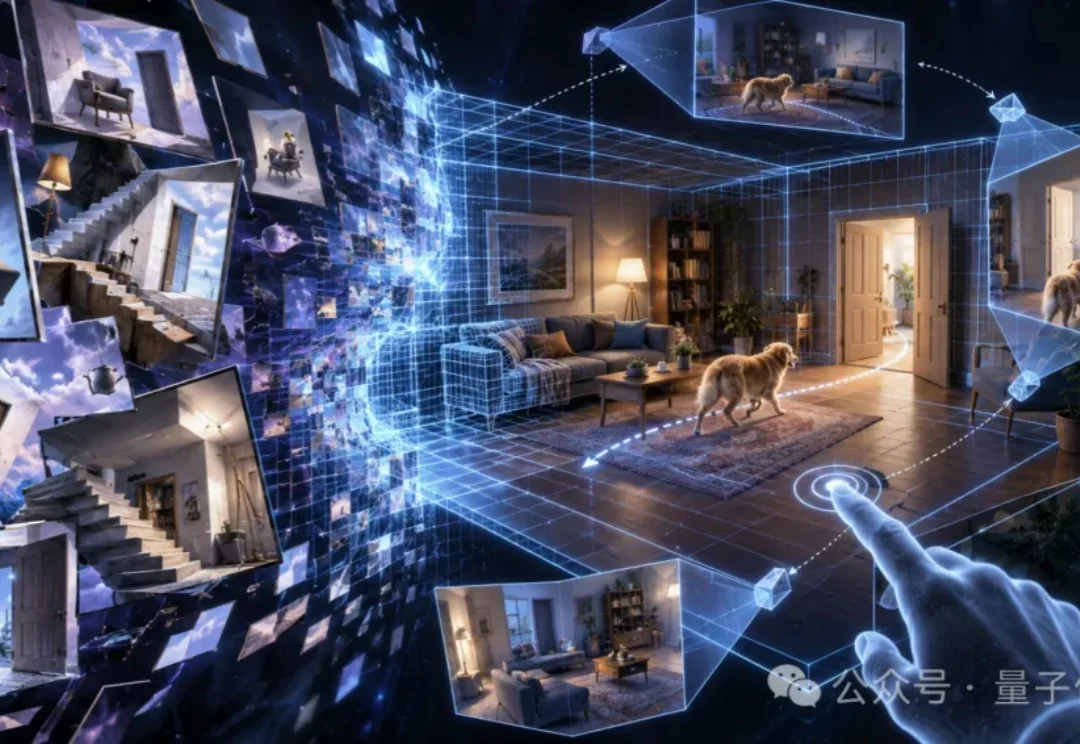
AI从「造图」卷到「造世界」,这次真有点科幻了。。。
AI从「造图」卷到「造世界」,这次真有点科幻了。。。好家伙,字节这回直接把AI生成玩成开放世界了?!
来自主题: AI资讯
10441 点击 2026-10-13 14:08

 搜索
好家伙,字节这回直接把AI生成玩成开放世界了?!
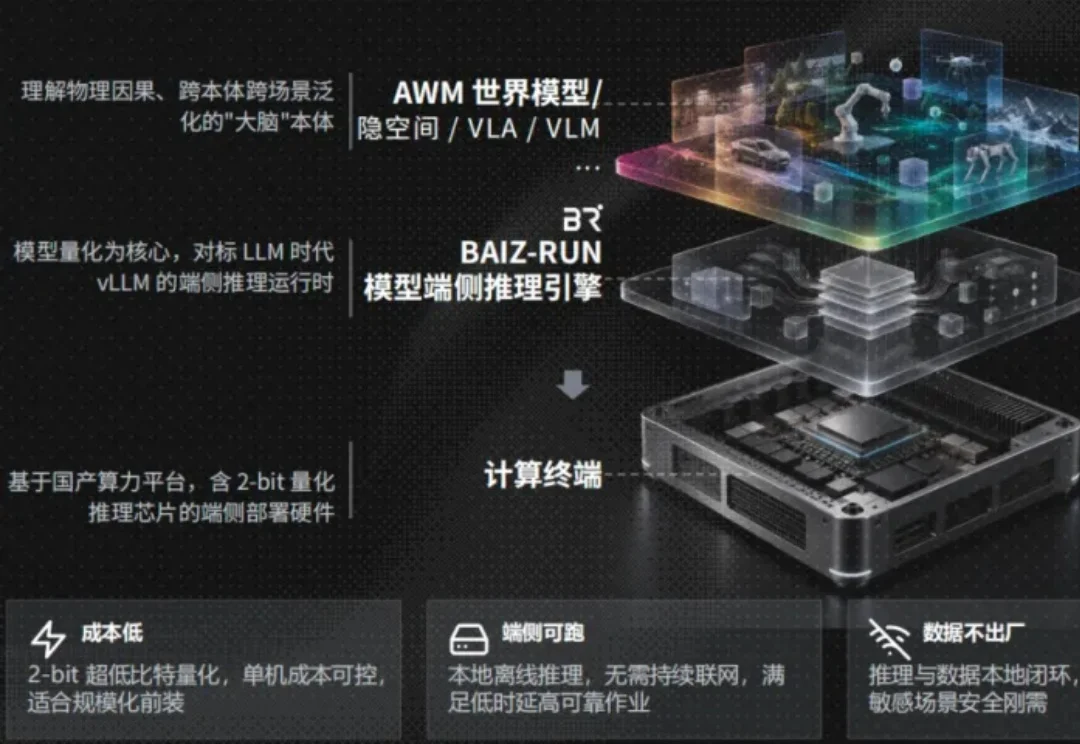
想象你站在一条产线旁边。
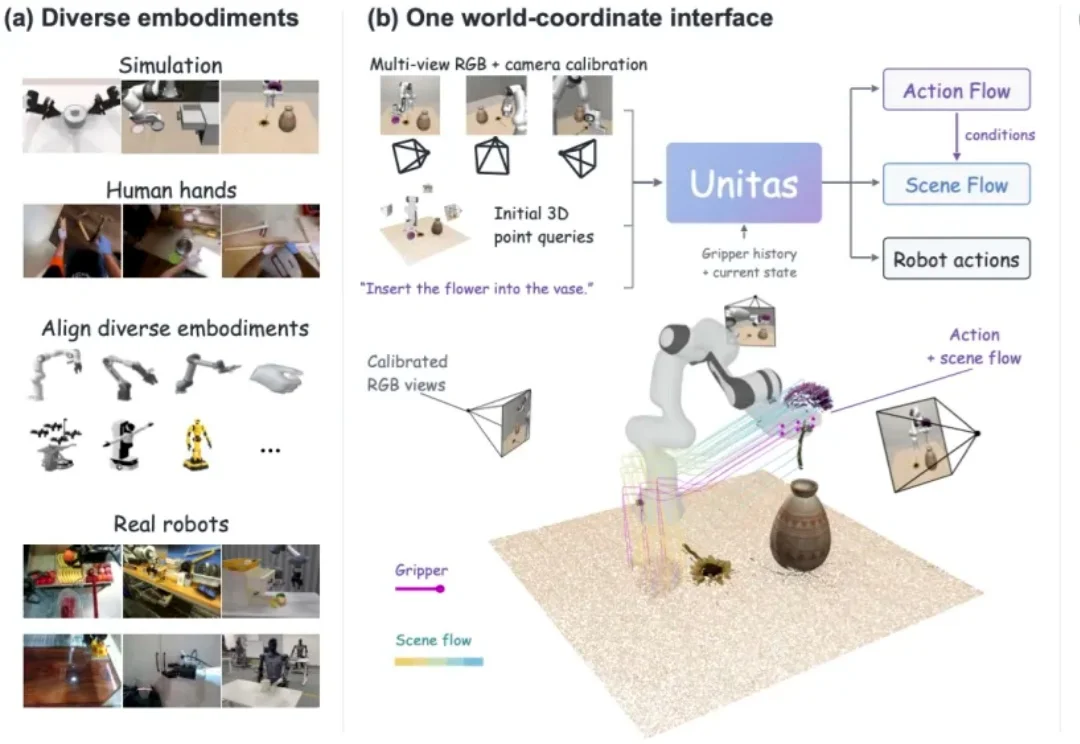
大语言模型为什么能 scale?一个重要基础是,海量来源各异的知识,被统一进了同一种输入输出空间 —— 文本。输入是文本,输出也是文本,主干模型在这个统一空间中学习、组合与迁移知识。那么,具身智能要获得类似的泛化能力,通往 Physical AGI,它的 “原生统一空间” 是什么?
LeCun创办的AMI联合纽约大学、巴黎INRIA和布朗大学推出分层世界模型H-JEPA并开源代码及预训练权重,其在Visual AntMaze任务中以更少规划计算取得更高成功率。
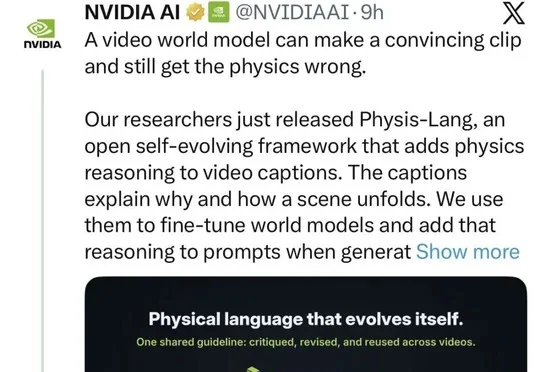
英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。
曾因在字节跳动实习期间篡改代码被判赔50万元的田柯宇,其10人团队获五源资本和IDG 3000万美元投资、估值2亿美元,拟以自回归符号世界模型挑战李飞飞的空间智能路线,并于2027年发布基座模型。
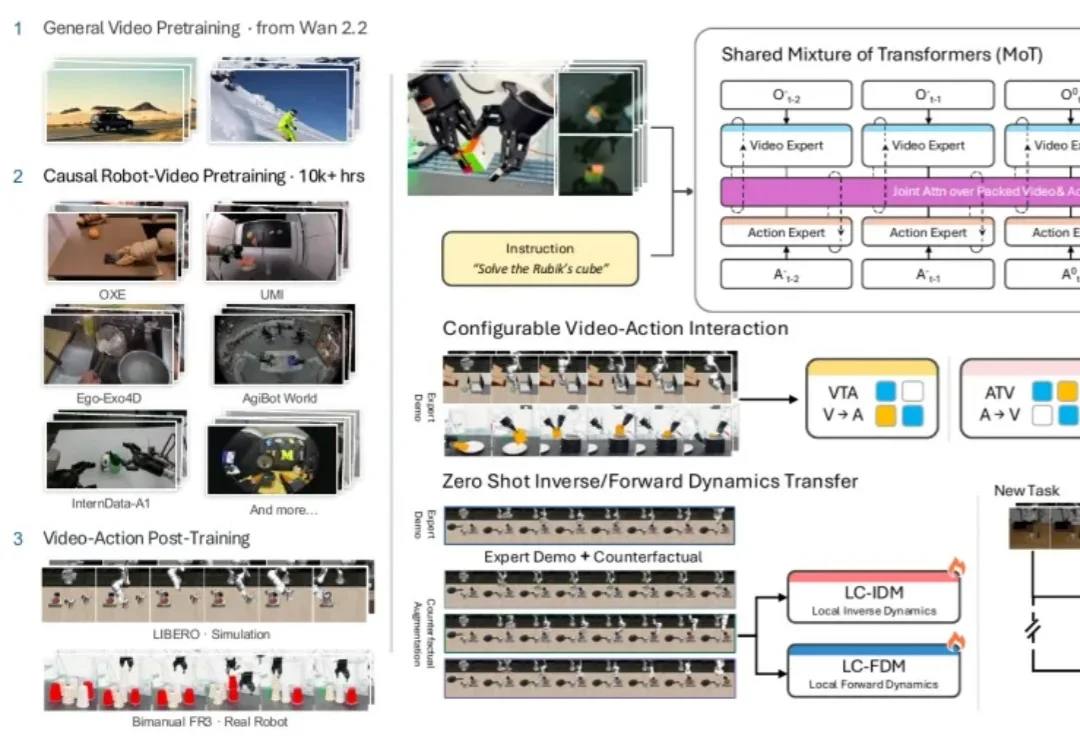
9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action。据其官方博客,该模型在英伟达 RoboLab-120 榜单上超过了此前最强的开源模型 Cosmos 3 Nano,参数量却不到后者一半。一家做图像生成的公司跑来卷机器人控制,说明视频模型里积累的「物理直觉」正被越来越多的团队当作机器人大脑的底座。
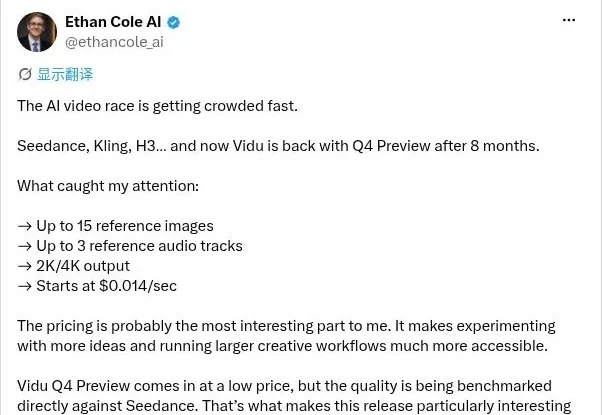
AI 视频生成正在进入新的竞争阶段。
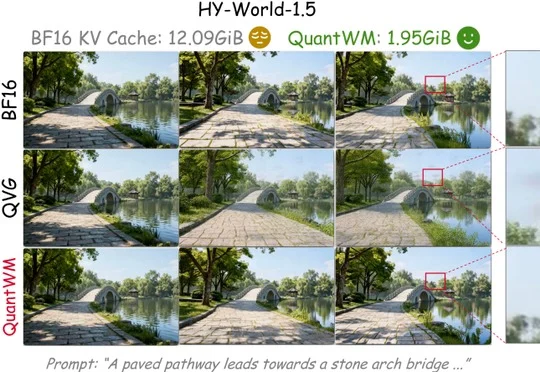
哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
AMD以约82亿美元股票收购李飞飞创办的World Labs后,作者认为交易更看重人才与模型理解而非成熟产品,并批评世界模型标签滥用及AI圈压制对低质产品的批评。