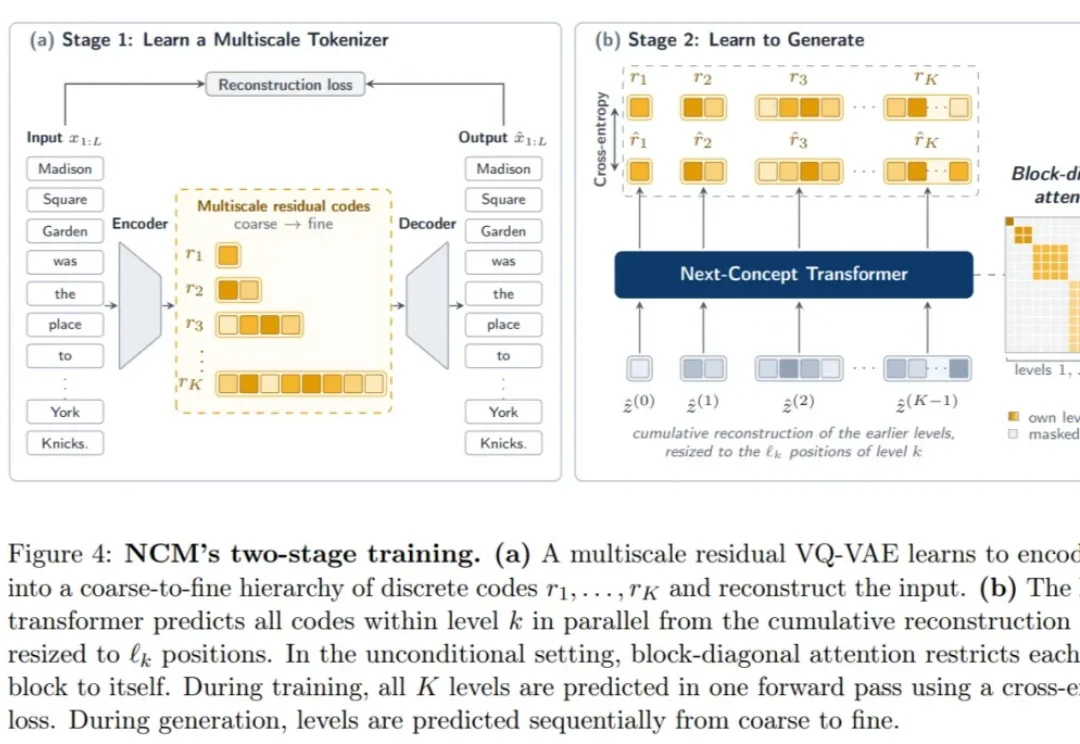
大模型下个范式:文本生成先写提纲,速度能快31倍
大模型下个范式:文本生成先写提纲,速度能快31倍如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
来自主题: AI技术研报
10079 点击 2026-10-16 11:27

 搜索
如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
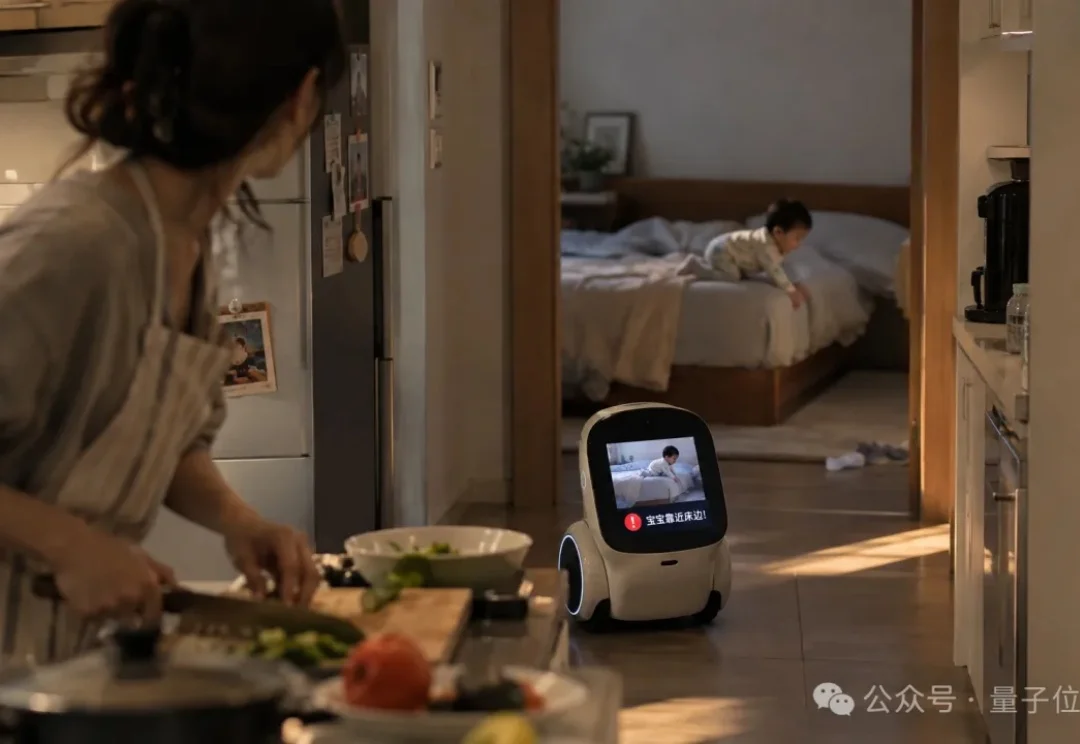
机器人开始替人操心了。
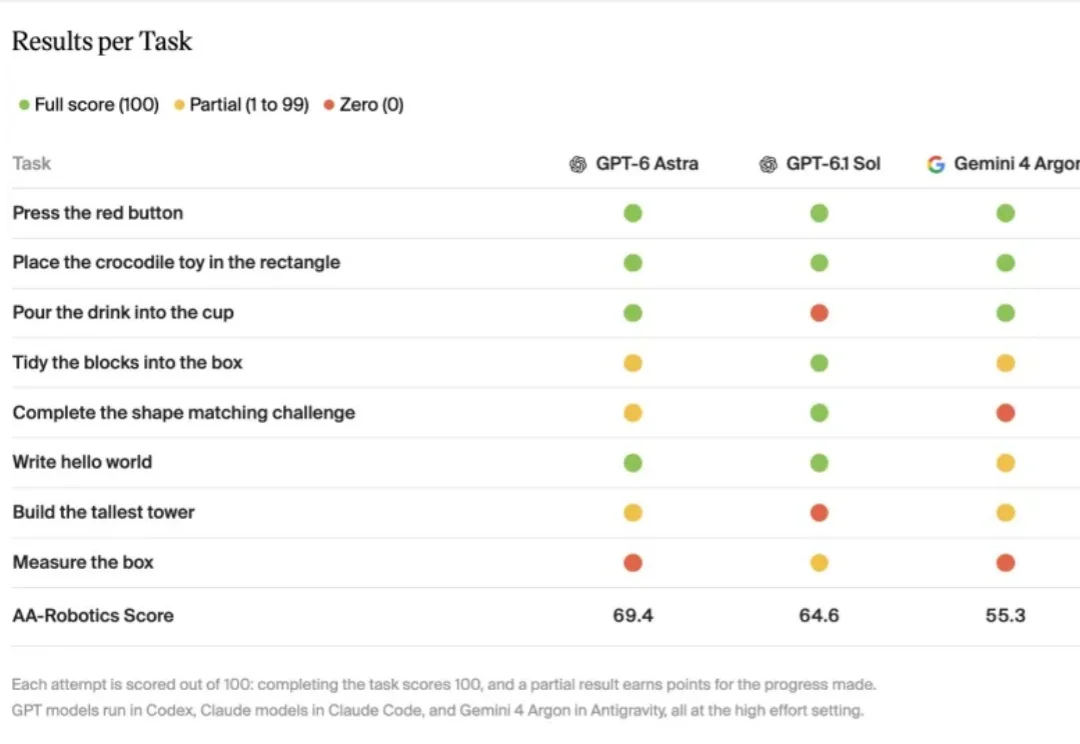
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
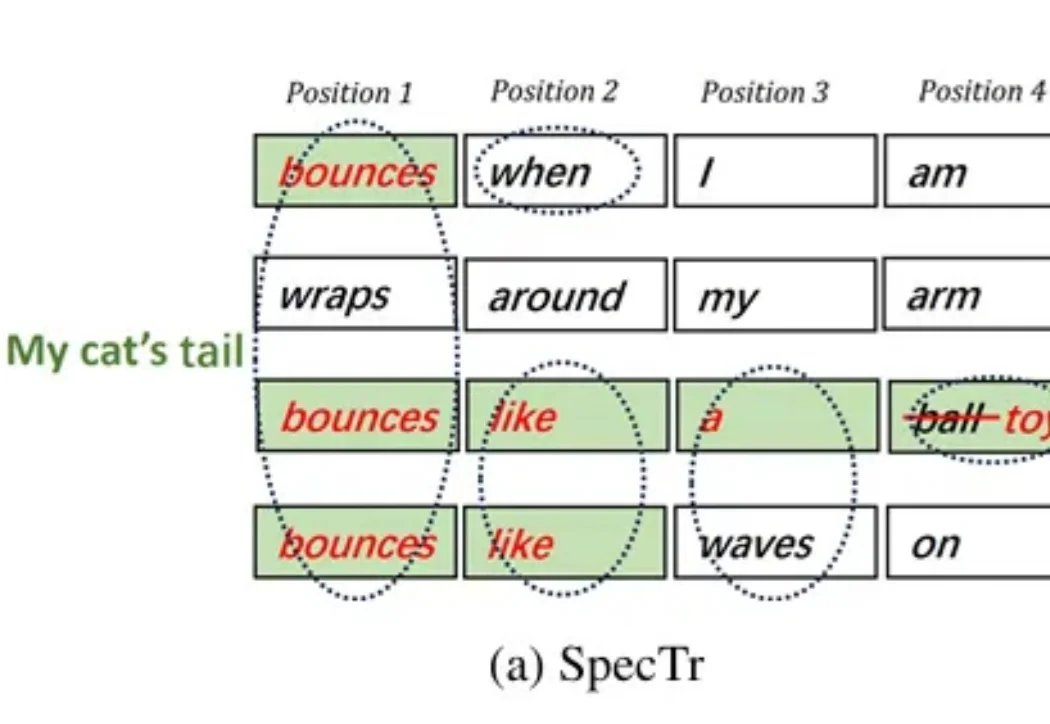
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
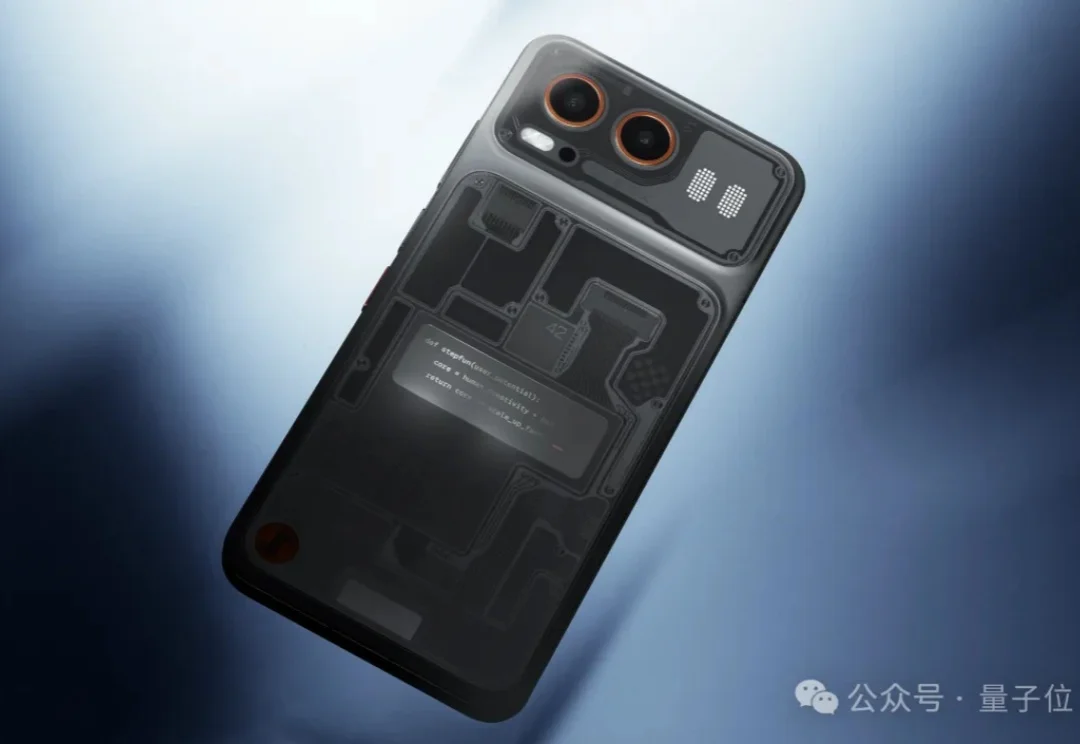
期待已久的阶跃终端大模型原生智能体手机STEPX Neo,终于正式亮相。
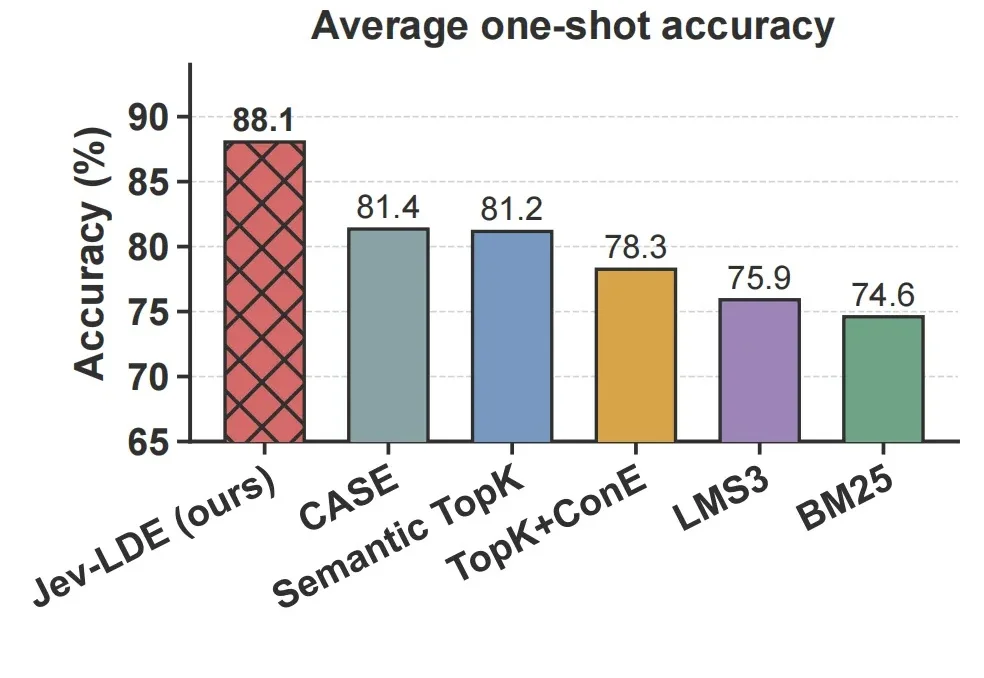
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
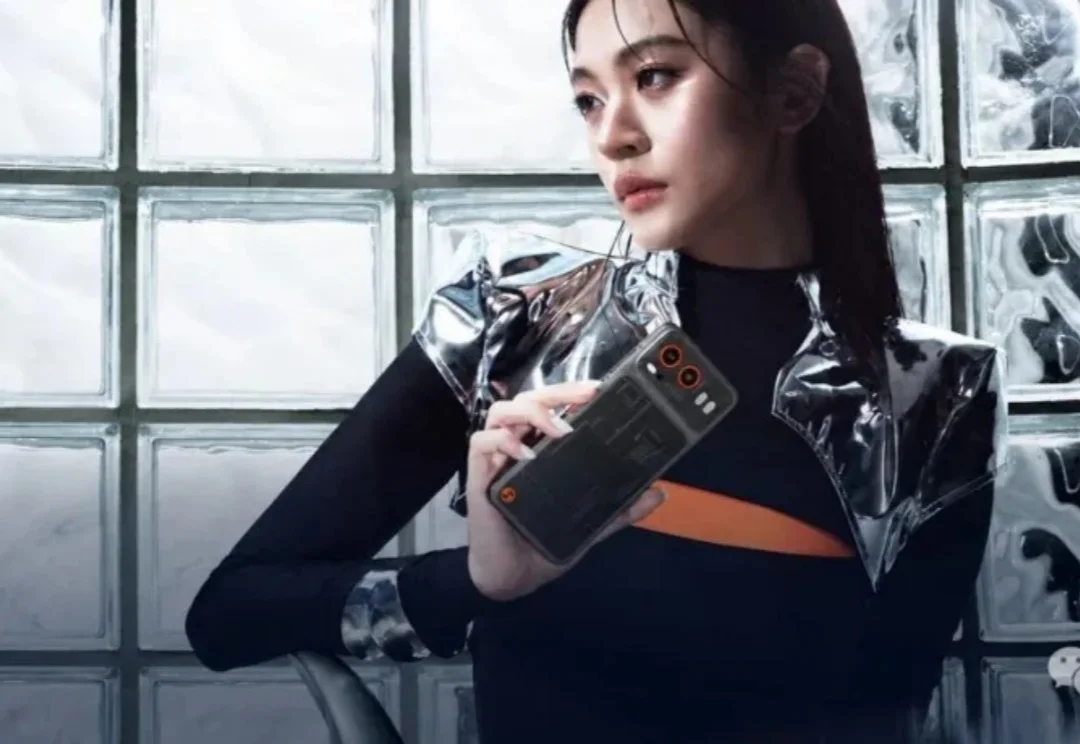
刚刚,上海。在一场叫「Ready Builder One」的发布会上—— STEPX Neo,全球首款大模型原生智能体手机,正式发布!
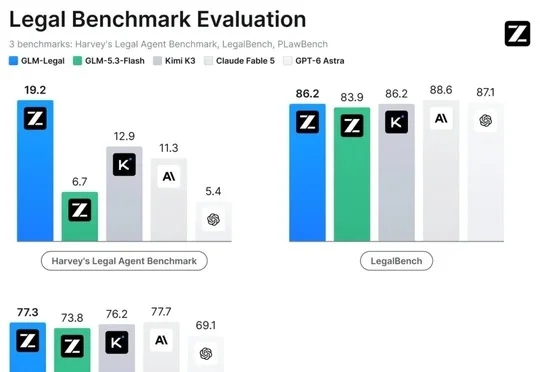
智谱旗下Z.ai发布基于GLM-5.3-Flash的法律专用模型GLM-Legal,面向合同审查、证据分析和合规研究,官方评测显示其在Harvey LAB明显领先、其余两项接近一线,目前需申请API权限且未开源。
就在今天深夜,Meta自豪宣布:自家的王炸大模型——Muse Wonder和Muse Wonder Full发布!
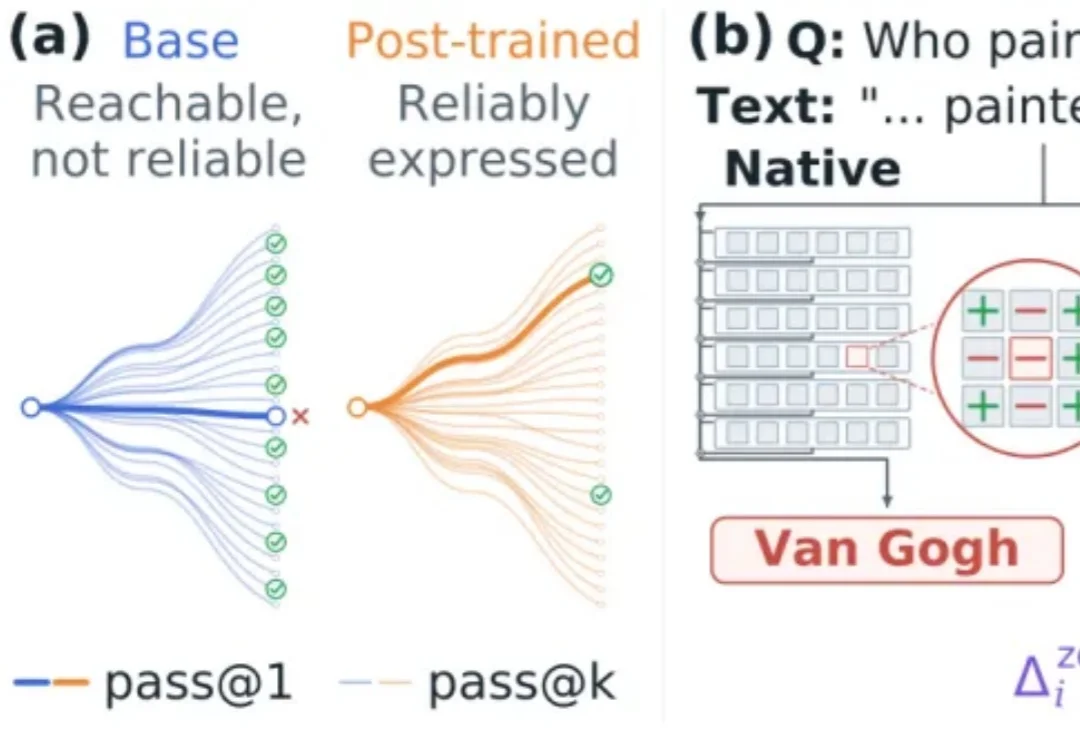
让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。