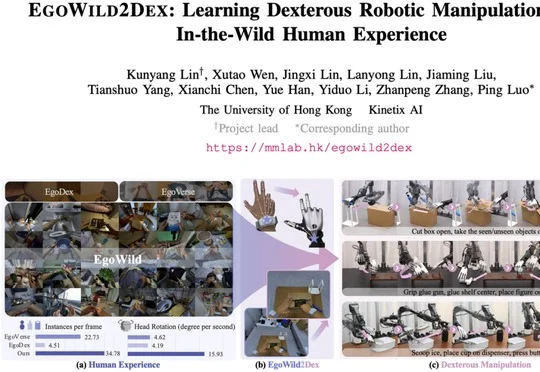
538小时「极脏」人类数据,真机不到1小时:港大让机器人学会拆快递、打胶枪、做冷饮
538小时「极脏」人类数据,真机不到1小时:港大让机器人学会拆快递、打胶枪、做冷饮香港大学MMLab团队提出EgoWild2Dex,利用538.9小时真实人类第一视角数据训练机器人,每个下游任务使用不到1小时真机数据微调,拆快递、用热熔胶枪固定摆件和制作冰饮等任务的平均成功率达96.7%。
来自主题: AI资讯
8186 点击 2026-10-18 13:05

 搜索
香港大学MMLab团队提出EgoWild2Dex,利用538.9小时真实人类第一视角数据训练机器人,每个下游任务使用不到1小时真机数据微调,拆快递、用热熔胶枪固定摆件和制作冰饮等任务的平均成功率达96.7%。
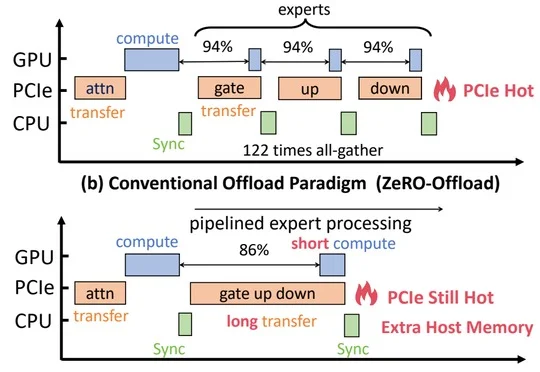
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
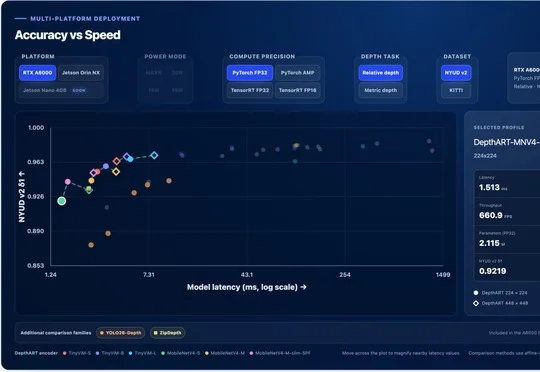
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
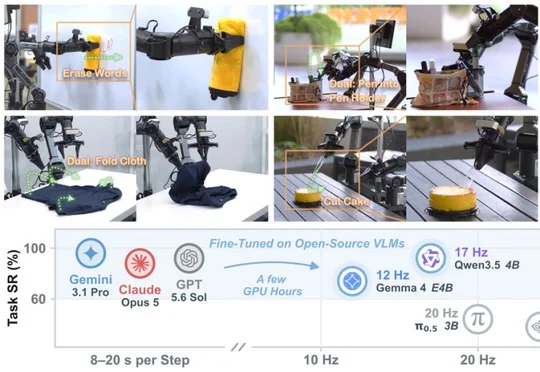
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
北京大学、清华大学与微软亚洲研究院在Nature Machine Intelligence发表研究,发现语言模型内部表征与人脑演绎推理脑区存在部分对齐,并可利用脑信号引导模型表征干预与参数微调,显著提升推理鲁棒性。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
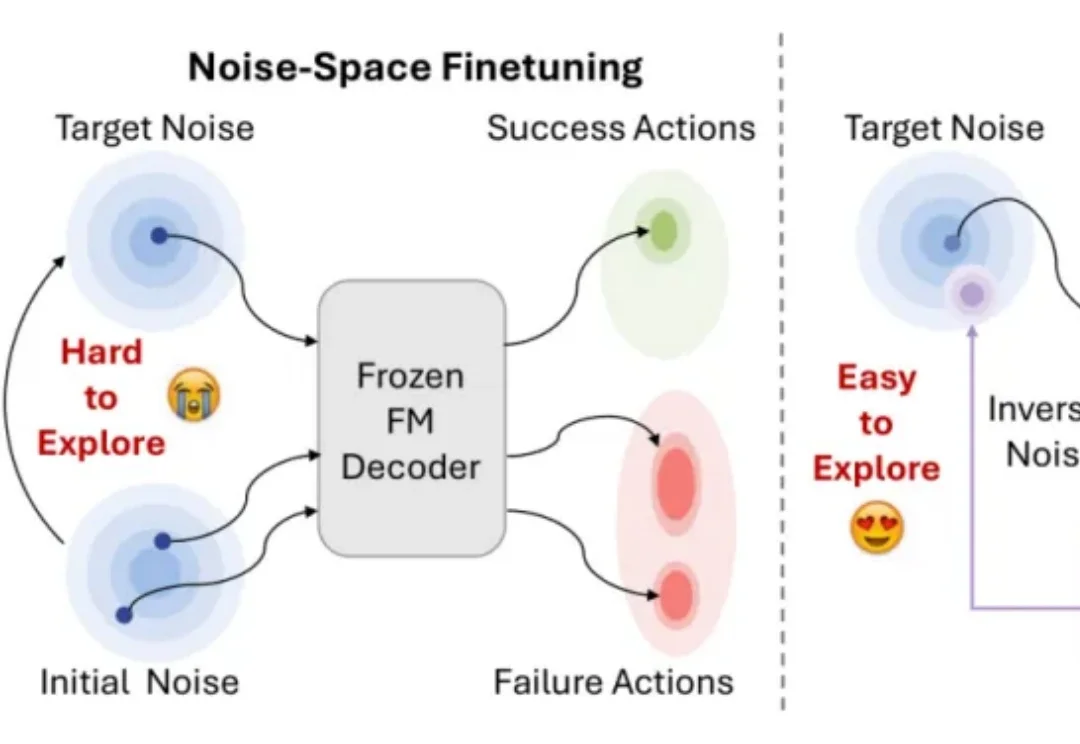
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
过去,LlamaFactory 让每个人都能微调大模型;现在,PenguinHarness 希望让每个人都能构建自进化 Agent。
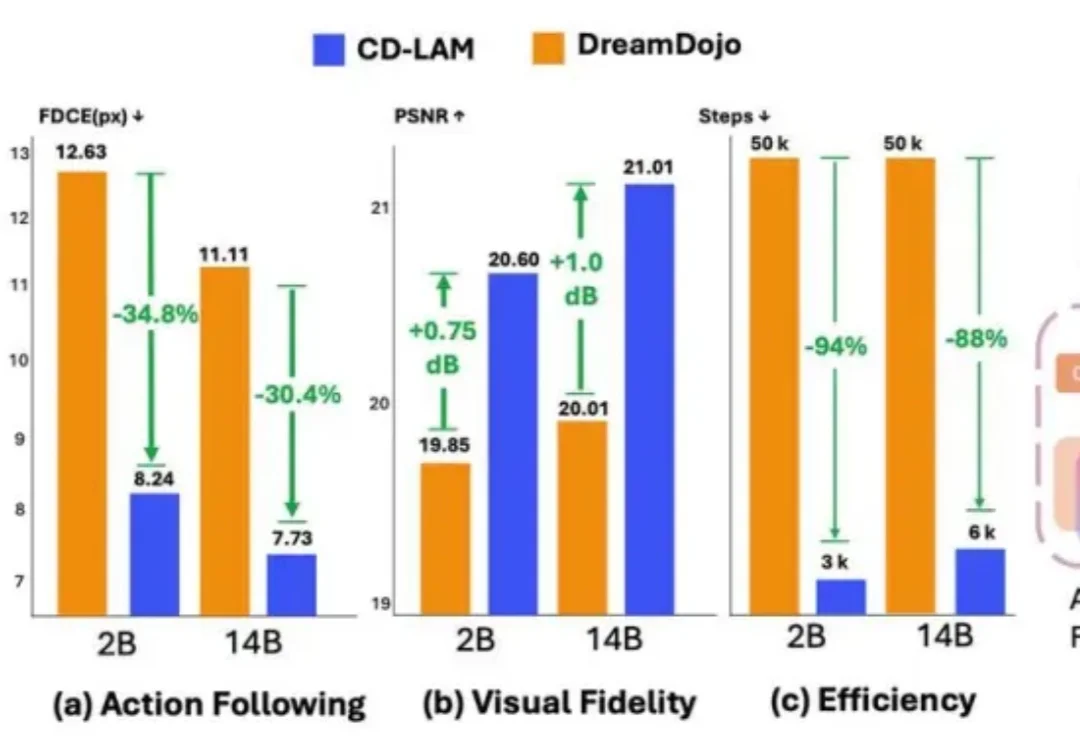
人类可以轻松想象一个还没做出的动作会带来什么:手一松,杯子会掉;往前一推,抽屉会合上。动作尚未发生,大脑已经预演了可能的结果。对机器人来说,具身世界模型(Embodied World Model)会根据当前观察和未来的动作,预测动作执行后的未来画面。